Come funziona DAVVERO l’indicizzazione in Magento 2 / Adobe Commerce
La maggior parte degli sviluppatori Magento 2 conosce questo comando:
bin/magento indexer:reindex
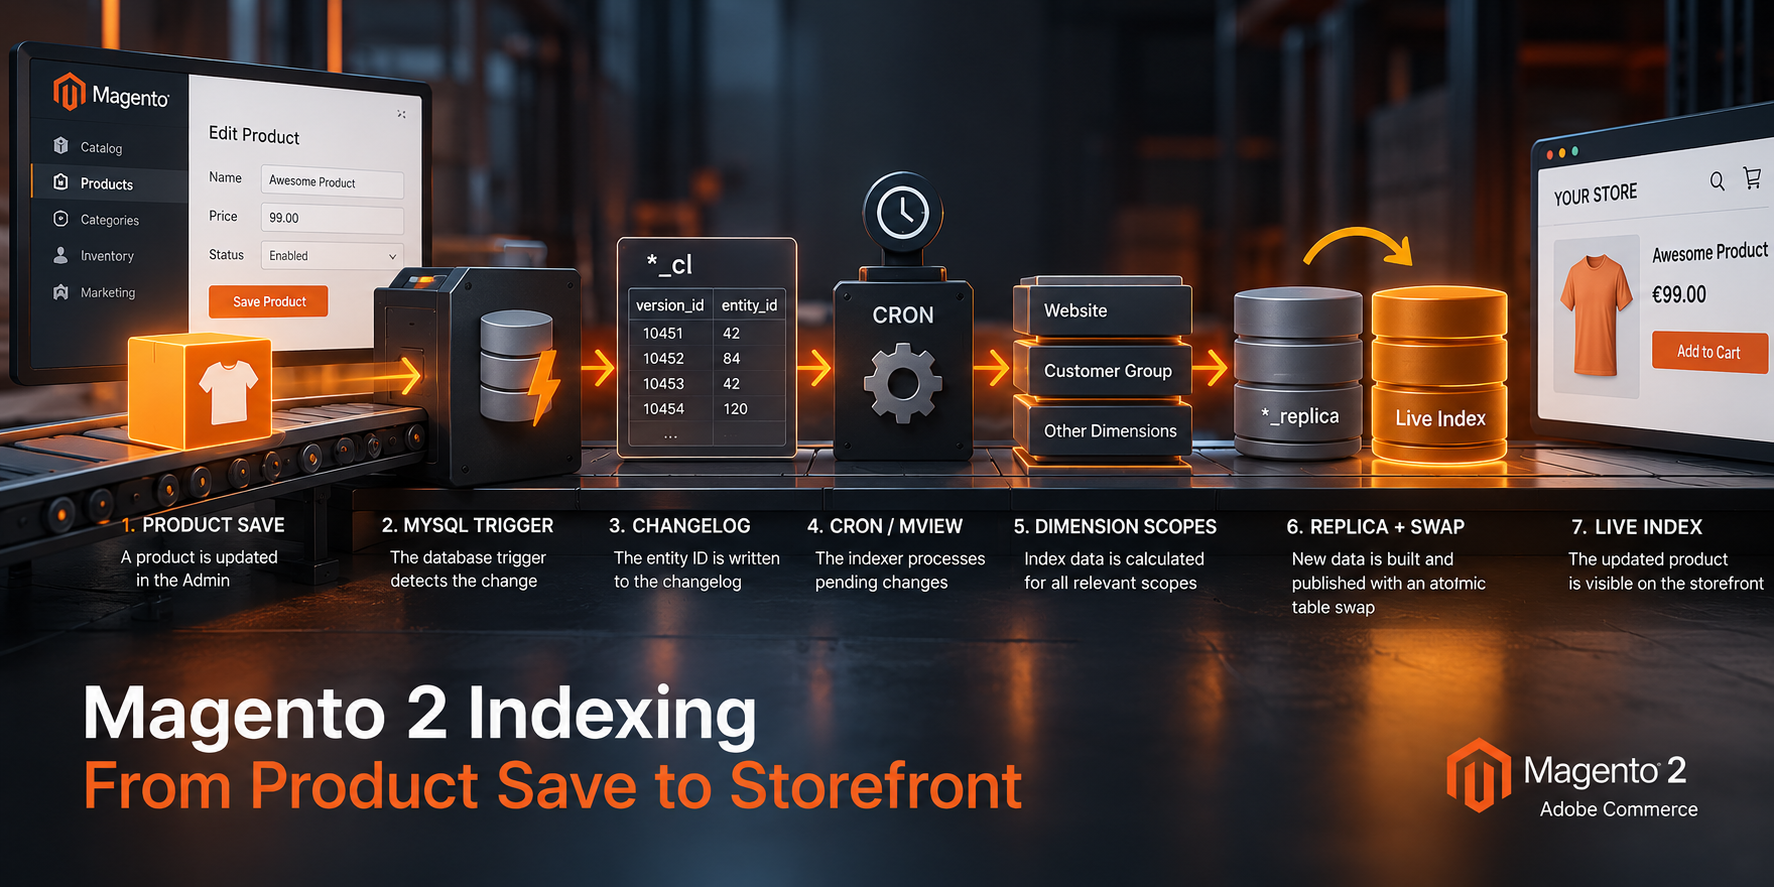
Ma cosa succede realmente tra la modifica di un prodotto nel pannello Admin e la visualizzazione del prezzo aggiornato, dell’associazione a una categoria o dei nuovi dati di ricerca sul frontend?
L’indicizzazione di Magento 2 / Adobe Commerce è molto più di un semplice comando che ricostruisce alcune tabelle del database.
Dietro alla modalità Update by Schedule esiste un’architettura basata su:
- rilevamento delle modifiche;
- trigger MySQL;
- tabelle di changelog;
- Materialized View (MView);
- elaborazione incrementale;
- stato degli indexer;
- elaborazione a batch;
- dimensioni e scope;
- e, per gli indexer che lo supportano, tabelle replica e table switching.
Comprendere questa architettura è estremamente utile quando bisogna diagnosticare problemi come:
- prodotti che mostrano prezzi non aggiornati;
- categorie che non si aggiornano;
- risultati di ricerca obsoleti;
- indexer apparentemente bloccati in stato
Processing; - tabelle
*_clche continuano a crescere; - processi cron che consumano CPU in modo anomalo;
- full reindex che richiedono ore;
- tabelle
*_tmpo replica rimaste dopo un reindex fallito.
L’architettura semplificata può essere rappresentata così:
                DATI SORGENTE
                     │
                     ▼
              Modifica prodotto
                     │
                     ▼
                Trigger MySQL
                     │
                     ▼
              Changelog *_cl
          version_id + entity_id
                     │
                     ▼
                 MView State
              ultimo version_id
                     │
                     ▼
             Cron / MView Update
                     │
                     ▼
           Indicizzazione incrementale
                     │
              ┌──────┴──────┐
              │             │
              ▼             ▼
         Dimensione A   Dimensione B
              │             │
              └──────┬──────┘
                     ▼
             Calcolo dell'indice
                     │
                     ▼
          Replica / dati temporanei
                dove previsto
                     │
                     ▼
              Table Switching
                dove previsto
                     │
                     ▼
                 INDICE LIVE
Il concetto più importante è che Magento separa tre responsabilità:
RILEVAMENTO MODIFICHE
          ↓
     ELABORAZIONE
          ↓
     PUBBLICAZIONE
Questa separazione è uno dei motivi per cui Magento può gestire cataloghi molto grandi senza dover ricalcolare tutti i dati derivati in maniera sincrona ogni volta che un amministratore salva un prodotto.
1. Perché Magento ha bisogno degli indici
Magento memorizza le informazioni del catalogo in una struttura fortemente normalizzata.
Il prezzo di un prodotto visualizzato sul frontend, ad esempio, può dipendere da:
- prezzo base;
- prezzo speciale;
- website;
- customer group;
- tier price;
- regole prezzo catalogo;
- tipo di prodotto;
- configurazione fiscale;
- relazioni dei prodotti configurabili;
- prezzi dei bundle;
- altre regole di business.
Calcolare dinamicamente tutto questo per ogni prodotto e per ogni richiesta frontend sarebbe estremamente costoso.
Magento trasforma quindi i dati sorgente in strutture ottimizzate per la lettura.
Concettualmente:
DATI DI BUSINESS NORMALIZZATI
             │
             │ calcoli costosi
             ▼
        TABELLE INDICE
             │
             │ letture ottimizzate
             ▼
          FRONTEND
Adobe definisce i dati originali come dictionary e la rappresentazione derivata come index.
La proprietà fondamentale di un indice è quindi:
Un indice è un dato derivato e, in linea di principio, ricostruibile.
Magento dovrebbe sempre essere in grado di rigenerare un indice partendo dai dati sorgente.
Questa distinzione è estremamente importante durante il troubleshooting.
Le tabelle contenenti le entità del catalogo rappresentano dati di business.
Le tabelle degli indici contengono dati derivati.
Le tabelle changelog e MView contengono invece le informazioni necessarie a mantenere sincronizzati i dati derivati con i dati sorgente.
Non vanno quindi considerate equivalenti.
2. Full Reindex vs Partial Reindex
Magento supporta due modalità concettualmente molto diverse di indicizzazione.
Full reindex
Un full reindex ricostruisce completamente un indice.
Ad esempio:
bin/magento indexer:reindex catalog_product_price
Concettualmente:
TUTTI I PRODOTTI
       │
       ▼
CALCOLO DEI PREZZI
       │
       ▼
INDICE PREZZI COMPLETO
Su cataloghi molto grandi questa operazione può essere estremamente costosa.
Se un ecommerce contiene centinaia di migliaia o milioni di SKU, sarebbe chiaramente inefficiente ricalcolare l’intero indice perché è cambiato un solo prodotto.
Per questo Magento supporta anche l’indicizzazione parziale.
Partial reindex
L’indicizzazione parziale elabora soltanto le entità interessate da una modifica.
Concettualmente:
Prodotto #42 modificato
          │
          ▼
    Changelog: 42
          │
          ▼
L'indexer elabora 42
          │
          ▼
    Indice aggiornato
È qui che entra in gioco l’architettura MView di Magento.
3. Update on Save vs Update by Schedule
Gli indexer Magento possono generalmente funzionare in due modalità:
Update on Save
oppure:
Update by Schedule
La configurazione attuale può essere verificata con:
bin/magento indexer:show-mode
e modificata con:
bin/magento indexer:set-mode schedule catalog_product_price
oppure:
bin/magento indexer:set-mode realtime catalog_product_price
Update on Save
Con Update on Save, l’attività di indicizzazione viene attivata in seguito alla modifica dei dati applicativi.
Questo permette di rendere rapidamente disponibili le modifiche nell’indice, ma sposta una parte maggiore del carico computazionale verso le operazioni di scrittura.
Su installazioni molto trafficate può aumentare:
- latenza dei salvataggi;
- lock contention;
- indicizzazioni concorrenti;
- carico sul database;
- probabilità di deadlock.
Update by Schedule
Con Update by Schedule, Magento registra ciò che è cambiato e lascia al cron il compito di elaborare le modifiche in maniera asincrona.
Concettualmente:
RICHIESTA HTTP
      │
      ▼
SALVATAGGIO PRODOTTO
      │
      ▼
REGISTRA MODIFICA
      │
      └────────────► FINE RICHIESTA

Successivamente...

CRON
 │
 ▼
LEGGE LE MODIFICHE
 │
 ▼
AGGIORNA L'INDICE
Negli ambienti di produzione l’indicizzazione schedulata è generalmente l’architettura preferibile.
Le linee guida Adobe sulle performance raccomandano infatti l’indicizzazione schedulata perché separa le scritture sul catalogo dalle operazioni potenzialmente costose di indicizzazione.
4. MView: l’astrazione Materialized View di Magento
Magento chiama il proprio sistema di change tracking MView, abbreviazione di Materialized View.
MySQL non offre lo stesso meccanismo nativo di materialized view disponibile in alcuni altri database, quindi Magento implementa una propria astrazione.
Il componente framework responsabile è:
Magento\Framework\Mview
Un modulo definisce le tabelle da monitorare all’interno di:
etc/mview.xml
Un esempio semplificato può essere:
<view
    id="catalog_category_product"
    class="Magento\Catalog\Model\Indexer\Category\Product"
    group="indexer">

    <subscriptions>

        <table
            name="catalog_category_entity"
            entity_column="entity_id"
        />

        <table
            name="catalog_category_entity_int"
            entity_column="entity_id"
        />

    </subscriptions>

</view>
La configurazione dice sostanzialmente a Magento:
Monitora queste tabelle sorgente
            ↓
Quando vengono modificate
            ↓
Registra l'entità interessata
            ↓
Invia gli entity ID
            ↓
A questo indexer
Questo rappresenta il collegamento tra le modifiche al database e l’indicizzazione incrementale.
5. Trigger MySQL: rilevare le modifiche
Quando una subscription MView è attiva, Magento utilizza trigger database per rilevare le modifiche alle tabelle sottoscritte.
A seconda della subscription, i trigger possono reagire a operazioni quali:
INSERT
UPDATE
DELETE
Il punto fondamentale è che il trigger non esegue normalmente il calcolo costoso dell’indice.
Il suo compito è molto più semplice:
MODIFICA DATI
     │
     ▼
TRIGGER MYSQL
     │
     ▼
REGISTRA ENTITY ID
Questo è fondamentale per le performance.
Immaginiamo di modificare il prezzo di un prodotto.
Una cattiva architettura potrebbe fare:
UPDATE PRODOTTO
      ↓
Calcolo prezzi per customer group
      ↓
Calcolo website
      ↓
Calcolo regole
      ↓
Aggiornamento tabelle indice
      ↓
Risposta HTTP
L’architettura schedulata di Magento mira invece a fare:
UPDATE PRODOTTO
      ↓
INSERT ID NEL CHANGELOG
      ↓
RISPOSTA
Il lavoro costoso viene eseguito successivamente e in maniera asincrona.
6. Le tabelle changelog *_cl
Le modifiche rilevate da MView vengono memorizzate in tabelle di changelog.
I loro nomi generalmente terminano con:
_cl
Una tabella changelog concettuale potrebbe essere:
catalog_product_price_cl

+------------+-----------+
| version_id | entity_id |
+------------+-----------+
| 10451      | 42        |
| 10452      | 84        |
| 10453      | 42        |
| 10454      | 120       |
+------------+-----------+
Le colonne più importanti sono:
version_id
entity_id
entity_id
Identifica l’entità interessata dalla modifica.
Ad esempio:
42
può rappresentare il prodotto con ID 42.
version_id
version_id fornisce una sequenza ordinata delle entry del changelog.
Concettualmente si comporta in modo simile all’offset di uno stream di eventi:
10451
10452
10453
10454
...
Questo permette a Magento di determinare:
Quali modifiche sono già state elaborate dall’indexer?
È uno dei concetti chiave dell’indicizzazione incrementale.
7. mview_state: il cursore del consumer
Magento deve ricordare fino a quale punto ogni MView ha elaborato il proprio changelog.
Questa informazione viene memorizzata nella tabella:
mview_state
Concettualmente:
+-----------------------+--------+------------+
| view_id               | status | version_id |
+-----------------------+--------+------------+
| catalog_product_price | idle   | 10452      |
+-----------------------+--------+------------+
Il valore più interessante è:
version_id
che rappresenta la posizione già elaborata dalla view.
Possiamo considerarlo come un consumer cursor.
Supponiamo che:
mview_state.version_id = 10452
mentre:
MAX(catalog_product_price_cl.version_id) = 10520
Magento sa che esistono ancora modifiche non elaborate.
Concettualmente:
10452                         10520
  │                             │
  ▼                             ▼
ULTIMO ELABORATO           ULTIMA MODIFICA

  |-----------------------------|
             INDEXER LAG
8. Come funziona l’elaborazione incrementale
L’SQL esatto e la gestione dei batch sono dettagli implementativi che possono variare, ma concettualmente il consumer MView esegue qualcosa di equivalente a:
SELECT DISTINCT entity_id
FROM catalog_product_price_cl
WHERE version_id > :last_processed_version
  AND version_id <= :current_upper_bound;
Supponiamo:
ultima versione elaborata = 1000
massimo attuale changelog  = 1100
L’indexer elabora:
1001 → 1100
Al termine dell’elaborazione, se tutto va a buon fine, il cursore può avanzare.
mview_state.version_id

1000
  ↓
1100
Il modello ricorda molto:
Producer
   ↓
Log ordinato
   ↓
Consumer
   ↓
Consumer Offset
Questa analogia è particolarmente utile per comprendere MView.
9. Perché è importante avere un limite superiore
Un problema interessante si presenta quando nuove modifiche al catalogo avvengono mentre l’indexer sta già lavorando.
Immaginiamo:
L'indexer parte

ultima versione = 1100
Durante l’elaborazione viene salvato un altro prodotto:
nuova versione = 1101
Magento deve evitare di includere continuamente nuove modifiche all’interno di un insieme di dati che cambia mentre lo sta elaborando.
Concettualmente lavora quindi su un intervallo delimitato:
ULTIMO CURSORE              LIMITE DEL BATCH
      │                           │
      ▼                           ▼
    1000 ----------------------- 1100

                                  1101
                                    │
                                    ▼
                              CICLO SUCCESSIVO
In questo modo il batch corrente è stabile.
Le modifiche arrivate dopo il limite vengono mantenute nel changelog e saranno elaborate nel ciclo MView successivo.
Questo contribuisce a rendere affidabile l’elaborazione asincrona incrementale.
10. Gli entity_id duplicati sono normali
Un prodotto può essere modificato più volte prima che l’indexer venga eseguito.
Ad esempio:
version_id    entity_id

2001          42
2002          42
2003          42
2004          73
Questo non significa necessariamente che Magento debba ricalcolare tre volte il prodotto 42.
L’informazione utile è generalmente:
42 è cambiato
73 è cambiato
per questo l’elaborazione può lavorare sull’insieme distinto degli identificativi.
Concettualmente:
CHANGELOG

42
42
42
73

 ↓ DISTINCT

42
73

 ↓

INDEXER
Questo spiega anche perché il numero di righe presenti nel changelog non deve essere automaticamente interpretato come il numero di prodotti in attesa di indicizzazione.
11. Magento elabora le modifiche a batch
Backlog molto grandi non possono essere caricati in memoria PHP tutti insieme in maniera sicura.
Immaginiamo un’integrazione che generi:
500.000 aggiornamenti prodotto
Elaborare ogni entità all’interno di un singolo array PHP potrebbe produrre:
elevato consumo memoria
         ↓
        OOM
         ↓
processo PHP terminato
         ↓
fallimento indexer
Magento supporta quindi l’elaborazione a batch.
Concettualmente:
CHANGELOG

1 ─────────────────── 500.000
        │
        ▼
      Batch 1
        │
        ▼
      Batch 2
        │
        ▼
      Batch 3
        │
        ▼
        ...
La dimensione dei batch diventa quindi un importante parametro di performance.
Batch troppo piccoli:
più query
più overhead
più transazioni
Batch troppo grandi:
più memoria
lock più lunghi
transazioni più grandi
rischio OOM
Trovare un buon equilibrio è particolarmente importante per:
- cataloghi molto grandi;
- importazioni ERP;
- sincronizzazioni PIM;
- feed marketplace;
- aggiornamenti massivi dei prezzi.
12. Dimensions: un prodotto non significa un solo valore indicizzato
Una delle parti più sottovalutate dell’indicizzazione Magento è l’indicizzazione dimensionale.
Alcuni valori derivati dipendono dal contesto.
Il prezzo di un prodotto, per esempio, può dipendere da:
Prodotto
   ×
Website
   ×
Customer Group
Concettualmente:
Prodotto 42

             Website A
            /         \
       Retail       Wholesale

             Website B
            /         \
       Retail       Wholesale
La modifica di un solo prodotto può quindi generare più record derivati nell’indice.
Questo spiega perché la complessità dell’indicizzazione non cresce necessariamente soltanto in funzione del:
numero di prodotti
ma può crescere più similmente a:
Prodotti
× Website
× Customer Group
× Altre dimensioni
a seconda dell’indexer.
Nelle installazioni B2B o multi-website di grandi dimensioni, questa differenza può diventare enorme.
13. Perché l’indicizzazione può esplodere nei Magento multi-website
Consideriamo un’installazione con:
500.000 prodotti
8 website
6 customer group
Un modello mentale semplicistico considera soltanto:
500.000 prodotti
Ma un calcolo dei prezzi sensibile alle dimensioni può coinvolgere uno spazio teorico molto più ampio:
500.000 × 8 × 6
ovvero:
24.000.000 di combinazioni
prodotto/website/customer-group
Questo non significa che Magento generi necessariamente e sempre esattamente 24 milioni di righe per ogni indexer.
Significa però che il numero di prodotti da solo non basta per stimare il costo dell’indicizzazione.
L’architettura conta.
Quando si analizza un problema di indicizzazione lenta, bisogna considerare sempre:
numero SKU
+
numero website
+
customer group
+
tipi di prodotto
+
catalog rule
+
architettura inventory
+
custom indexer
14. Tabelle replica e Table Switching
Alcuni indexer Magento utilizzano una strategia in cui i nuovi dati vengono preparati separatamente dalla tabella attualmente utilizzata dal frontend.
Concettualmente:
TABELLA LIVE
catalog_product_index_price

TABELLA REPLICA
catalog_product_index_price_replica
Il processo può quindi diventare:
Frontend
   │
   ▼
INDICE LIVE

Nel frattempo...

Dati sorgente
   │
   ▼
Indexer
   │
   ▼
REPLICA
Quando i nuovi dati sono pronti, Magento può eseguire uno switch tra le tabelle invece di sostituire progressivamente un grande insieme di dati live.
Concettualmente:
PRIMA

live     → DATI VECCHI
replica  → DATI NUOVI


SWITCH


DOPO

live     → DATI NUOVI
Il vantaggio è evidente.
Il frontend non deve assistere a un indice che viene ricostruito riga dopo riga.
La pubblicazione diventa invece un’operazione relativamente breve, dopo che la parte computazionalmente costosa è già stata eseguita.
Una precisazione importante
Replica table e table switching non sono passaggi universali implementati allo stesso modo da tutti gli indexer Magento.
I diversi indexer possono avere implementazioni differenti.
Di conseguenza, diagrammi come:
MView → Replica → Swap
sono utili come modello architetturale, ma non devono essere interpretati come se ogni indexer core o custom creasse necessariamente una tabella *_replica.
Per analizzare un indexer specifico è sempre opportuno verificarne direttamente l’implementazione.
15. Cosa sono le tabelle *_tmp?
Durante l’indicizzazione è possibile trovare tabelle con nomi contenenti:
_tmp
o altre convenzioni utilizzate per indicare tabelle temporanee o di staging.
Possono essere utilizzate per operazioni intermedie durante il processo di indicizzazione.
Questo porta talvolta a una pratica di troubleshooting molto pericolosa:
"Questa sembra una tabella temporanea.
Facciamo DROP."
Non fatelo.
Durante un’indicizzazione attiva:
DROP *_tmp
può interferire con il processo in esecuzione.
La tabella potrebbe essere necessaria per:
- calcoli intermedi;
- aggregazioni;
- table switching;
- scritture in staging;
- elaborazione a batch.
16. Quando possono essere eliminate le tabelle temporanee?
Un processo fallito può lasciare artefatti temporanei nel database.
Le cause tipiche includono:
PHP OOM
SIGKILL
restart del container
riavvio del server
interruzione del deployment
errore database
terminazione manuale del processo
Potremmo quindi trovare:
some_index_tmp
molto tempo dopo che il processo di indicizzazione sembra essersi concluso.
Prima di eliminare qualsiasi cosa è necessario verificare:
1. Nessun processo indexer è attivo
2. Il cron non sta elaborando quell'indice
3. Nessuna sessione DB sta usando la tabella
4. La tabella è realmente temporanea o abbandonata
5. L'indexer è in grado di ricrearla
6. Se necessario, è possibile eseguire successivamente un full reindex
Solo a questo punto può essere presa in considerazione una pulizia manuale.
17. Tabelle che NON dovresti eliminare con leggerezza
Due componenti particolarmente importanti sono:
*_cl
e:
mview_state
Non sono normali tabelle temporanee.
Fanno parte dell’infrastruttura di change tracking utilizzata dall’indicizzazione incrementale.
Concettualmente:
DATI SORGENTE
     │
     ▼
   *_cl
     │
     ▼
mview_state
     │
     ▼
   INDEXER
Rimuoverle o modificarle senza comprenderne le conseguenze può rompere la relazione tra:
ciò che è cambiato
e:
ciò che Magento ritiene
di aver già elaborato
Il risultato può essere molto più difficile da diagnosticare rispetto a una semplice tabella temporanea rimasta nel database.
18. indexer_state vs mview_state
Queste due tabelle vengono spesso confuse.
In realtà risolvono problemi differenti.
indexer_state
indexer_state descrive lo stato dell’indexer.
Gli stati concettualmente più importanti includono:
valid
invalid
working
Permette di rispondere a domande come:
Questo indice è considerato valido?
oppure:
Magento lo sta attualmente elaborando?
mview_state
mview_state descrive invece l’avanzamento del consumer della Materialized View.
Risponde alla domanda:
Fino a quale posizione del changelog questa MView è arrivata?
Concettualmente:
indexer_state
      │
      └── L'indice/indexer è valido o in esecuzione?


mview_state
      │
      └── Fino a dove abbiamo elaborato il changelog?
Durante il troubleshooting dell’indicizzazione schedulata, controllare soltanto indexer_state è quindi spesso insufficiente.
19. Misurare l’Indexer Lag
Una metrica operativa estremamente utile può essere ricavata confrontando il changelog con il cursore MView.
Supponiamo:
SELECT MAX(version_id)
FROM catalog_product_price_cl;
restituisca:
850000
mentre:
SELECT version_id
FROM mview_state
WHERE view_id = 'catalog_product_price';
restituisca:
845000
Il gap tra le versioni è:
850000 - 845000 = 5000
Concettualmente:
CURSORE MVIEW                     TESTA CHANGELOG

845000 ─────────────────────────── 850000
              5000 versioni
Questo valore può essere utilizzato come indicatore del fatto che il consumer stia iniziando a rimanere indietro.
Ma bisogna fare una precisazione importante.
Il version gap non equivale al numero di prodotti
Perché:
un singolo prodotto
può apparire più volte nel changelog.
Quindi:
version gap = 5000
non significa necessariamente:
5000 prodotti in attesa
Un sistema di monitoring più sofisticato dovrebbe misurare diversi indicatori:
version lag
numero di entity distinte in backlog
time lag
velocità di elaborazione
durata esecuzioni cron
Insieme, forniscono una visione molto migliore dello stato dell’indicizzazione.
20. Una strategia migliore per monitorare l’indicizzazione
Il monitoring di produzione dovrebbe idealmente rispondere alla domanda:
Quanto è indietro l'indexer?
e non soltanto:
L'ultimo cron ha avuto successo?
Metriche utili includono:
MAX(*_cl.version_id)
mview_state.version_id
COUNT(DISTINCT pending entity_id)
indexer_state.status
durata cron
throughput indicizzazione
età della modifica non elaborata più vecchia
Questo permette di generare alert prima che merchant o clienti inizino a vedere dati obsoleti.
Ad esempio:
NORMALE

Changelog head       105000
MView cursor         104995
Lag                        5


WARNING

Changelog head       205000
MView cursor         170000
Lag                    35000
Un gap che cresce continuamente è molto più significativo di un gap elevato ma temporaneo.
Se:
velocità produzione > velocità consumo
allora:
backlog → continua a crescere
Concettualmente l’indexer Magento è diventato un consumer sovraccarico.
21. Perché bin/magento indexer:reindex non è sempre la soluzione corretta
Una reazione molto comune quando Magento mostra dati non aggiornati è:
bin/magento indexer:reindex
A volte risolve il problema.
Ma potrebbe risolvere soltanto il sintomo.
Supponiamo che il vero problema sia:
cron non funzionante
oppure:
backlog MView
oppure:
custom indexer che impiega 20 minuti
oppure:
OOM durante l'elaborazione schedulata
Un full reindex manuale potrebbe temporaneamente ripristinare la correttezza dei dati.
Ma:
30 minuti dopo
il problema ricompare.
Una sequenza diagnostica migliore è:
bin/magento indexer:status

bin/magento indexer:show-mode

bin/magento cron:run
e successivamente analizzare:
cron_schedule
indexer_state
mview_state
*_cl
log applicativi
memoria PHP
attività database
L’obiettivo non deve essere semplicemente ricostruire l’indice.
Bisogna capire perché la sincronizzazione incrementale non riesce più a mantenere il passo.
22. Scenario comune: il consumer dell’indexer rimane indietro
Consideriamo un PIM che produce:
100.000 modifiche ogni 5 minuti
mentre l’indexer Magento riesce a processarne solamente:
60.000 ogni 5 minuti
Il sistema si comporta così:
Modifiche in ingresso
100k / 5 min
       │
       ▼
CHANGELOG
       │
       │ 60k / 5 min
       ▼
INDEXER
Ogni ciclo lascia quindi:
40.000
nuove modifiche in backlog.
Dopo un’ora:
40.000 × 12
=
480.000
modifiche possono essersi accumulate.
L’indexer non è necessariamente “rotto”.
Semplicemente non possiede abbastanza throughput.
Questa distinzione è fondamentale.
La soluzione potrebbe richiedere:
- riduzione dei picchi di importazione;
- tuning dei batch;
- ottimizzazione delle query dei custom indexer;
- riduzione delle scritture inutili;
- revisione delle dimensioni;
- miglioramento delle performance del database;
- distribuzione dei workload;
- redesign delle integrazioni custom.
Eseguire più full reindex non risolve un problema di throughput.
23. Il costo nascosto dei salvataggi prodotto inutili
Le integrazioni di terze parti generano spesso aggiornamenti non necessari.
Ad esempio, un ERP potrebbe eseguire:
UPDATE prodotto
anche quando il valore non è realmente cambiato.
Dal punto di vista del business:
non è cambiato nulla
ma dal punto di vista del database e del change detection quella scrittura può comunque generare lavoro downstream, a seconda delle tabelle interessate e del comportamento dei trigger.
Su larga scala:
ERP
 │
 ├── Prodotto 1 invariato → UPDATE
 ├── Prodotto 2 invariato → UPDATE
 ├── Prodotto 3 invariato → UPDATE
 └── Prodotto 4 invariato → UPDATE
può generare un enorme carico inutile.
Per grandi installazioni Magento, una delle migliori ottimizzazioni dell’indicizzazione è spesso sorprendentemente semplice:
Non scrivere dati che non sono cambiati.
Questo riduce:
scritture database
esecuzioni trigger
crescita changelog
carico indexer
cache invalidation
lock contention
ancora prima che l’indexer inizi a lavorare.
24. Cron fa parte dell’architettura di indicizzazione
Con l’indicizzazione schedulata, cron non è semplicemente un dettaglio operativo.
Fa parte del modello di consistenza.
L’architettura è effettivamente:
Scrittura Magento
       │
       ▼
    Changelog
       │
       ▼
      Cron
       │
       ▼
     MView
       │
       ▼
    Indexer
Se il cron si ferma:
Magento continua ad accettare scritture
ma:
gli indici smettono di aggiornarsi
Si crea quindi una modalità di errore interessante:
Dati Admin = corretti

Dati sorgente database = corretti

Indice frontend = obsoleto
L’applicazione ecommerce può quindi sembrare perfettamente funzionante mentre gli indici divergono progressivamente dai dati sorgente.
25. Perché questa architettura scala
La vera forza dell’indicizzazione Magento non è semplicemente il fatto che esistano degli indexer.
È la separazione tra:
WRITE PATH
e:
ELABORAZIONE DEI DATI DERIVATI
Un aggiornamento prodotto può rimanere relativamente leggero:
Salvataggio prodotto
        ↓
Modifica database
        ↓
Trigger
        ↓
Changelog
        ↓
Fine richiesta
mentre i calcoli costosi vengono eseguiti separatamente:
Cron
 ↓
MView
 ↓
Batch
 ↓
Dimensioni
 ↓
Indexer
 ↓
Tabelle indice
e, quando supportato:
Build
 ↓
Replica
 ↓
Switch
 ↓
Publish
Questa architettura permette a Magento di spostare i calcoli più costosi fuori dalle richieste interattive.
26. Magento Indexing come sistema Event-Driven
Un modo interessante per comprendere l’indicizzazione Magento consiste nello smettere di pensarla come un semplice “comando di reindex”.
Dal punto di vista architetturale, l’indicizzazione schedulata ricorda una pipeline semplificata di elaborazione eventi.
MODIFICA DATABASE
       │
       ▼
     TRIGGER
       │
       ▼
    CHANGELOG
       │
       ▼
     CURSORE
       │
       ▼
    CONSUMER
       │
       ▼
   STATO DERIVATO
L’analogia con sistemi come Kafka non è perfetta, ma è estremamente utile:
| Concetto Event-Driven | Concetto Magento |
|---|---|
| Producer | Scrittura catalogo/database |
| Event capture | Trigger MySQL |
| Event log | *_cl |
| Sequence / offset | version_id |
| Consumer offset | mview_state.version_id |
| Consumer | Indexer |
| Projection | Tabella indice |
Questo modello mentale rende molti problemi di indicizzazione Magento molto più semplici da analizzare.
Invece di chiedersi:
Perché il reindex non funziona?
è meglio chiedersi:
Le modifiche vengono prodotte?
        ↓
Entrano nel changelog?
        ↓
Il consumer viene eseguito?
        ↓
Il cursore avanza?
        ↓
Il consumer elabora più velocemente
di quanto vengano prodotte modifiche?
        ↓
L'indice risultante viene pubblicato correttamente?
Questo è un modello di debugging molto più potente.
27. Checklist pratica per il troubleshooting
Quando Magento mostra dati indicizzati non aggiornati, conviene analizzare la pipeline da sinistra verso destra.
SORGENTE
   ↓
RILEVAMENTO MODIFICHE
   ↓
CHANGELOG
   ↓
CONSUMER
   ↓
INDICE
   ↓
FRONTEND
Partiamo da:
bin/magento indexer:status
Poi:
bin/magento indexer:show-mode
Verifichiamo il cron.
Controlliamo:
cron_schedule
Successivamente:
indexer_state
mview_state
Confrontiamo:
MAX(*_cl.version_id)
con:
mview_state.version_id
Verifichiamo se il cursore avanza tra un’esecuzione cron e la successiva.
Successivamente analizziamo:
errori PHP
OOM kill
lock MySQL
deadlock
slow query
transazioni lunghe
disk I/O
CPU saturation
custom indexer
Soltanto dopo aver compreso la causa del problema un full reindex dovrebbe essere considerato una soluzione e non semplicemente un’operazione temporanea di recovery.
28. Il quadro completo
L’architettura può essere rappresentata in maniera più completa così:
                     WRITE PATH

                  Salvataggio prodotto
                         │
                         ▼
                    Tabelle sorgente
                         │
                         ▼
                    Trigger MySQL
                         │
                         ▼
                    Changelog *_cl
                         │
                         │
                         │ confine asincrono
                         ▼

                 PROCESSING PATH

                        Cron
                         │
                         ▼
                       MView
                         │
                         ▼
                   mview_state
                      Cursor
                         │
                         ▼
                Entity ID pendenti
                         │
                         ▼
                       Batch
                         │
                         ▼
                      Indexer
                         │
                         ▼
                    Dimensions
                         │
                         ▼
                Calcolo dell'indice
                         │
                         ▼

                  PUBBLICAZIONE

                   Tabelle indice
                         │
                  dove supportato
                         ▼
                  Replica / Swap
                         │
                         ▼
                    INDICE LIVE
                         │
                         ▼
                     FRONTEND
Il concetto chiave è questo:
L’indicizzazione Magento non è principalmente un meccanismo di rebuild. È una pipeline di sincronizzazione che mantiene proiezioni ottimizzate dei dati di business normalizzati.
Una volta compreso questo concetto, il comando:
bin/magento indexer:reindex
diventa soltanto una piccola parte del sistema.
La vera architettura è:
Rilevamento modifiche
          ↓
       Changelog
          ↓
   Consumer Cursor
          ↓
Elaborazione incrementale
          ↓
Calcolo dimensionale
          ↓
Pubblicazione sicura
Ed è proprio questa separazione che permette ad Adobe Commerce e Magento 2 di eseguire in modo asincrono calcoli di catalogo costosi mantenendo allo stesso tempo rapide le letture sul frontend.
FAQ
Cos’è un indice in Magento 2?
Un indice è una rappresentazione derivata dei dati di business Magento, ottimizzata per la lettura.
Invece di calcolare informazioni complesse come prezzi, regole o associazioni di categoria durante ogni richiesta frontend, Magento esegue questi calcoli in anticipo e memorizza il risultato nelle tabelle indice.
Cos’è MView in Magento 2?
MView significa Materialized View.
Magento utilizza il framework Magento\Framework\Mview per tracciare le modifiche alle entità del database e aggiornare incrementalmente gli indici.
Il sistema utilizza subscription sulle tabelle, trigger database, changelog e una posizione di avanzamento memorizzata per determinare cosa è cambiato dal ciclo di indicizzazione precedente.
Cosa sono le tabelle Magento *_cl?
Le tabelle che terminano con _cl sono changelog associati alle subscription MView.
Generalmente contengono almeno informazioni equivalenti a:
version_id
entity_id
Permettono a Magento di identificare quali entità sono state modificate e devono essere elaborate incrementalmente.
Cos’è version_id?
version_id è l’identificativo ordinato delle entry presenti nel changelog.
Permette a Magento di determinare la posizione delle modifiche e confrontarla con quella già elaborata dalla MView.
Può essere considerato concettualmente simile all’offset di uno stream di eventi.
Cosa significa mview_state.version_id?
Rappresenta l’avanzamento di una MView nel proprio changelog.
Se il changelog ha raggiunto:
20000
mentre lo stato MView è:
15000
esiste ancora lavoro non elaborato.
La differenza può essere utilizzata come indicatore operativo del lag dell’indexer, anche se non equivale direttamente al numero di prodotti in attesa.
Qual è la differenza tra indexer_state e mview_state?
indexer_state descrive lo stato operativo e di validità dell’indexer.
mview_state tiene invece traccia dell’avanzamento della MView nel changelog.
Semplificando:
indexer_state → "L'indice/indexer è OK?"

mview_state   → "Fino a dove abbiamo elaborato?"
Perché Magento utilizza trigger MySQL per l’indicizzazione schedulata?
I trigger permettono a Magento di rilevare rapidamente le modifiche al database senza eseguire il calcolo costoso dell’indice all’interno della richiesta che ha modificato i dati.
Il trigger registra l’entità interessata nel changelog e l’indicizzazione viene successivamente eseguita in maniera asincrona.
Magento reindicizza tutto il catalogo quando cambia un solo prodotto?
Normalmente no, quando l’indicizzazione incrementale funziona correttamente.
MView registra le entità interessate e l’indexer può elaborare soltanto quelle.
Un full reindex ricostruisce invece completamente l’indice.
Tutti gli indexer Magento utilizzano tabelle replica?
No.
Le tabelle replica, le tabelle di staging e il table switching sono strategie implementative utilizzate da specifici indexer.
Non bisogna considerarle una caratteristica universale di tutti gli indexer Magento.
Per analizzare un indexer specifico è necessario verificarne l’implementazione.
Posso eliminare le tabelle Magento *_tmp?
Non mentre un indexer potrebbe utilizzarle.
Le tabelle temporanee possono rimanere dopo processi falliti o interrotti, ma dovrebbero essere eliminate soltanto dopo aver verificato che nessun processo di indicizzazione attivo ne dipenda e dopo aver compreso come vengono utilizzate dall’indexer interessato.
Posso eliminare le tabelle Magento *_cl?
Non dovrebbero mai essere eliminate con leggerezza.
Le tabelle changelog fanno parte dell’architettura di indicizzazione incrementale.
Modificarle o eliminarle in modo errato può far perdere a Magento la traccia delle modifiche che devono ancora essere elaborate.
Perché le tabelle Magento *_cl continuano a crescere?
Le cause più comuni includono:
- cron non funzionante;
- errori nel consumer MView;
- indexer più lento rispetto alla velocità con cui vengono generate modifiche;
- importazioni molto grandi;
- aggiornamenti prodotto eccessivi;
- custom indexer inefficienti;
- problemi di performance del database.
Uno dei primi controlli da effettuare è confrontare la testa del changelog con mview_state.version_id.
Una tabella *_cl molto grande indica necessariamente un problema?
Non necessariamente.
La domanda più importante è capire se il cursore MView sta avanzando e se il backlog cresce continuamente.
Un grande backlog che viene rapidamente consumato può essere perfettamente normale dopo una grossa importazione.
Un backlog più piccolo ma in continua crescita potrebbe invece indicare un problema strutturale di throughput.
Perché un indexer:reindex manuale risolve il problema soltanto temporaneamente?
Perché il full reindex può correggere i dati derivati senza risolvere il problema che impedisce all’indicizzazione incrementale di funzionare.
Ad esempio, il cron potrebbe continuare a essere fermo oppure il consumer MView potrebbe non riuscire a mantenere il passo.
Quando arrivano nuove modifiche al catalogo, l’indice torna nuovamente obsoleto.
Perché l’indicizzazione Magento può essere lenta anche con relativamente pochi prodotti?
Il numero dei prodotti è soltanto uno dei fattori.
La complessità può dipendere anche da:
website
customer group
catalog rule
tipi di prodotto
inventory source
custom indexer
Un’installazione B2B multi-website può quindi richiedere molto più lavoro di indicizzazione rispetto a un altro ecommerce con lo stesso numero di SKU.
In produzione è meglio Update on Save o Update by Schedule?
Per la maggior parte dei workload di produzione, Adobe raccomanda Update by Schedule.
Questa modalità disaccoppia le operazioni di scrittura dall’indicizzazione e riduce il rischio che calcoli costosi o lock interferiscano con operazioni Admin e integrazioni.
La scelta può comunque dipendere dal workload e dal singolo indexer.
Come posso monitorare preventivamente l’indicizzazione Magento?
Come minimo è utile monitorare:
indexer_state.status
mview_state.version_id
MAX(*_cl.version_id)
esecuzioni cron
durata indexer
Per installazioni di grandi dimensioni può essere utile monitorare anche:
numero di entity distinte pendenti
età della modifica più vecchia non elaborata
throughput
velocità di crescita del backlog
database lock
utilizzo memoria PHP
Una differenza tra produzione e consumo del changelog che cresce continuamente è un forte indicatore del fatto che la pipeline di indicizzazione stia rimanendo indietro.
Fonti e approfondimenti
Adobe Commerce Developer Documentation
Architettura dell’indicizzazione
La documentazione Adobe descrive l’architettura di indicizzazione di Magento, compresi full indexing, partial indexing, MView, configurazione degli indexer e modalità di aggiornamento.
https://developer.adobe.com/commerce/php/development/components/indexing/
Creazione di custom indexer
Particolarmente utile per comprendere indexer.xml, mview.xml, executeRow(), executeList() ed executeFull().
https://developer.adobe.com/commerce/php/development/components/indexing/custom-indexer
Architettura del framework Adobe Commerce
Documentazione generale relativa al framework Commerce e ai suoi principali componenti architetturali.
https://developer.adobe.com/commerce/php/architecture/framework
Adobe Commerce Operations Documentation
Gestione degli indexer da CLI
Riferimento ufficiale per comandi come:
bin/magento indexer:status
bin/magento indexer:show-mode
bin/magento indexer:set-mode
bin/magento indexer:reindex
Index Management
Documentazione ufficiale relativa a Update on Save, Update by Schedule e gestione dello stato degli indexer.
https://experienceleague.adobe.com/en/docs/commerce-admin/systems/tools/index-management
Best practice per la configurazione degli indexer
Adobe raccomanda l’indicizzazione schedulata per i workload di produzione e analizza le implicazioni della configurazione degli indexer sulle performance.
Codice sorgente Magento 2
Per comprendere l’architettura a un livello ancora più profondo, il codice sorgente Magento rimane il riferimento definitivo.
Le aree particolarmente interessanti includono:
Magento\Framework\Mview
Magento\Framework\Indexer
Magento\Indexer
Magento\Catalog\Model\Indexer
Tra le classi e i componenti più utili da analizzare troviamo:
Magento\Framework\Mview\View
Magento\Framework\Mview\View\Subscription
Magento\Framework\Mview\View\Changelog
Magento\Framework\Indexer
Il codice sorgente è disponibile nel repository ufficiale Magento Open Source:
https://github.com/magento/magento2
Quando si analizza un indexer specifico è sempre consigliabile verificarne direttamente l’implementazione, perché non tutti gli indexer utilizzano esattamente la stessa strategia per tabelle temporanee, dimensioni, replica e table switching.