Magento 2: disponibile la patch ufficiale Adobe per CVE-2026-75650 – aggiornamento urgente
Aggiornamento del 9 settembre 2026
Nel nostro precedente articolo avevamo segnalato una nuova vulnerabilità critica che stava interessando installazioni Magento Open Source e Adobe Commerce, raccomandando ai merchant di intervenire rapidamente con le mitigazioni disponibili.
Adobe ha ora pubblicato il bollettino ufficiale APSB26-146 e reso disponibile l'hotfix per CVE-2026-75650.
La situazione è particolarmente importante perché Adobe ha confermato che la vulnerabilità è già stata sfruttata attivamente (exploited in the wild).
CVE-2026-75650: criticità massima CVSS 10.0
Adobe classifica CVE-2026-75650 come vulnerabilità Critical, con un punteggio:
CVSS: 10.0 / 10.0
La vulnerabilità è classificata come:
Improper Neutralization of Special Elements Used in a Template Engine (CWE-1336)
L'impatto potenziale è particolarmente grave: Arbitrary Code Execution.
Un attaccante potrebbe quindi arrivare ad eseguire codice arbitrario sul sistema vulnerabile.
L'aspetto ancora più importante è che, secondo il bollettino Adobe, non è richiesta autenticazione per lo sfruttamento.
Il vettore CVSS pubblicato da Adobe è:
CVSS:3.1/AV:N/AC:L/PR:N/UI:N/S:C/C:H/I:H/A:H
In termini pratici significa che l'attacco può essere eseguito da remoto, senza privilegi preventivi e senza interazione dell'utente.
Quali versioni Magento sono interessate?
Il bollettino riguarda un numero molto ampio di installazioni.
Magento Open Source
Sono interessate:
- Magento Open Source 2.4.9-2026-aug e precedenti
- Magento Open Source 2.4.8-2026-aug e precedenti
- Magento Open Source 2.4.7-2026-aug e precedenti
- Magento Open Source 2.4.6-2026-aug e precedenti
Adobe Commerce
Sono interessate anche le release delle linee:
- 2.4.9
- 2.4.8
- 2.4.7
- 2.4.6
- 2.4.5
- 2.4.4
comprese numerose patch release precedenti.
Sono inoltre interessate diverse versioni di Adobe Commerce B2B.
Adobe ha rilasciato l'hotfix ufficiale
Adobe ha pubblicato l'hotfix VULN-39341, disponibile in differenti versioni a seconda della release Magento installata.
Tra le versioni per cui Adobe fornisce esplicitamente una patch sono comprese, ad esempio:
- Magento / Adobe Commerce 2.4.8-p5
- 2.4.8-p4
- 2.4.8-p3
- 2.4.8-p2
- 2.4.8-p1
- 2.4.8
- 2.4.7-p10 e precedenti
- 2.4.6-p15 e precedenti
- diverse release delle linee 2.4.5 e 2.4.4
È quindi fondamentale identificare esattamente la versione installata prima di procedere e utilizzare la patch indicata da Adobe per quella specifica release.
Installare la patch non è sufficiente
Questo è probabilmente l'aspetto più importante dell'aggiornamento pubblicato da Adobe.
La remediation indicata da Adobe non termina con l'installazione dell'hotfix.
Dopo aver applicato la patch, Adobe raccomanda di procedere anche con la rotazione della encryption key e delle credenziali che potrebbero essere state esposte.
Il motivo è semplice: se un sistema fosse già stato compromesso prima dell'installazione della patch, chi ha effettuato l'attacco potrebbe essere già entrato in possesso di informazioni sensibili.
Cambiare solamente la chiave di cifratura non rende automaticamente inutilizzabili credenziali precedentemente sottratte.
Quali credenziali devono essere considerate?
Adobe indica esplicitamente di valutare la rotazione di:
- encryption key di Magento;
- password degli utenti Admin;
- token delle integrazioni REST, SOAP e GraphQL;
- OAuth client secret;
- credenziali dei payment gateway;
- credenziali del database;
- chiavi SSH e deploy key;
- credenziali utilizzate da cron e service account;
- API key dei servizi esterni, inclusi shipping, tax e altre integrazioni.
Per payment gateway e servizi esterni la rotazione deve essere effettuata anche presso il provider, non semplicemente modificando la configurazione all'interno di Magento.
Procedura consigliata
Per le installazioni interessate consigliamo di trattare l'intervento come una vera attività di incident response, non come un normale aggiornamento Magento.
Una possibile sequenza operativa è:
- verificare la versione esatta di Magento / Adobe Commerce;
- effettuare backup e snapshot dell'ambiente;
- preservare i log utili ad eventuali analisi successive;
- applicare immediatamente l'hotfix ufficiale Adobe appropriato;
- verificare che la patch risulti effettivamente applicata;
- analizzare log, filesystem, cron, utenti Admin e integrazioni alla ricerca di attività anomale;
- ruotare la Magento encryption key;
- cambiare password e credenziali potenzialmente compromesse;
- rigenerare token e secret delle integrazioni;
- ruotare le credenziali dei servizi esterni;
- svuotare le cache;
- riattivare cron e servizi eventualmente sospesi;
- monitorare attentamente il sistema nelle ore e nei giorni successivi.
Attenzione: la patch protegge dal nuovo exploit, ma non ripulisce un server compromesso
Questo punto è fondamentale.
L'installazione dell'hotfix serve a correggere la vulnerabilità, ma non deve essere considerata una bonifica automatica di un'installazione che potrebbe essere già stata compromessa.
Adobe stessa conferma che CVE-2026-75650 è stata sfruttata attivamente contro merchant Adobe Commerce.
Di conseguenza, soprattutto per ecommerce pubblicamente accessibili durante il periodo precedente all'installazione della patch, è opportuno verificare la presenza di eventuali Indicator of Compromise (IoC) e attività anomale.
Tra i controlli che consigliamo:
- file PHP recentemente creati o modificati;
- modifiche anomale sotto
pub/,app/,vendor/e directory scrivibili; - nuovi utenti Admin;
- modifiche ai privilegi degli utenti esistenti;
- nuove integrazioni Magento;
- token API sospetti;
- cron job sconosciuti;
- processi anomali;
- accessi SSH non riconosciuti;
- richieste HTTP sospette nei web server log;
- modifiche inattese a
.htaccess, configurazioni Nginx/Apache o file di bootstrap; - connessioni verso host esterni non previsti.
Su installazioni critiche può essere opportuno effettuare un'analisi più approfondita prima di considerare concluso l'incidente.
Come verificare la patch
Per gli ambienti Adobe Commerce Cloud, Adobe indica anche una procedura di verifica attraverso il Quality Patches Tool.
Ad esempio:
vendor/bin/magento-patches -n status | grep "39341\|Status"
La patch VULN-39341 deve risultare:
Applied
Negli altri ambienti è comunque consigliabile verificare esplicitamente l'applicazione della patch e non limitarsi al fatto che il comando di deployment sia terminato senza errori.
Cosa consigliamo ai merchant Magento
Se gestite un ecommerce Magento interessato dalla vulnerabilità, non consigliamo di rimandare l'intervento al normale ciclo di manutenzione.
La combinazione di:
- CVSS 10.0;
- Remote Code Execution;
- nessuna autenticazione richiesta;
- exploit già osservati in ambiente reale;
rende CVE-2026-75650 una vulnerabilità da trattare con priorità immediata.
La pubblicazione dell'hotfix ufficiale Adobe elimina inoltre la necessità di affidarsi esclusivamente a mitigazioni temporanee: è ora possibile applicare la correzione ufficiale prevista per la propria versione.
Hai un ecommerce Magento 2?
Il nostro team può supportare merchant e aziende nella gestione dell'emergenza CVE-2026-75650, occupandosi di:
- verifica della versione Magento installata;
- identificazione dell'hotfix corretto;
- applicazione e test della patch;
- verifica dell'effettiva installazione;
- analisi preliminare dell'installazione e dei log;
- ricerca di modifiche o comportamenti sospetti;
- supporto nella rotazione di encryption key, token e credenziali;
- verifica post-intervento dell'ecommerce.
In presenza di una possibile compromissione, possiamo inoltre affiancare il merchant nell'analisi tecnica dell'installazione e nella definizione delle attività necessarie alla messa in sicurezza.
Se il tuo ecommerce utilizza Magento 2 o Adobe Commerce e non hai ancora applicato l'hotfix CVE-2026-75650, contattaci per una verifica urgente.
Fonti
- Adobe Security Bulletin — APSB26-146
- Adobe Commerce Knowledge Base — Urgent Action Required: Critical Security Update Available for Adobe Commerce (APSB26-146)
- Adobe Commerce — istruzioni ufficiali per l'applicazione dell'hotfix CVE-2026-75650
Articolo aggiornato il 9 settembre 2026 sulla base delle informazioni ufficiali pubblicate da Adobe.
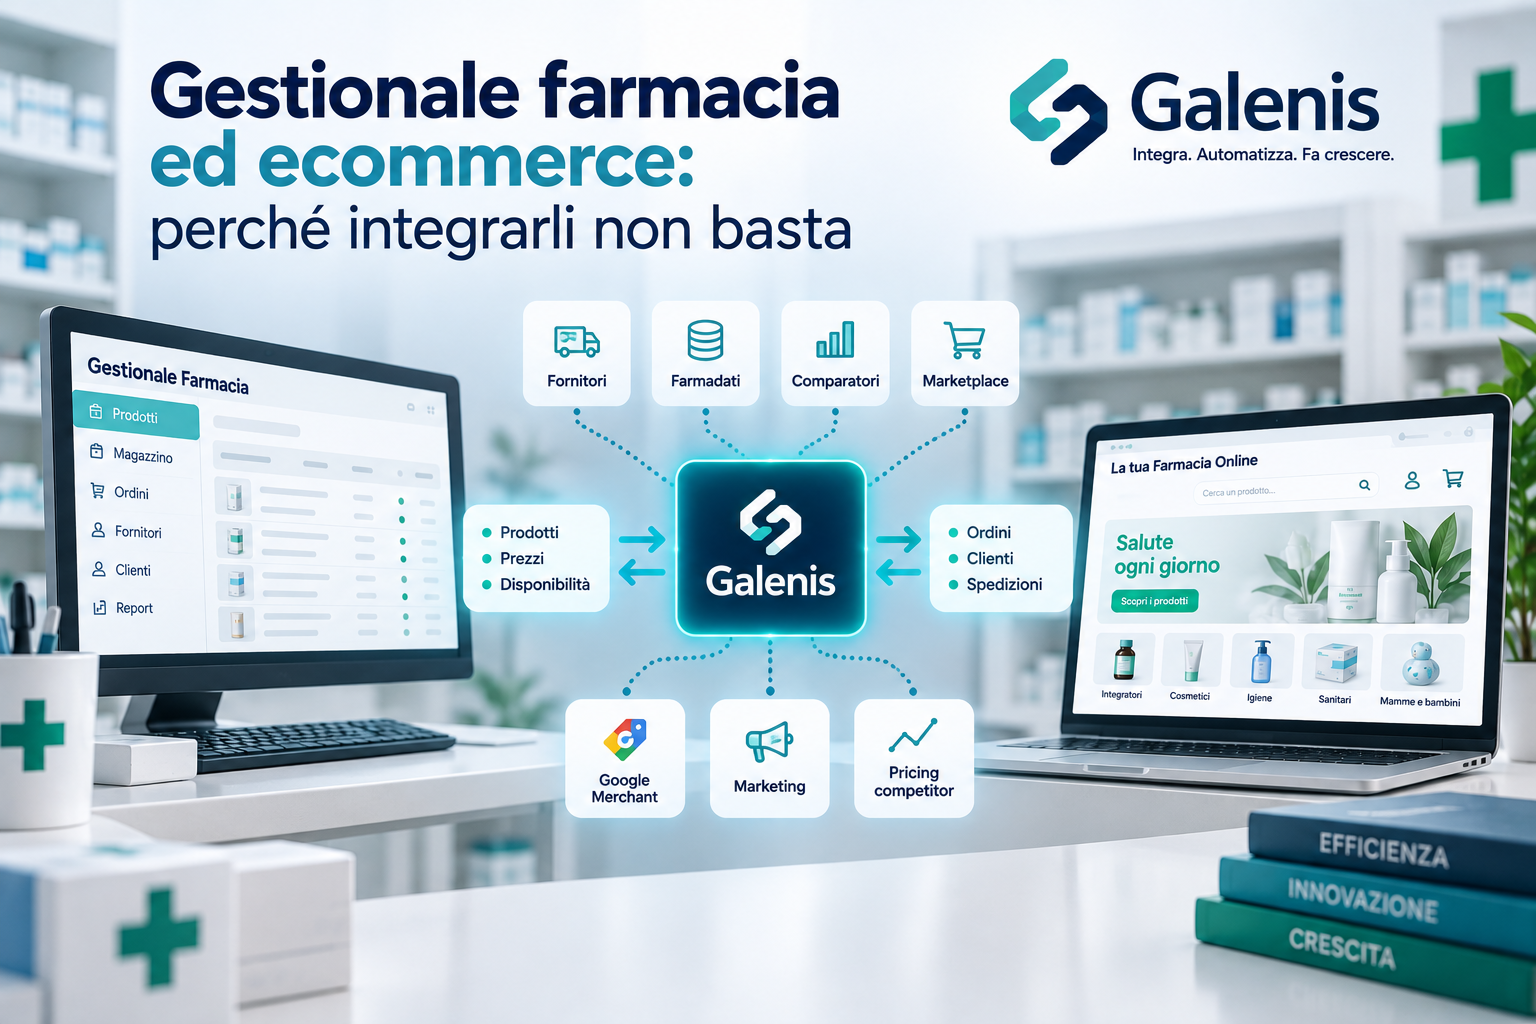
Gestionale farmacia ed ecommerce: perché integrarli non basta
Collegare il gestionale della farmacia all'ecommerce è importante.
Ma non basta.
Molte farmacie che vendono online hanno già realizzato una qualche forma di integrazione tra gestionale ed ecommerce: prodotti, prezzi e disponibilità vengono sincronizzati verso il sito e gli ordini vengono importati nel gestionale.
Tecnicamente, i due sistemi comunicano.
Eppure gran parte del lavoro continua a essere manuale.
Il problema è che integrare due sistemi non significa automatizzare un ecommerce.
Ed è proprio da questa differenza che nasce Galenis.
Il modello tradizionale: gestionale ↔ ecommerce
L'architettura più comune di una farmacia online è relativamente semplice:
Gestionale
    ↕
Ecommerce
Il gestionale contiene prodotti, prezzi, disponibilità e informazioni operative.
L'ecommerce vende i prodotti online.
Un connettore permette ai due sistemi di scambiarsi alcune informazioni.
Questo modello funziona, soprattutto nelle fasi iniziali di un progetto ecommerce.
Ma quando il business cresce, l'ecosistema diventa inevitabilmente più complesso.
Entrano in gioco:
- più fornitori;
- cataloghi esterni;
- Farmadati;
- comparatori di prezzo;
- Google Merchant;
- marketplace;
- sistemi di marketing;
- promozioni;
- strumenti di monitoraggio dei competitor;
- differenti strategie di pricing.
A quel punto non esistono più soltanto due sistemi da collegare.
Esiste un intero ecosistema da coordinare.
Il problema non è trasferire i dati
Supponiamo che il gestionale comunichi correttamente all'ecommerce che un prodotto ha:
Prezzo:        18,50 €
Disponibilità: 4 pezzi
L'integrazione ha fatto il proprio lavoro.
Ma queste informazioni sono sufficienti per decidere come vendere quel prodotto online?
Non necessariamente.
Potremmo voler sapere:
- quanto costa acquistarlo nuovamente;
- quale fornitore lo ha disponibile;
- qual è il margine minimo accettabile;
- se esiste una promozione;
- quanto costa dai principali concorrenti;
- se conviene pubblicarlo su un marketplace;
- quale prezzo inviare a Google Merchant;
- se vogliamo aumentare o ridurre la visibilità del prodotto.
Il problema quindi cambia.
Non dobbiamo più semplicemente trasferire un dato da A verso B.
Dobbiamo decidere cosa fare con quel dato.
Integrazione e automazione sono due cose diverse
Questa distinzione è fondamentale.
Un'integrazione permette a due sistemi di comunicare.
Un sistema di automazione utilizza invece i dati provenienti da più sistemi per eseguire processi e applicare regole.
Possiamo rappresentare la differenza così:
INTEGRAZIONE

Gestionale ────────── Ecommerce
rispetto a:
AUTOMAZIONE

                   Ecommerce
                       ↑
                       │
Gestionale ──────── Galenis ──────── Fornitori
                       │
          ┌────────────┼────────────┐
          ↓            ↓            ↓
     Comparatori   Marketplace   Marketing
Nel secondo modello Galenis non è semplicemente un ponte.
È il livello che coordina i diversi sistemi coinvolti nel commercio digitale della farmacia.
Un esempio: la disponibilità di un prodotto
Consideriamo un prodotto terminato nel magazzino della farmacia.
Un'integrazione tradizionale potrebbe comunicare all'ecommerce:
Disponibilità gestionale = 0
e quindi rendere il prodotto non disponibile.
Ma cosa succede se quello stesso prodotto è immediatamente disponibile presso uno dei fornitori della farmacia?
Un sistema più evoluto può ragionare su più informazioni:
Magazzino farmacia
        +
Disponibilità fornitori
        +
Tempi di approvvigionamento
        +
Regole commerciali
        ↓
Disponibilità ecommerce
Il dato pubblicato online non deve necessariamente essere la semplice copia di quello presente nel gestionale.
Può essere il risultato di una regola.
Ed è qui che l'automazione comincia a creare valore.
Lo stesso vale per il prezzo
Anche il prezzo può essere gestito in modo molto diverso.
Nel modello più semplice:
Prezzo gestionale
       ↓
Prezzo ecommerce
Ma una farmacia potrebbe voler utilizzare una strategia più articolata:
Costo prodotto
      +
Margine minimo
      +
Promozioni
      +
Prezzi concorrenti
      +
Disponibilità
      ↓
Prezzo di vendita
Il prezzo online diventa quindi il risultato di una strategia commerciale.
Non semplicemente un campo sincronizzato dal gestionale.
Gli ordini sono un altro esempio
Anche importare automaticamente un ordine ecommerce nel gestionale è solamente una parte del processo.
Il ciclo reale comprende molte più operazioni:
Ordine ecommerce
        ↓
Validazione
        ↓
Gestionale
        ↓
Verifica disponibilità
        ↓
Eventuale approvvigionamento
        ↓
Preparazione
        ↓
Spedizione
        ↓
Aggiornamento dei sistemi
Se alcune di queste attività rimangono manuali, l'ecommerce continua a richiedere un importante intervento operativo.
L'obiettivo dovrebbe essere quindi quello di automatizzare il processo, non soltanto il trasferimento dell'ordine.
Più cresce l'ecommerce, più aumentano le integrazioni
Questo è uno dei problemi architetturali più frequenti.
All'inizio abbiamo:
Gestionale ↔ Ecommerce
Successivamente aggiungiamo un collegamento con Google Merchant.
Poi Trovaprezzi.
Poi un fornitore.
Poi un secondo fornitore.
Poi Amazon.
Poi un sistema di pricing.
L'architettura rischia progressivamente di diventare:
Gestionale ─── Ecommerce
    │              │
    ├── Fornitore  │
    │              ├── Google
    ├── Farmadati  │
    │              ├── Trovaprezzi
    └──────────────┴── Marketplace
Ogni nuova integrazione introduce:
- nuove regole;
- nuovi formati;
- nuovi errori da gestire;
- nuovi processi da monitorare;
- nuove dipendenze.
Il costo non è soltanto quello dello sviluppo iniziale.
È soprattutto quello della manutenzione nel tempo.
Galenis introduce un livello intermedio
Galenis nasce per affrontare il problema in modo differente.
Invece di continuare ad aggiungere collegamenti diretti, introduce un livello centrale tra i sistemi:
                      Ecommerce
                          │
                          │
Gestionale ─────────── GALENIS ─────────── Fornitori
                          │
          ┌───────────────┼────────────────┐
          │               │                │
      Farmadati      Comparatori      Marketplace
                          │
                     Marketing
Ogni sistema continua a svolgere il proprio lavoro.
Il gestionale continua a essere il gestionale.
L'ecommerce continua a gestire l'esperienza di acquisto.
I fornitori continuano a gestire disponibilità e approvvigionamento.
Galenis coordina i flussi tra questi sistemi.
Galenis non è un gestionale
Questo punto è importante per comprendere il posizionamento del prodotto.
Galenis non vuole sostituire il gestionale della farmacia.
E non vuole sostituire la piattaforma ecommerce.
Si posiziona tra questi sistemi.
Possiamo definirlo come un middleware specializzato per il commercio digitale farmaceutico.
Il suo compito è:
- integrare;
- normalizzare;
- automatizzare;
- distribuire;
- orchestrare.
In altre parole:
Il gestionale gestisce la farmacia.
L'ecommerce gestisce la vendita online.
Galenis gestisce ciò che accade tra i due e intorno ai due.
Dal semplice connettore a un hub digitale
Questa differenza diventa ancora più evidente quando aumentano i canali.
Una farmacia potrebbe voler vendere attraverso:
                    Sito ecommerce
                          ↑
                          │
Amazon ←────────────── GALENIS ──────────────→ eBay
                          │
                          ↓
                   altri marketplace
Contemporaneamente potrebbe voler distribuire il catalogo verso:
Google Merchant
Trovaprezzi
Comparatori
Canali marketing
e acquisire informazioni da:
Gestionale
Farmadati
Fornitori
Competitor
Galenis diventa quindi un hub centrale attraverso cui transitano e vengono elaborate le informazioni necessarie al commercio digitale.
Automatizzare significa anche controllare
C'è un altro aspetto spesso sottovalutato.
Quando un ecommerce dipende da molti processi automatici è fondamentale sapere cosa sta succedendo.
Un'integrazione non dovrebbe essere semplicemente uno script che viene eseguito periodicamente.
Bisogna poter individuare:
- sincronizzazioni non riuscite;
- prodotti non aggiornati;
- ordini non importati;
- feed non generati;
- dati incoerenti;
- problemi con fornitori o servizi esterni.
Centralizzare i processi permette di avere maggiore visibilità sull'intero ecosistema.
E soprattutto permette di intervenire prima che un problema tecnico diventi un problema commerciale.
Un'architettura che cresce insieme alla farmacia
Una piccola farmacia online potrebbe iniziare semplicemente da:
Gestionale
    ↕
Galenis
    ↕
Ecommerce
Successivamente potrebbe aggiungere:
+ Farmadati
+ Google Merchant
+ Trovaprezzi
Poi:
+ Fornitori
+ Marketplace
+ Pricing
+ Monitoraggio competitor
L'architettura rimane la stessa.
Cambiano semplicemente i moduli e i servizi collegati.
È questo uno dei principi alla base di Galenis: non costruire ogni volta una nuova integrazione, ma creare un'infrastruttura digitale che possa evolvere insieme all'ecommerce.
Quando una semplice integrazione non basta più?
Ci sono alcuni segnali molto chiari.
Se il personale deve:
- correggere frequentemente prezzi e disponibilità;
- importare o verificare manualmente gli ordini;
- controllare più portali fornitori;
- aggiornare feed differenti;
- confrontare manualmente i prezzi;
- gestire separatamente diversi marketplace;
- verificare continuamente che le sincronizzazioni abbiano funzionato;
il problema probabilmente non è più collegare gestionale ed ecommerce.
Il problema è automatizzare il processo operativo.
Il vero obiettivo: far lavorare insieme i sistemi
Un ecommerce farmaceutico moderno può utilizzare decine di servizi differenti.
Pretendere che un unico software faccia tutto non è necessariamente la soluzione.
È molto più efficace permettere a ogni sistema di fare bene il proprio lavoro e creare un livello capace di coordinarli.
È questa la filosofia di Galenis.
Non sostituire.
Integrare. Automatizzare. Orchestrare.
Per trasformare un insieme di software indipendenti in un unico ecosistema digitale.
Vuoi capire se il tuo ecommerce è realmente automatizzato?
Avere gestionale ed ecommerce collegati non significa necessariamente avere un processo automatizzato.
Con Galenis possiamo analizzare il flusso attuale della farmacia:
Gestionale → Catalogo → Ecommerce → Ordine → Fornitori → Spedizione
individuare le attività che richiedono ancora intervento manuale e valutare quali processi possono essere automatizzati.
È possibile anche organizzare una demo partendo dal gestionale e dall'ecommerce già utilizzati dalla farmacia, per mostrare concretamente dove Galenis può inserirsi nell'infrastruttura esistente.
Contattaci per richiedere una demo di Galenis e analizzare il livello di automazione del tuo ecommerce farmaceutico.
FAQ
Qual è la differenza tra Galenis e un connettore gestionale-ecommerce?
Un connettore trasferisce principalmente informazioni tra due sistemi. Galenis è pensato per coordinare più sistemi e applicare processi e regole ai dati che transitano tra gestionale, ecommerce, fornitori e canali digitali.
Galenis sostituisce il gestionale della farmacia?
No. Galenis non è un gestionale. Il gestionale rimane il sistema operativo della farmacia, mentre Galenis gestisce integrazioni e automazioni verso l'ecosistema digitale.
Galenis sostituisce la piattaforma ecommerce?
No. Galenis si integra con la piattaforma ecommerce esistente e gestisce lo scambio di informazioni con gli altri sistemi.
Perché non collegare direttamente ogni servizio all'ecommerce?
È possibile, ma con l'aumentare dei servizi cresce anche il numero di integrazioni da sviluppare, controllare e mantenere. Un livello centrale permette di ridurre la frammentazione e centralizzare le logiche di integrazione.
Posso iniziare solamente dall'integrazione con il gestionale?
Sì. L'architettura di Galenis è modulare: è possibile iniziare dai processi prioritari e aggiungere successivamente nuovi servizi, fornitori e canali.
Galenis può integrarsi con i fornitori?
Sì, quando sono disponibili modalità tecniche di integrazione compatibili. Questo permette di utilizzare informazioni provenienti dai fornitori all'interno dei processi automatizzati.
È possibile integrare anche comparatori e marketplace?
Sì. Galenis è pensato per distribuire e sincronizzare informazioni verso differenti canali digitali, in funzione dei moduli e delle integrazioni configurate.
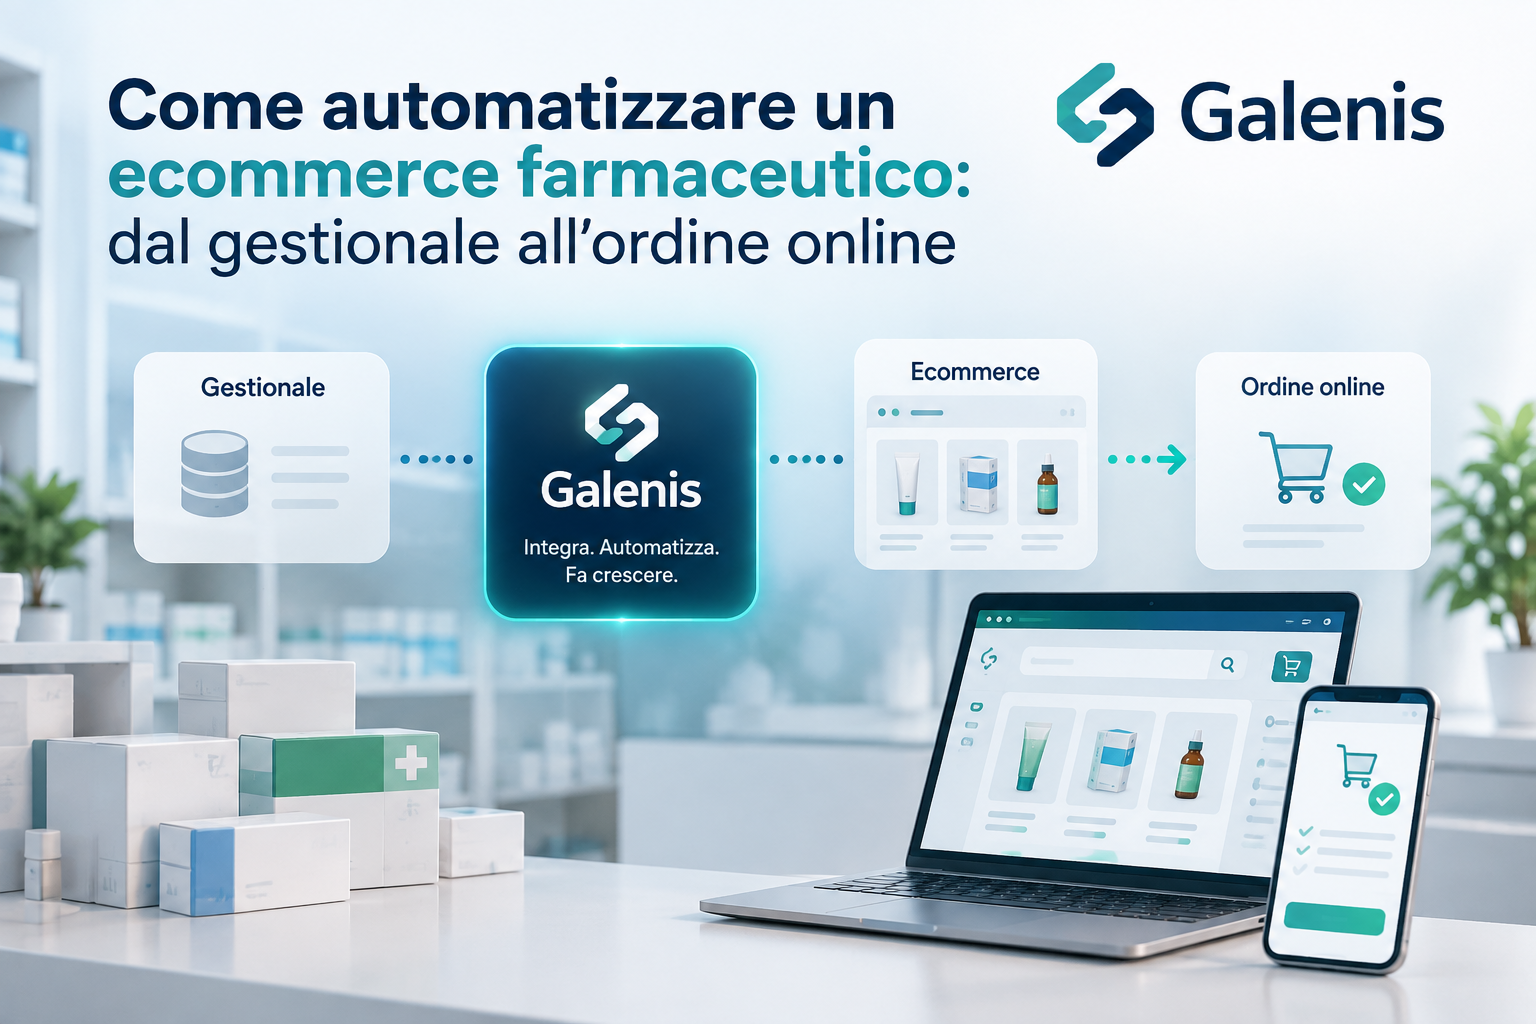
Come automatizzare un ecommerce farmaceutico: dal gestionale all’ordine online
Gestire un ecommerce farmaceutico significa coordinare sistemi molto diversi tra loro: gestionale della farmacia, ecommerce, cataloghi prodotto, disponibilità di magazzino, prezzi, promozioni, fornitori e marketplace.
Quando questi sistemi non comunicano in modo automatico, molte operazioni devono essere eseguite manualmente: aggiornamento delle giacenze, inserimento degli ordini nel gestionale, controllo dei prezzi, verifica della disponibilità dei prodotti o gestione degli acquisti.
Con l'aumento degli ordini, queste attività diventano rapidamente un limite alla crescita.
L'automazione permette invece di creare un flusso continuo tra il gestionale della farmacia e i diversi canali digitali, riducendo il lavoro manuale e rendendo più efficiente l'intero ciclo di vendita.
Il problema: gestionale ed ecommerce sono due mondi diversi
Il gestionale rappresenta normalmente il cuore operativo della farmacia.
Al suo interno troviamo informazioni fondamentali come:
- anagrafica dei prodotti;
- prezzi;
- disponibilità;
- movimenti di magazzino;
- ordini;
- acquisti;
- fornitori.
L'ecommerce utilizza parte di queste informazioni, ma ha esigenze differenti: catalogo online, immagini, descrizioni, promozioni, disponibilità pubblicata, ordini web, pagamenti e spedizioni.
A questi due sistemi si aggiungono spesso altri servizi:
- Farmadati;
- Google Merchant;
- Trovaprezzi;
- marketplace;
- fornitori e grossisti;
- sistemi di marketing;
- strumenti di analisi dei prezzi della concorrenza.
Il risultato può essere un ecosistema composto da numerose integrazioni indipendenti, script e procedure manuali.
L'obiettivo dovrebbe essere invece quello di costruire un unico flusso automatizzato dei dati.
Dal gestionale all'ecommerce
Il primo livello di automazione riguarda il catalogo.
Le informazioni disponibili nel gestionale possono essere sincronizzate automaticamente con l'ecommerce.
Ad esempio:
Gestionale
    ↓
Galenis
    ↓
Ecommerce
Galenis acquisisce i dati dal gestionale, li elabora secondo le regole configurate per la farmacia e li rende disponibili all'ecommerce.
Questo permette di automatizzare attività come:
- aggiornamento delle disponibilità;
- sincronizzazione dei prezzi;
- gestione delle anagrafiche prodotto;
- pubblicazione o disattivazione dei prodotti;
- applicazione delle regole commerciali.
Il gestionale continua quindi a essere il sistema operativo principale della farmacia, mentre Galenis gestisce lo scambio e la trasformazione dei dati verso i sistemi esterni.
Dall'ecommerce al gestionale: automatizzare gli ordini
Il flusso deve naturalmente funzionare anche nella direzione opposta.
Quando un cliente effettua un ordine online:
Cliente
    ↓
Ecommerce
    ↓
Galenis
    ↓
Gestionale
Galenis può acquisire automaticamente l'ordine e trasferire al gestionale le informazioni necessarie.
In questo modo il personale non deve reinserire manualmente gli ordini provenienti dal sito.
L'automazione riduce quindi:
- tempi di lavorazione;
- errori di inserimento;
- duplicazione delle attività;
- differenze tra ecommerce e gestionale.
L'ordine online entra direttamente nel normale processo operativo della farmacia.
Gestire automaticamente anche gli acquisti
Una delle aree più interessanti dell'automazione riguarda il rapporto con i fornitori.
Quando la disponibilità interna non è sufficiente, il sistema può utilizzare le informazioni provenienti dai fornitori per verificare disponibilità e condizioni di acquisto.
Il flusso diventa quindi più articolato:
             ┌── Ecommerce
             │
Gestionale ↔ Galenis
             │
             ├── Fornitori
             ├── Marketplace
             ├── Google Merchant
             └── Comparatori
Galenis diventa il punto di coordinamento tra i diversi sistemi.
Questo approccio consente di sviluppare progressivamente logiche più evolute per l'approvvigionamento e l'ottimizzazione degli acquisti.
Un solo dato, più canali
Un altro vantaggio importante riguarda la distribuzione delle informazioni.
Lo stesso catalogo può infatti essere utilizzato per alimentare diversi canali.
Ad esempio, una variazione di prezzo può essere acquisita dal gestionale e successivamente distribuita automaticamente verso:
Gestionale
    ↓
Galenis
    ├── Ecommerce
    ├── Google Merchant
    ├── Trovaprezzi
    ├── eBay
    ├── Amazon
    └── altri canali
Invece di creare un'integrazione specifica per ogni sistema, Galenis centralizza la gestione dei flussi.
Questo rende l'infrastruttura più semplice da controllare e soprattutto più facile da estendere.
Prezzi e promozioni possono diventare dinamici
Automatizzare un ecommerce farmaceutico non significa soltanto trasferire dati.
Una volta centralizzati i flussi diventa possibile applicare regole commerciali prima che le informazioni vengano inviate ai diversi canali.
Per esempio, il prezzo pubblicato potrebbe essere determinato considerando:
- prezzo presente nel gestionale;
- costo di acquisto;
- margine minimo;
- promozioni;
- disponibilità;
- condizioni del fornitore;
- prezzi rilevati sui siti concorrenti.
In questo modo l'automazione diventa uno strumento commerciale e non soltanto tecnico.
Perché utilizzare un middleware
È possibile collegare direttamente ecommerce e gestionale.
Quando però aumentano i sistemi coinvolti, le integrazioni punto-punto diventano progressivamente più difficili da gestire.
Immaginiamo di dover collegare:
Gestionale
Ecommerce
Farmadati
2 fornitori
Google Merchant
Trovaprezzi
Amazon
eBay
Realizzare collegamenti indipendenti tra questi sistemi significa moltiplicare le integrazioni da sviluppare e mantenere.
Un middleware introduce invece un livello centrale:
                    Ecommerce
                        │
Farmadati ────────── Galenis ────────── Gestionale
                        │
        ┌───────────────┼───────────────┐
        ↓               ↓               ↓
    Fornitori       Comparatori     Marketplace
Ogni sistema comunica con Galenis e Galenis gestisce le regole necessarie per trasferire le informazioni agli altri componenti.
Galenis non sostituisce il gestionale
Questo è un aspetto fondamentale.
Galenis non è un gestionale per farmacia e non vuole sostituirlo.
Il gestionale continua a gestire le attività per le quali è stato progettato.
Galenis si inserisce invece tra il gestionale e il mondo esterno per automatizzare lo scambio dei dati e orchestrare i processi digitali.
Possiamo quindi considerarlo come un layer di integrazione:
GESTIONALE
     ↕
   GALENIS
     ↕
ECOSISTEMA DIGITALE
Questo permette alla farmacia di mantenere gli strumenti che già utilizza e aggiungere progressivamente nuove integrazioni.
Un'architettura modulare
Non tutte le farmacie hanno le stesse esigenze.
Una farmacia potrebbe aver bisogno solamente della sincronizzazione tra gestionale ed ecommerce.
Un'altra potrebbe voler aggiungere Trovaprezzi e Google Merchant.
Una realtà con volumi maggiori potrebbe voler integrare fornitori, marketplace, sistemi di pricing e analisi della concorrenza.
Per questo Galenis è stato progettato come piattaforma modulare.
È possibile attivare solo i componenti necessari e aggiungerne altri quando l'ecommerce cresce.
Quali processi è possibile automatizzare?
A seconda del gestionale, dell'ecommerce e dei servizi utilizzati, Galenis può intervenire su diverse aree:
| Area | Automazione |
|---|---|
| Catalogo | Sincronizzazione prodotti |
| Magazzino | Aggiornamento disponibilità |
| Prezzi | Sincronizzazione e regole commerciali |
| Ordini | Importazione automatica nel gestionale |
| Acquisti | Collegamento con fornitori |
| Farmadati | Arricchimento dei dati prodotto |
| Comparatori | Esportazione automatica dei feed |
| Google Merchant | Aggiornamento catalogo |
| Marketplace | Sincronizzazione prodotti e offerte |
| Pricing | Monitoraggio e confronto dei prezzi |
L'obiettivo non è semplicemente collegare due software, ma automatizzare l'intero ciclo operativo dell'ecommerce.
I vantaggi per la farmacia
Un'infrastruttura integrata permette innanzitutto di ridurre le attività ripetitive.
Il personale può dedicare meno tempo alla gestione manuale dei dati e concentrarsi sulle attività a maggiore valore.
Ma esiste anche un secondo vantaggio: la scalabilità.
Passare da 20 a 200 ordini giornalieri non dovrebbe richiedere dieci volte il lavoro amministrativo.
Quando i processi sono automatizzati, l'aumento dei volumi può essere gestito con un incremento molto più contenuto delle attività operative.
Vuoi capire quali processi del tuo ecommerce possono essere automatizzati?
Ogni farmacia utilizza una combinazione differente di gestionale, ecommerce, fornitori e servizi esterni.
Per questo l'integrazione parte dall'analisi dei flussi esistenti.
Con Galenis possiamo analizzare l'attuale processo della farmacia — dal gestionale alla pubblicazione del prodotto, fino alla ricezione e gestione dell'ordine — e individuare quali attività possono essere automatizzate.
È inoltre possibile predisporre una demo utilizzando il gestionale e l'ecosistema ecommerce già utilizzati dalla farmacia, per mostrare concretamente come Galenis può inserirsi nell'infrastruttura esistente.
Contattaci per richiedere una demo di Galenis o un'analisi dei flussi del tuo ecommerce farmaceutico.
FAQ
È necessario cambiare il gestionale della farmacia?
No. Galenis nasce per integrarsi con il gestionale esistente. L'obiettivo è collegarlo all'ecommerce e agli altri servizi digitali senza sostituire gli strumenti già utilizzati dalla farmacia.
Galenis può collegare gestionale ed ecommerce?
Sì. Uno degli utilizzi principali di Galenis è proprio l'automazione dei flussi tra gestionale ed ecommerce, sia dal gestionale verso il sito sia dall'ecommerce verso il gestionale.
Gli ordini online possono essere importati automaticamente?
Sì, quando il gestionale mette a disposizione modalità di integrazione compatibili. Gli ordini ricevuti dall'ecommerce possono essere acquisiti da Galenis e trasferiti al gestionale secondo il flusso configurato.
È possibile sincronizzare automaticamente prezzi e disponibilità?
Sì. Prezzi e disponibilità possono essere acquisiti dalle fonti configurate, elaborati e sincronizzati con l'ecommerce.
È possibile collegare anche i fornitori?
Sì. Galenis può integrare anche fornitori esterni per automatizzare i flussi di approvvigionamento e utilizzare informazioni come disponibilità e condizioni di acquisto.
È necessario attivare tutti i moduli?
No. Galenis è modulare. La farmacia può iniziare dalle integrazioni necessarie e aggiungere successivamente nuovi servizi e canali.
È possibile vedere Galenis funzionare con il nostro gestionale?
Sì. È possibile richiedere una demo per valutare l'integrazione con il gestionale, l'ecommerce e gli altri servizi già utilizzati dalla farmacia.
Vuoi integrare il gestionale della tua farmacia con Woocommerce, Prestashop, Magento o Shopify? Contattaci per una demo.
StyleSmuggler: nuova vulnerabilità critica per Magento 2 e Adobe Commerce
Aggiornamento: 7 settembre 2026
È stata identificata una nuova vulnerabilità critica che interessa Magento Open Source e Adobe Commerce, denominata StyleSmuggler.
La vulnerabilità è particolarmente seria perché può consentire a un attaccante di ottenere Remote Code Execution (RCE) senza autenticazione, cioè eseguire codice sul server senza conoscere credenziali Magento Admin.
Il problema non è solamente teorico.
Secondo le analisi pubblicate da Sansec, gli attacchi sono già stati osservati in ambiente reale a partire dal 4 settembre 2026.
Sono state inoltre riprodotte con successo catene di attacco su installazioni pulite di:
Magento Open Source 2.4.7
Magento Open Source 2.4.8
Magento Open Source 2.4.9
Il primo sistema compromesso analizzato dai ricercatori utilizzava inoltre Magento 2.4.6-p15 con gli aggiornamenti di sicurezza di luglio e agosto 2026 già installati.
Questo significa che avere Magento aggiornato alle patch precedentemente disponibili non è sufficiente, da solo, a escludere il rischio.
Cos'è StyleSmuggler?
StyleSmuggler sfrutta il sistema di rendering dei template di Magento.
In termini semplificati, l'attacco riesce a introdurre contenuto malevolo all'interno di dati che vengono successivamente elaborati dal sistema di template Magento.
La catena di attacco può portare all'esecuzione di codice PHP sul server.
Il problema più rilevante è che l'attaccante:
- non deve conoscere la password di Magento Admin;
- non necessita di un account cliente;
- può attaccare un Magento pubblicamente raggiungibile;
- può installare meccanismi di persistenza anche al di fuori della directory Magento.
Non siamo quindi di fronte a una semplice vulnerabilità del frontend.
Una compromissione riuscita deve essere trattata come una possibile compromissione dell'intero server.
Quali versioni Magento sono interessate?
Le informazioni disponibili al momento indicano che il problema interessa le versioni correnti di Magento Open Source e Adobe Commerce.
Sansec ha dichiarato di aver riprodotto la catena completa su:
Magento 2.4.7
Magento 2.4.8
Magento 2.4.9
ed ha rilevato il primo caso su una:
Magento 2.4.6-p15
che disponeva già delle patch precedenti.
Di conseguenza, non bisogna presumere che un Magento sia sicuro semplicemente perché:
bin/magento security:patch-status
non segnala patch mancanti.
La vulnerabilità StyleSmuggler è infatti stata scoperta dopo gli aggiornamenti precedentemente disponibili.
Perché questa vulnerabilità è particolarmente pericolosa?
Normalmente, quando viene scoperta una vulnerabilità Magento, il merchant può:
- applicare la patch;
- verificare l'integrità dell'applicazione;
- aggiornare i moduli;
- controllare i log.
Con StyleSmuggler la situazione richiede maggiore attenzione.
Gli attaccanti osservati hanno installato un processo in background progettato per sembrare un normale processo Linux.
Uno degli indicatori individuati dai ricercatori utilizza un nome simile a:
[kworker/u:8:0]
Il nome richiama intenzionalmente i normali kernel worker Linux.
Questo significa che cercare esclusivamente file PHP sospetti dentro:
app/
vendor/
pub/
generated/
può non essere sufficiente.
Una scansione Magento pulita non garantisce che il server sia pulito
Questo è probabilmente il punto più importante per merchant e responsabili ecommerce.
Dopo una compromissione, l'attaccante può installare componenti persistenti:
Magento
   │
   ▼
Remote Code Execution
   │
   ├──► file Magento modificati
   │
   ├──► file temporanei
   │
   ├──► processi Linux
   │
   ├──► cron
   │
   ├──► home directory
   │
   └──► persistence esterna al webroot
Quindi:
Un controllo limitato alla directory Magento non permette necessariamente di escludere una compromissione.
Occorre verificare anche il sistema operativo.
Cosa dovrebbe controllare immediatamente un merchant Magento?
Se il proprio ecommerce Magento è stato pubblicamente raggiungibile dal 4 settembre 2026, consigliamo di effettuare almeno una verifica dell'infrastruttura.
Il controllo dovrebbe comprendere:
Magento
+
Sistema operativo
+
Processi
+
Cron
+
Filesystem
+
Log
+
Directory temporanee
+
Account di sistema
In particolare è opportuno verificare:
- processi attualmente in esecuzione;
- cron dell'utente Magento;
- cron di sistema;
- directory
/tmp; - home directory degli utenti;
- file Magento modificati recentemente;
- file presenti in
var/report; - processi persistenti;
- connessioni di rete anomale;
- file nascosti;
- modifiche recenti al filesystem;
- eventuali nuovi utenti o chiavi SSH.
Alcuni indicatori pubblicati da Sansec
Sansec ha pubblicato alcuni indicatori utili per identificare compromissioni già avvenute.
Tra questi risultano artefatti associati a directory e processi simili a:
~/.local/share/.gvfsd/
/tmp/.kw_*
/tmp/.gvfsd-*
e processi che possono presentarsi come:
[kworker/u:8:0]
Sono stati inoltre identificati riferimenti sospetti all'interno di:
var/report/
Questi controlli sono importanti, ma l'assenza di questi indicatori non dimostra automaticamente che il server non sia stato compromesso.
Gli indicatori di compromissione possono evolvere man mano che gli attaccanti modificano strumenti e tecniche.
Attenzione alle email "Payment Transaction Failed"
Sansec ha inoltre osservato che la catena StyleSmuggler può coinvolgere il rendering della normale email Magento:
Payment Transaction Failed Reminder
Un aumento improvviso o insolito di queste notifiche può quindi rappresentare un segnale da investigare.
Naturalmente una transazione realmente fallita può produrre la stessa email.
La presenza dell'email non significa quindi automaticamente che sia avvenuto un attacco.
Analogamente, non ricevere queste email non significa che il Magento sia sicuro, perché l'esecuzione può avvenire durante il rendering del template indipendentemente dalla corretta consegna del messaggio.
Patch: qual è la situazione?
Al momento della pubblicazione di questo articolo, 7 settembre 2026, StyleSmuggler è ancora oggetto di analisi.
Sansec ha pubblicato misure temporanee di detection e mitigation.
Adobe ha programmato il prossimo security bulletin Commerce per l'8 settembre 2026, ma al momento non è possibile considerare automaticamente quel rilascio come la correzione definitiva di StyleSmuggler fino alla pubblicazione delle informazioni ufficiali.
È quindi importante distinguere tre operazioni differenti:
MITIGATION
Ridurre/bloccare la possibilità di nuovo sfruttamento

PATCH
Correggere la vulnerabilità

CLEANUP
Rimuovere una compromissione già avvenuta
Una mitigation non elimina un malware eventualmente già installato sul server.
Analogamente, applicare una futura patch Adobe non potrà automaticamente rimuovere eventuali backdoor introdotte prima dell'aggiornamento.
Applicare la patch non basta se il server è già compromesso
Questo principio vale per qualsiasi vulnerabilità RCE.
Consideriamo:
4 settembre
      │
      ▼
attaccante entra nel server
      │
      ▼
installa persistence
      │
      ▼
8 settembre
      │
      ▼
merchant applica patch
La patch può impedire che la vulnerabilità venga sfruttata nuovamente.
Ma:
Backdoor già installata
        │
        └────► può continuare a funzionare
Per questo, se esistono indicatori di compromissione, bisogna affrontare separatamente:
Vulnerability remediation
e:
Incident response
Magento aggiornato non significa necessariamente server sicuro
L'incidente evidenzia ancora una volta un errore piuttosto frequente nella gestione della sicurezza ecommerce:
considerare la sicurezza Magento equivalente all'aggiornamento del software Magento.
In realtà bisogna considerare almeno quattro livelli:
APPLICATION
Magento + moduli

SERVER
Linux + PHP + servizi

INFRASTRUCTURE
Firewall + networking + accessi

MONITORING
Log + processi + filesystem + anomalie
Un ecommerce può avere:
Magento aggiornato
ma essere comunque compromesso a livello:
Linux
o tramite persistence installata prima dell'applicazione di una patch.
Il rischio per un ecommerce
Una Remote Code Execution su Magento deve essere considerata una vulnerabilità critica perché un ecommerce gestisce informazioni particolarmente sensibili:
- dati personali dei clienti;
- ordini;
- indirizzi;
- account;
- integrazioni ERP;
- API;
- credenziali applicative;
- token;
- sistemi di pagamento;
- servizi cloud;
- database.
Un attaccante che ottiene accesso al server potrebbe inoltre tentare di utilizzare il Magento come punto di partenza verso altri sistemi aziendali.
Per questo StyleSmuggler non deve essere trattata semplicemente come:
"un'altra patch Magento"
ma come un possibile incidente infrastrutturale.
Cosa consigliamo ai merchant Magento
Se gestite un ecommerce Magento Open Source o Adobe Commerce pubblicamente accessibile durante questa finestra di attacco, consigliamo di procedere con questo ordine:
1. Verificare l'esposizione
Identificare:
versione Magento
patch installate
periodo di esposizione
configurazione GraphQL
infrastruttura
2. Applicare le mitigation disponibili
Ridurre immediatamente la superficie di attacco utilizzando le mitigation disponibili e mantenendole aggiornate con l'evoluzione delle indicazioni dei ricercatori e di Adobe.
3. Controllare l'intero server
Non limitarsi alla directory Magento.
Analizzare:
processi
cron
filesystem
/tmp
home directories
connessioni
log
report Magento
4. Verificare gli indicatori di compromissione
Confrontare il sistema con gli IOC pubblicati e con le informazioni più recenti disponibili.
5. Prepararsi ad applicare immediatamente la patch ufficiale
Quando Adobe renderà disponibile una correzione specifica, questa dovrà essere testata e applicata rapidamente.
6. Se viene rilevata una compromissione, trattarla come un incidente
Non limitarsi a cancellare il primo file sospetto trovato.
Occorre verificare eventuali:
backdoor
cron
processi persistenti
credenziali compromesse
chiavi
token
file modificati
e valutare la rotazione delle credenziali potenzialmente esposte.
Devlogica può verificare il tuo Magento
Se gestisci un ecommerce Magento Open Source o Adobe Commerce e non sei sicuro dello stato del tuo sistema, possiamo effettuare una verifica tecnica dell'installazione e dell'infrastruttura.
Possiamo supportarti nella verifica di:
Versione Magento e security patch
            ↓
Esposizione a StyleSmuggler
            ↓
Controllo filesystem Magento
            ↓
Processi e cron del server
            ↓
Indicatori di compromissione
            ↓
Log e anomalie
            ↓
Mitigation
            ↓
Piano di remediation
In presenza di anomalie possiamo inoltre supportare il team IT nell'identificazione dell'origine della compromissione e nella messa in sicurezza dell'installazione.
Se vuoi verificare rapidamente il tuo ecommerce Magento, contatta Devlogica indicando la versione Magento utilizzata e la tipologia di hosting/server.
La priorità in questo momento non è semplicemente verificare se Magento segnala di essere aggiornato.
La domanda corretta è:
possiamo dimostrare che il server non è stato compromesso?
FAQ
StyleSmuggler interessa Magento 2.4.9?
Sì. Sansec dichiara di aver riprodotto la catena di attacco completa anche su Magento Open Source 2.4.9.
Magento 2.4.8 è vulnerabile?
Sì. La vulnerabilità è stata riprodotta su Magento 2.4.8.
Magento 2.4.7 è vulnerabile?
Sì. Anche Magento 2.4.7 è stato utilizzato dai ricercatori per riprodurre la catena completa.
Se Magento è completamente aggiornato sono al sicuro?
Non necessariamente.
Il primo sistema compromesso osservato dai ricercatori utilizzava Magento 2.4.6-p15 con le security patch di luglio e agosto 2026 installate.
StyleSmuggler era una vulnerabilità non ancora corretta da quelle patch.
L'attaccante deve conoscere la password Admin?
No.
Il problema è particolarmente critico perché la catena individuata consente una Remote Code Execution senza autenticazione.
È sufficiente eseguire una scansione dei file Magento?
No.
Una compromissione può produrre processi, cron e file di persistence al di fuori della directory Magento.
Il server deve quindi essere controllato nel suo complesso.
Se applico una mitigation sono sicuro?
Una mitigation serve a bloccare o ridurre la possibilità di nuovi attacchi.
Non elimina automaticamente eventuali backdoor installate precedentemente.
Se applico la futura patch Adobe posso considerare risolto il problema?
La patch correggerà la vulnerabilità a cui sarà destinata, ma una macchina compromessa prima dell'applicazione deve comunque essere sottoposta a verifica.
Patch e incident response sono due attività differenti.
Devo spegnere immediatamente il mio ecommerce?
Non esiste una risposta valida per qualsiasi infrastruttura.
È però opportuno effettuare immediatamente una valutazione del rischio, applicare le mitigation disponibili e verificare il sistema.
In presenza di indicatori di compromissione la priorità deve diventare il contenimento dell'incidente.
Fonti
Sansec — StyleSmuggler: Magento and Adobe Commerce 0-day RCE under active attack
Analisi tecnica pubblicata il 5 settembre 2026 con versioni testate, timeline, indicatori di compromissione e prime misure di mitigation.
https://sansec.io/research/stylesmuggler
Sansec Threat Research
Pagina di ricerca e aggiornamenti sulle campagne di attacco Magento e Adobe Commerce.
Adobe Commerce Security
Bollettini di sicurezza ufficiali Adobe Commerce e Magento Open Source.
https://helpx.adobe.com/security/security-bulletin.html
Adobe Commerce — APSB26-92
Aggiornamento di sicurezza Adobe dell'11 agosto 2026, precedente alla scoperta pubblica di StyleSmuggler.
https://experienceleague.adobe.com/en/docs/experience-cloud-kcs/kbarticles/ka-40380
Nota: StyleSmuggler è un incidente in corso e le informazioni tecniche possono cambiare rapidamente. Questo articolo verrà aggiornato con la pubblicazione di ulteriori dettagli da parte di Adobe, Sansec e degli altri ricercatori coinvolti.
Novità
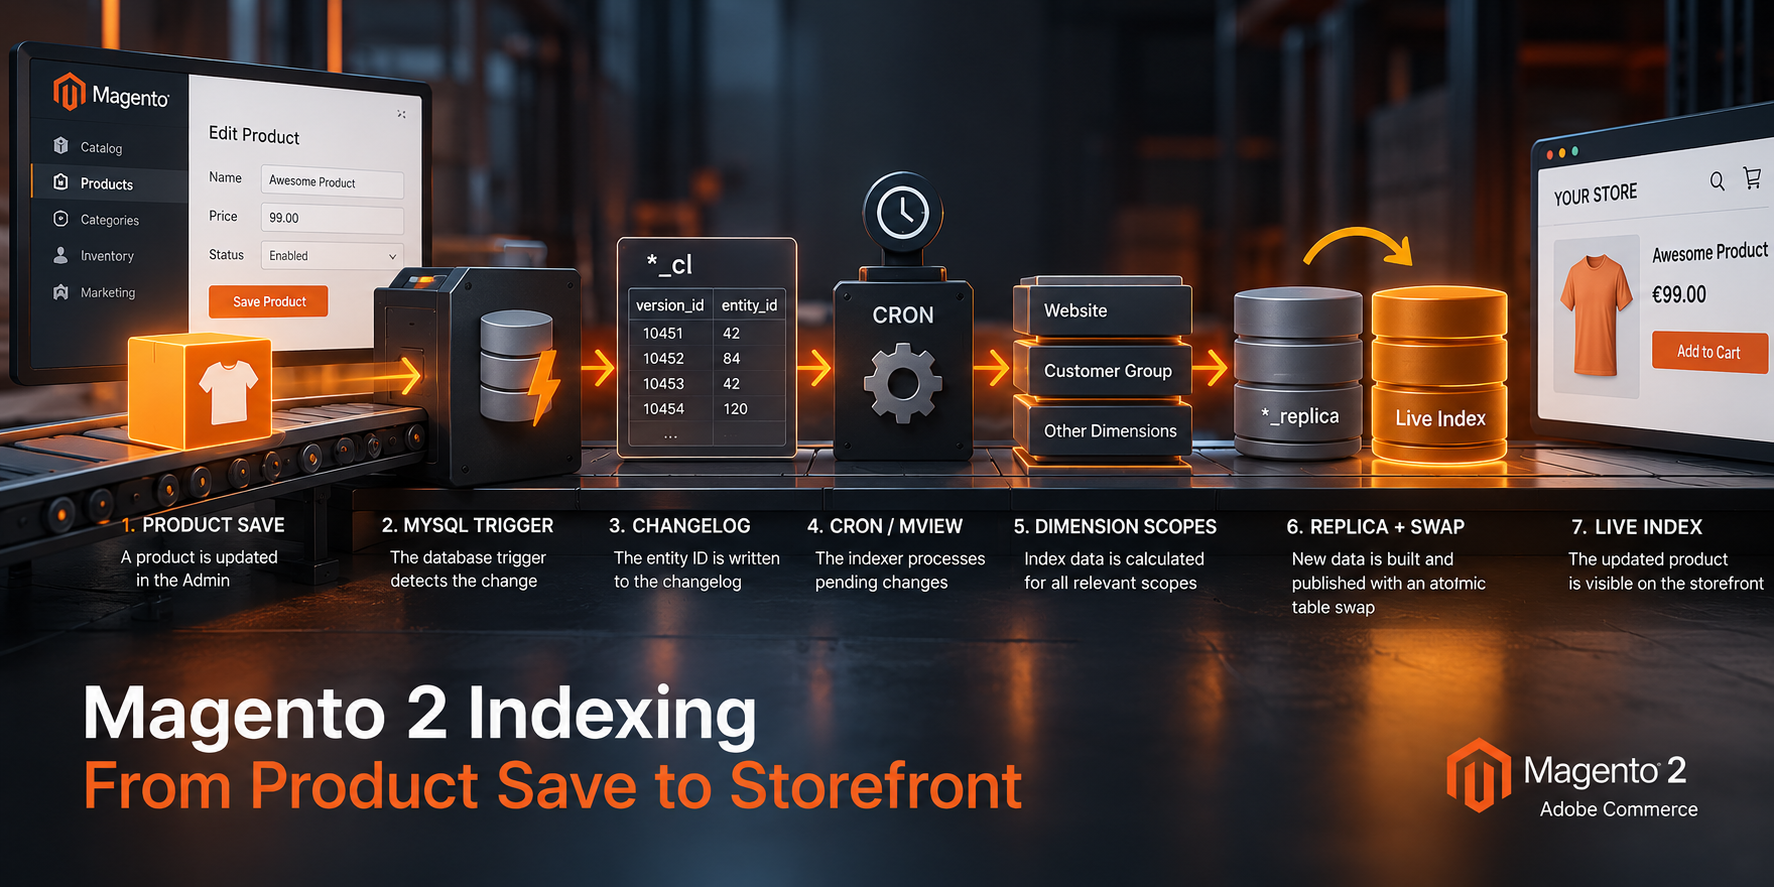
Come funziona DAVVERO l'indicizzazione in Magento 2 / Adobe Commerce
La maggior parte degli sviluppatori Magento 2 conosce questo comando:
bin/magento indexer:reindex
Ma cosa succede realmente tra la modifica di un prodotto nel pannello Admin e la visualizzazione del prezzo aggiornato, dell'associazione a una categoria o dei nuovi dati di ricerca sul frontend?
L'indicizzazione di Magento 2 / Adobe Commerce è molto più di un semplice comando che ricostruisce alcune tabelle del database.
Dietro alla modalità Update by Schedule esiste un'architettura basata su:
- rilevamento delle modifiche;
- trigger MySQL;
- tabelle di changelog;
- Materialized View (MView);
- elaborazione incrementale;
- stato degli indexer;
- elaborazione a batch;
- dimensioni e scope;
- e, per gli indexer che lo supportano, tabelle replica e table switching.
Comprendere questa architettura è estremamente utile quando bisogna diagnosticare problemi come:
- prodotti che mostrano prezzi non aggiornati;
- categorie che non si aggiornano;
- risultati di ricerca obsoleti;
- indexer apparentemente bloccati in stato
Processing; - tabelle
*_clche continuano a crescere; - processi cron che consumano CPU in modo anomalo;
- full reindex che richiedono ore;
- tabelle
*_tmpo replica rimaste dopo un reindex fallito.
L'architettura semplificata può essere rappresentata così:
                DATI SORGENTE
                     │
                     ▼
              Modifica prodotto
                     │
                     ▼
                Trigger MySQL
                     │
                     ▼
              Changelog *_cl
          version_id + entity_id
                     │
                     ▼
                 MView State
              ultimo version_id
                     │
                     ▼
             Cron / MView Update
                     │
                     ▼
           Indicizzazione incrementale
                     │
              ┌──────┴──────┐
              │             │
              ▼             ▼
         Dimensione A   Dimensione B
              │             │
              └──────┬──────┘
                     ▼
             Calcolo dell'indice
                     │
                     ▼
          Replica / dati temporanei
                dove previsto
                     │
                     ▼
              Table Switching
                dove previsto
                     │
                     ▼
                 INDICE LIVE
Il concetto più importante è che Magento separa tre responsabilità:
RILEVAMENTO MODIFICHE
          ↓
     ELABORAZIONE
          ↓
     PUBBLICAZIONE
Questa separazione è uno dei motivi per cui Magento può gestire cataloghi molto grandi senza dover ricalcolare tutti i dati derivati in maniera sincrona ogni volta che un amministratore salva un prodotto.
1. Perché Magento ha bisogno degli indici
Magento memorizza le informazioni del catalogo in una struttura fortemente normalizzata.
Il prezzo di un prodotto visualizzato sul frontend, ad esempio, può dipendere da:
- prezzo base;
- prezzo speciale;
- website;
- customer group;
- tier price;
- regole prezzo catalogo;
- tipo di prodotto;
- configurazione fiscale;
- relazioni dei prodotti configurabili;
- prezzi dei bundle;
- altre regole di business.
Calcolare dinamicamente tutto questo per ogni prodotto e per ogni richiesta frontend sarebbe estremamente costoso.
Magento trasforma quindi i dati sorgente in strutture ottimizzate per la lettura.
Concettualmente:
DATI DI BUSINESS NORMALIZZATI
             │
             │ calcoli costosi
             ▼
        TABELLE INDICE
             │
             │ letture ottimizzate
             ▼
          FRONTEND
Adobe definisce i dati originali come dictionary e la rappresentazione derivata come index.
La proprietà fondamentale di un indice è quindi:
Un indice è un dato derivato e, in linea di principio, ricostruibile.
Magento dovrebbe sempre essere in grado di rigenerare un indice partendo dai dati sorgente.
Questa distinzione è estremamente importante durante il troubleshooting.
Le tabelle contenenti le entità del catalogo rappresentano dati di business.
Le tabelle degli indici contengono dati derivati.
Le tabelle changelog e MView contengono invece le informazioni necessarie a mantenere sincronizzati i dati derivati con i dati sorgente.
Non vanno quindi considerate equivalenti.
2. Full Reindex vs Partial Reindex
Magento supporta due modalità concettualmente molto diverse di indicizzazione.
Full reindex
Un full reindex ricostruisce completamente un indice.
Ad esempio:
bin/magento indexer:reindex catalog_product_price
Concettualmente:
TUTTI I PRODOTTI
       │
       ▼
CALCOLO DEI PREZZI
       │
       ▼
INDICE PREZZI COMPLETO
Su cataloghi molto grandi questa operazione può essere estremamente costosa.
Se un ecommerce contiene centinaia di migliaia o milioni di SKU, sarebbe chiaramente inefficiente ricalcolare l'intero indice perché è cambiato un solo prodotto.
Per questo Magento supporta anche l'indicizzazione parziale.
Partial reindex
L'indicizzazione parziale elabora soltanto le entità interessate da una modifica.
Concettualmente:
Prodotto #42 modificato
          │
          ▼
    Changelog: 42
          │
          ▼
L'indexer elabora 42
          │
          ▼
    Indice aggiornato
È qui che entra in gioco l'architettura MView di Magento.
3. Update on Save vs Update by Schedule
Gli indexer Magento possono generalmente funzionare in due modalità:
Update on Save
oppure:
Update by Schedule
La configurazione attuale può essere verificata con:
bin/magento indexer:show-mode
e modificata con:
bin/magento indexer:set-mode schedule catalog_product_price
oppure:
bin/magento indexer:set-mode realtime catalog_product_price
Update on Save
Con Update on Save, l'attività di indicizzazione viene attivata in seguito alla modifica dei dati applicativi.
Questo permette di rendere rapidamente disponibili le modifiche nell'indice, ma sposta una parte maggiore del carico computazionale verso le operazioni di scrittura.
Su installazioni molto trafficate può aumentare:
- latenza dei salvataggi;
- lock contention;
- indicizzazioni concorrenti;
- carico sul database;
- probabilità di deadlock.
Update by Schedule
Con Update by Schedule, Magento registra ciò che è cambiato e lascia al cron il compito di elaborare le modifiche in maniera asincrona.
Concettualmente:
RICHIESTA HTTP
      │
      ▼
SALVATAGGIO PRODOTTO
      │
      ▼
REGISTRA MODIFICA
      │
      └────────────► FINE RICHIESTA

Successivamente...

CRON
 │
 ▼
LEGGE LE MODIFICHE
 │
 ▼
AGGIORNA L'INDICE
Negli ambienti di produzione l'indicizzazione schedulata è generalmente l'architettura preferibile.
Le linee guida Adobe sulle performance raccomandano infatti l'indicizzazione schedulata perché separa le scritture sul catalogo dalle operazioni potenzialmente costose di indicizzazione.
4. MView: l'astrazione Materialized View di Magento
Magento chiama il proprio sistema di change tracking MView, abbreviazione di Materialized View.
MySQL non offre lo stesso meccanismo nativo di materialized view disponibile in alcuni altri database, quindi Magento implementa una propria astrazione.
Il componente framework responsabile è:
Magento\Framework\Mview
Un modulo definisce le tabelle da monitorare all'interno di:
etc/mview.xml
Un esempio semplificato può essere:
<view
    id="catalog_category_product"
    class="Magento\Catalog\Model\Indexer\Category\Product"
    group="indexer">

    <subscriptions>

        <table
            name="catalog_category_entity"
            entity_column="entity_id"
        />

        <table
            name="catalog_category_entity_int"
            entity_column="entity_id"
        />

    </subscriptions>

</view>
La configurazione dice sostanzialmente a Magento:
Monitora queste tabelle sorgente
            ↓
Quando vengono modificate
            ↓
Registra l'entità interessata
            ↓
Invia gli entity ID
            ↓
A questo indexer
Questo rappresenta il collegamento tra le modifiche al database e l'indicizzazione incrementale.
5. Trigger MySQL: rilevare le modifiche
Quando una subscription MView è attiva, Magento utilizza trigger database per rilevare le modifiche alle tabelle sottoscritte.
A seconda della subscription, i trigger possono reagire a operazioni quali:
INSERT
UPDATE
DELETE
Il punto fondamentale è che il trigger non esegue normalmente il calcolo costoso dell'indice.
Il suo compito è molto più semplice:
MODIFICA DATI
     │
     ▼
TRIGGER MYSQL
     │
     ▼
REGISTRA ENTITY ID
Questo è fondamentale per le performance.
Immaginiamo di modificare il prezzo di un prodotto.
Una cattiva architettura potrebbe fare:
UPDATE PRODOTTO
      ↓
Calcolo prezzi per customer group
      ↓
Calcolo website
      ↓
Calcolo regole
      ↓
Aggiornamento tabelle indice
      ↓
Risposta HTTP
L'architettura schedulata di Magento mira invece a fare:
UPDATE PRODOTTO
      ↓
INSERT ID NEL CHANGELOG
      ↓
RISPOSTA
Il lavoro costoso viene eseguito successivamente e in maniera asincrona.
6. Le tabelle changelog *_cl
Le modifiche rilevate da MView vengono memorizzate in tabelle di changelog.
I loro nomi generalmente terminano con:
_cl
Una tabella changelog concettuale potrebbe essere:
catalog_product_price_cl

+------------+-----------+
| version_id | entity_id |
+------------+-----------+
| 10451      | 42        |
| 10452      | 84        |
| 10453      | 42        |
| 10454      | 120       |
+------------+-----------+
Le colonne più importanti sono:
version_id
entity_id
entity_id
Identifica l'entità interessata dalla modifica.
Ad esempio:
42
può rappresentare il prodotto con ID 42.
version_id
version_id fornisce una sequenza ordinata delle entry del changelog.
Concettualmente si comporta in modo simile all'offset di uno stream di eventi:
10451
10452
10453
10454
...
Questo permette a Magento di determinare:
Quali modifiche sono già state elaborate dall'indexer?
È uno dei concetti chiave dell'indicizzazione incrementale.
7. mview_state: il cursore del consumer
Magento deve ricordare fino a quale punto ogni MView ha elaborato il proprio changelog.
Questa informazione viene memorizzata nella tabella:
mview_state
Concettualmente:
+-----------------------+--------+------------+
| view_id               | status | version_id |
+-----------------------+--------+------------+
| catalog_product_price | idle   | 10452      |
+-----------------------+--------+------------+
Il valore più interessante è:
version_id
che rappresenta la posizione già elaborata dalla view.
Possiamo considerarlo come un consumer cursor.
Supponiamo che:
mview_state.version_id = 10452
mentre:
MAX(catalog_product_price_cl.version_id) = 10520
Magento sa che esistono ancora modifiche non elaborate.
Concettualmente:
10452                         10520
  │                             │
  ▼                             ▼
ULTIMO ELABORATO           ULTIMA MODIFICA

  |-----------------------------|
             INDEXER LAG
8. Come funziona l'elaborazione incrementale
L'SQL esatto e la gestione dei batch sono dettagli implementativi che possono variare, ma concettualmente il consumer MView esegue qualcosa di equivalente a:
SELECT DISTINCT entity_id
FROM catalog_product_price_cl
WHERE version_id > :last_processed_version
  AND version_id <= :current_upper_bound;
Supponiamo:
ultima versione elaborata = 1000
massimo attuale changelog  = 1100
L'indexer elabora:
1001 → 1100
Al termine dell'elaborazione, se tutto va a buon fine, il cursore può avanzare.
mview_state.version_id

1000
  ↓
1100
Il modello ricorda molto:
Producer
   ↓
Log ordinato
   ↓
Consumer
   ↓
Consumer Offset
Questa analogia è particolarmente utile per comprendere MView.
9. Perché è importante avere un limite superiore
Un problema interessante si presenta quando nuove modifiche al catalogo avvengono mentre l'indexer sta già lavorando.
Immaginiamo:
L'indexer parte

ultima versione = 1100
Durante l'elaborazione viene salvato un altro prodotto:
nuova versione = 1101
Magento deve evitare di includere continuamente nuove modifiche all'interno di un insieme di dati che cambia mentre lo sta elaborando.
Concettualmente lavora quindi su un intervallo delimitato:
ULTIMO CURSORE              LIMITE DEL BATCH
      │                           │
      ▼                           ▼
    1000 ----------------------- 1100

                                  1101
                                    │
                                    ▼
                              CICLO SUCCESSIVO
In questo modo il batch corrente è stabile.
Le modifiche arrivate dopo il limite vengono mantenute nel changelog e saranno elaborate nel ciclo MView successivo.
Questo contribuisce a rendere affidabile l'elaborazione asincrona incrementale.
10. Gli entity_id duplicati sono normali
Un prodotto può essere modificato più volte prima che l'indexer venga eseguito.
Ad esempio:
version_id    entity_id

2001          42
2002          42
2003          42
2004          73
Questo non significa necessariamente che Magento debba ricalcolare tre volte il prodotto 42.
L'informazione utile è generalmente:
42 è cambiato
73 è cambiato
per questo l'elaborazione può lavorare sull'insieme distinto degli identificativi.
Concettualmente:
CHANGELOG

42
42
42
73

 ↓ DISTINCT

42
73

 ↓

INDEXER
Questo spiega anche perché il numero di righe presenti nel changelog non deve essere automaticamente interpretato come il numero di prodotti in attesa di indicizzazione.
11. Magento elabora le modifiche a batch
Backlog molto grandi non possono essere caricati in memoria PHP tutti insieme in maniera sicura.
Immaginiamo un'integrazione che generi:
500.000 aggiornamenti prodotto
Elaborare ogni entità all'interno di un singolo array PHP potrebbe produrre:
elevato consumo memoria
         ↓
        OOM
         ↓
processo PHP terminato
         ↓
fallimento indexer
Magento supporta quindi l'elaborazione a batch.
Concettualmente:
CHANGELOG

1 ─────────────────── 500.000
        │
        ▼
      Batch 1
        │
        ▼
      Batch 2
        │
        ▼
      Batch 3
        │
        ▼
        ...
La dimensione dei batch diventa quindi un importante parametro di performance.
Batch troppo piccoli:
più query
più overhead
più transazioni
Batch troppo grandi:
più memoria
lock più lunghi
transazioni più grandi
rischio OOM
Trovare un buon equilibrio è particolarmente importante per:
- cataloghi molto grandi;
- importazioni ERP;
- sincronizzazioni PIM;
- feed marketplace;
- aggiornamenti massivi dei prezzi.
12. Dimensions: un prodotto non significa un solo valore indicizzato
Una delle parti più sottovalutate dell'indicizzazione Magento è l'indicizzazione dimensionale.
Alcuni valori derivati dipendono dal contesto.
Il prezzo di un prodotto, per esempio, può dipendere da:
Prodotto
   ×
Website
   ×
Customer Group
Concettualmente:
Prodotto 42

             Website A
            /         \
       Retail       Wholesale

             Website B
            /         \
       Retail       Wholesale
La modifica di un solo prodotto può quindi generare più record derivati nell'indice.
Questo spiega perché la complessità dell'indicizzazione non cresce necessariamente soltanto in funzione del:
numero di prodotti
ma può crescere più similmente a:
Prodotti
× Website
× Customer Group
× Altre dimensioni
a seconda dell'indexer.
Nelle installazioni B2B o multi-website di grandi dimensioni, questa differenza può diventare enorme.
13. Perché l'indicizzazione può esplodere nei Magento multi-website
Consideriamo un'installazione con:
500.000 prodotti
8 website
6 customer group
Un modello mentale semplicistico considera soltanto:
500.000 prodotti
Ma un calcolo dei prezzi sensibile alle dimensioni può coinvolgere uno spazio teorico molto più ampio:
500.000 × 8 × 6
ovvero:
24.000.000 di combinazioni
prodotto/website/customer-group
Questo non significa che Magento generi necessariamente e sempre esattamente 24 milioni di righe per ogni indexer.
Significa però che il numero di prodotti da solo non basta per stimare il costo dell'indicizzazione.
L'architettura conta.
Quando si analizza un problema di indicizzazione lenta, bisogna considerare sempre:
numero SKU
+
numero website
+
customer group
+
tipi di prodotto
+
catalog rule
+
architettura inventory
+
custom indexer
14. Tabelle replica e Table Switching
Alcuni indexer Magento utilizzano una strategia in cui i nuovi dati vengono preparati separatamente dalla tabella attualmente utilizzata dal frontend.
Concettualmente:
TABELLA LIVE
catalog_product_index_price

TABELLA REPLICA
catalog_product_index_price_replica
Il processo può quindi diventare:
Frontend
   │
   ▼
INDICE LIVE

Nel frattempo...

Dati sorgente
   │
   ▼
Indexer
   │
   ▼
REPLICA
Quando i nuovi dati sono pronti, Magento può eseguire uno switch tra le tabelle invece di sostituire progressivamente un grande insieme di dati live.
Concettualmente:
PRIMA

live     → DATI VECCHI
replica  → DATI NUOVI


SWITCH


DOPO

live     → DATI NUOVI
Il vantaggio è evidente.
Il frontend non deve assistere a un indice che viene ricostruito riga dopo riga.
La pubblicazione diventa invece un'operazione relativamente breve, dopo che la parte computazionalmente costosa è già stata eseguita.
Una precisazione importante
Replica table e table switching non sono passaggi universali implementati allo stesso modo da tutti gli indexer Magento.
I diversi indexer possono avere implementazioni differenti.
Di conseguenza, diagrammi come:
MView → Replica → Swap
sono utili come modello architetturale, ma non devono essere interpretati come se ogni indexer core o custom creasse necessariamente una tabella *_replica.
Per analizzare un indexer specifico è sempre opportuno verificarne direttamente l'implementazione.
15. Cosa sono le tabelle *_tmp?
Durante l'indicizzazione è possibile trovare tabelle con nomi contenenti:
_tmp
o altre convenzioni utilizzate per indicare tabelle temporanee o di staging.
Possono essere utilizzate per operazioni intermedie durante il processo di indicizzazione.
Questo porta talvolta a una pratica di troubleshooting molto pericolosa:
"Questa sembra una tabella temporanea.
Facciamo DROP."
Non fatelo.
Durante un'indicizzazione attiva:
DROP *_tmp
può interferire con il processo in esecuzione.
La tabella potrebbe essere necessaria per:
- calcoli intermedi;
- aggregazioni;
- table switching;
- scritture in staging;
- elaborazione a batch.
16. Quando possono essere eliminate le tabelle temporanee?
Un processo fallito può lasciare artefatti temporanei nel database.
Le cause tipiche includono:
PHP OOM
SIGKILL
restart del container
riavvio del server
interruzione del deployment
errore database
terminazione manuale del processo
Potremmo quindi trovare:
some_index_tmp
molto tempo dopo che il processo di indicizzazione sembra essersi concluso.
Prima di eliminare qualsiasi cosa è necessario verificare:
1. Nessun processo indexer è attivo
2. Il cron non sta elaborando quell'indice
3. Nessuna sessione DB sta usando la tabella
4. La tabella è realmente temporanea o abbandonata
5. L'indexer è in grado di ricrearla
6. Se necessario, è possibile eseguire successivamente un full reindex
Solo a questo punto può essere presa in considerazione una pulizia manuale.
17. Tabelle che NON dovresti eliminare con leggerezza
Due componenti particolarmente importanti sono:
*_cl
e:
mview_state
Non sono normali tabelle temporanee.
Fanno parte dell'infrastruttura di change tracking utilizzata dall'indicizzazione incrementale.
Concettualmente:
DATI SORGENTE
     │
     ▼
   *_cl
     │
     ▼
mview_state
     │
     ▼
   INDEXER
Rimuoverle o modificarle senza comprenderne le conseguenze può rompere la relazione tra:
ciò che è cambiato
e:
ciò che Magento ritiene
di aver già elaborato
Il risultato può essere molto più difficile da diagnosticare rispetto a una semplice tabella temporanea rimasta nel database.
18. indexer_state vs mview_state
Queste due tabelle vengono spesso confuse.
In realtà risolvono problemi differenti.
indexer_state
indexer_state descrive lo stato dell'indexer.
Gli stati concettualmente più importanti includono:
valid
invalid
working
Permette di rispondere a domande come:
Questo indice è considerato valido?
oppure:
Magento lo sta attualmente elaborando?
mview_state
mview_state descrive invece l'avanzamento del consumer della Materialized View.
Risponde alla domanda:
Fino a quale posizione del changelog questa MView è arrivata?
Concettualmente:
indexer_state
      │
      └── L'indice/indexer è valido o in esecuzione?


mview_state
      │
      └── Fino a dove abbiamo elaborato il changelog?
Durante il troubleshooting dell'indicizzazione schedulata, controllare soltanto indexer_state è quindi spesso insufficiente.
19. Misurare l'Indexer Lag
Una metrica operativa estremamente utile può essere ricavata confrontando il changelog con il cursore MView.
Supponiamo:
SELECT MAX(version_id)
FROM catalog_product_price_cl;
restituisca:
850000
mentre:
SELECT version_id
FROM mview_state
WHERE view_id = 'catalog_product_price';
restituisca:
845000
Il gap tra le versioni è:
850000 - 845000 = 5000
Concettualmente:
CURSORE MVIEW                     TESTA CHANGELOG

845000 ─────────────────────────── 850000
              5000 versioni
Questo valore può essere utilizzato come indicatore del fatto che il consumer stia iniziando a rimanere indietro.
Ma bisogna fare una precisazione importante.
Il version gap non equivale al numero di prodotti
Perché:
un singolo prodotto
può apparire più volte nel changelog.
Quindi:
version gap = 5000
non significa necessariamente:
5000 prodotti in attesa
Un sistema di monitoring più sofisticato dovrebbe misurare diversi indicatori:
version lag
numero di entity distinte in backlog
time lag
velocità di elaborazione
durata esecuzioni cron
Insieme, forniscono una visione molto migliore dello stato dell'indicizzazione.
20. Una strategia migliore per monitorare l'indicizzazione
Il monitoring di produzione dovrebbe idealmente rispondere alla domanda:
Quanto è indietro l'indexer?
e non soltanto:
L'ultimo cron ha avuto successo?
Metriche utili includono:
MAX(*_cl.version_id)
mview_state.version_id
COUNT(DISTINCT pending entity_id)
indexer_state.status
durata cron
throughput indicizzazione
età della modifica non elaborata più vecchia
Questo permette di generare alert prima che merchant o clienti inizino a vedere dati obsoleti.
Ad esempio:
NORMALE

Changelog head       105000
MView cursor         104995
Lag                        5


WARNING

Changelog head       205000
MView cursor         170000
Lag                    35000
Un gap che cresce continuamente è molto più significativo di un gap elevato ma temporaneo.
Se:
velocità produzione > velocità consumo
allora:
backlog → continua a crescere
Concettualmente l'indexer Magento è diventato un consumer sovraccarico.
21. Perché bin/magento indexer:reindex non è sempre la soluzione corretta
Una reazione molto comune quando Magento mostra dati non aggiornati è:
bin/magento indexer:reindex
A volte risolve il problema.
Ma potrebbe risolvere soltanto il sintomo.
Supponiamo che il vero problema sia:
cron non funzionante
oppure:
backlog MView
oppure:
custom indexer che impiega 20 minuti
oppure:
OOM durante l'elaborazione schedulata
Un full reindex manuale potrebbe temporaneamente ripristinare la correttezza dei dati.
Ma:
30 minuti dopo
il problema ricompare.
Una sequenza diagnostica migliore è:
bin/magento indexer:status

bin/magento indexer:show-mode

bin/magento cron:run
e successivamente analizzare:
cron_schedule
indexer_state
mview_state
*_cl
log applicativi
memoria PHP
attività database
L'obiettivo non deve essere semplicemente ricostruire l'indice.
Bisogna capire perché la sincronizzazione incrementale non riesce più a mantenere il passo.
22. Scenario comune: il consumer dell'indexer rimane indietro
Consideriamo un PIM che produce:
100.000 modifiche ogni 5 minuti
mentre l'indexer Magento riesce a processarne solamente:
60.000 ogni 5 minuti
Il sistema si comporta così:
Modifiche in ingresso
100k / 5 min
       │
       ▼
CHANGELOG
       │
       │ 60k / 5 min
       ▼
INDEXER
Ogni ciclo lascia quindi:
40.000
nuove modifiche in backlog.
Dopo un'ora:
40.000 × 12
=
480.000
modifiche possono essersi accumulate.
L'indexer non è necessariamente "rotto".
Semplicemente non possiede abbastanza throughput.
Questa distinzione è fondamentale.
La soluzione potrebbe richiedere:
- riduzione dei picchi di importazione;
- tuning dei batch;
- ottimizzazione delle query dei custom indexer;
- riduzione delle scritture inutili;
- revisione delle dimensioni;
- miglioramento delle performance del database;
- distribuzione dei workload;
- redesign delle integrazioni custom.
Eseguire più full reindex non risolve un problema di throughput.
23. Il costo nascosto dei salvataggi prodotto inutili
Le integrazioni di terze parti generano spesso aggiornamenti non necessari.
Ad esempio, un ERP potrebbe eseguire:
UPDATE prodotto
anche quando il valore non è realmente cambiato.
Dal punto di vista del business:
non è cambiato nulla
ma dal punto di vista del database e del change detection quella scrittura può comunque generare lavoro downstream, a seconda delle tabelle interessate e del comportamento dei trigger.
Su larga scala:
ERP
 │
 ├── Prodotto 1 invariato → UPDATE
 ├── Prodotto 2 invariato → UPDATE
 ├── Prodotto 3 invariato → UPDATE
 └── Prodotto 4 invariato → UPDATE
può generare un enorme carico inutile.
Per grandi installazioni Magento, una delle migliori ottimizzazioni dell'indicizzazione è spesso sorprendentemente semplice:
Non scrivere dati che non sono cambiati.
Questo riduce:
scritture database
esecuzioni trigger
crescita changelog
carico indexer
cache invalidation
lock contention
ancora prima che l'indexer inizi a lavorare.
24. Cron fa parte dell'architettura di indicizzazione
Con l'indicizzazione schedulata, cron non è semplicemente un dettaglio operativo.
Fa parte del modello di consistenza.
L'architettura è effettivamente:
Scrittura Magento
       │
       ▼
    Changelog
       │
       ▼
      Cron
       │
       ▼
     MView
       │
       ▼
    Indexer
Se il cron si ferma:
Magento continua ad accettare scritture
ma:
gli indici smettono di aggiornarsi
Si crea quindi una modalità di errore interessante:
Dati Admin = corretti

Dati sorgente database = corretti

Indice frontend = obsoleto
L'applicazione ecommerce può quindi sembrare perfettamente funzionante mentre gli indici divergono progressivamente dai dati sorgente.
25. Perché questa architettura scala
La vera forza dell'indicizzazione Magento non è semplicemente il fatto che esistano degli indexer.
È la separazione tra:
WRITE PATH
e:
ELABORAZIONE DEI DATI DERIVATI
Un aggiornamento prodotto può rimanere relativamente leggero:
Salvataggio prodotto
        ↓
Modifica database
        ↓
Trigger
        ↓
Changelog
        ↓
Fine richiesta
mentre i calcoli costosi vengono eseguiti separatamente:
Cron
 ↓
MView
 ↓
Batch
 ↓
Dimensioni
 ↓
Indexer
 ↓
Tabelle indice
e, quando supportato:
Build
 ↓
Replica
 ↓
Switch
 ↓
Publish
Questa architettura permette a Magento di spostare i calcoli più costosi fuori dalle richieste interattive.
26. Magento Indexing come sistema Event-Driven
Un modo interessante per comprendere l'indicizzazione Magento consiste nello smettere di pensarla come un semplice "comando di reindex".
Dal punto di vista architetturale, l'indicizzazione schedulata ricorda una pipeline semplificata di elaborazione eventi.
MODIFICA DATABASE
       │
       ▼
     TRIGGER
       │
       ▼
    CHANGELOG
       │
       ▼
     CURSORE
       │
       ▼
    CONSUMER
       │
       ▼
   STATO DERIVATO
L'analogia con sistemi come Kafka non è perfetta, ma è estremamente utile:
| Concetto Event-Driven | Concetto Magento |
|---|---|
| Producer | Scrittura catalogo/database |
| Event capture | Trigger MySQL |
| Event log | *_cl |
| Sequence / offset | version_id |
| Consumer offset | mview_state.version_id |
| Consumer | Indexer |
| Projection | Tabella indice |
Questo modello mentale rende molti problemi di indicizzazione Magento molto più semplici da analizzare.
Invece di chiedersi:
Perché il reindex non funziona?
è meglio chiedersi:
Le modifiche vengono prodotte?
        ↓
Entrano nel changelog?
        ↓
Il consumer viene eseguito?
        ↓
Il cursore avanza?
        ↓
Il consumer elabora più velocemente
di quanto vengano prodotte modifiche?
        ↓
L'indice risultante viene pubblicato correttamente?
Questo è un modello di debugging molto più potente.
27. Checklist pratica per il troubleshooting
Quando Magento mostra dati indicizzati non aggiornati, conviene analizzare la pipeline da sinistra verso destra.
SORGENTE
   ↓
RILEVAMENTO MODIFICHE
   ↓
CHANGELOG
   ↓
CONSUMER
   ↓
INDICE
   ↓
FRONTEND
Partiamo da:
bin/magento indexer:status
Poi:
bin/magento indexer:show-mode
Verifichiamo il cron.
Controlliamo:
cron_schedule
Successivamente:
indexer_state
mview_state
Confrontiamo:
MAX(*_cl.version_id)
con:
mview_state.version_id
Verifichiamo se il cursore avanza tra un'esecuzione cron e la successiva.
Successivamente analizziamo:
errori PHP
OOM kill
lock MySQL
deadlock
slow query
transazioni lunghe
disk I/O
CPU saturation
custom indexer
Soltanto dopo aver compreso la causa del problema un full reindex dovrebbe essere considerato una soluzione e non semplicemente un'operazione temporanea di recovery.
28. Il quadro completo
L'architettura può essere rappresentata in maniera più completa così:
                     WRITE PATH

                  Salvataggio prodotto
                         │
                         ▼
                    Tabelle sorgente
                         │
                         ▼
                    Trigger MySQL
                         │
                         ▼
                    Changelog *_cl
                         │
                         │
                         │ confine asincrono
                         ▼

                 PROCESSING PATH

                        Cron
                         │
                         ▼
                       MView
                         │
                         ▼
                   mview_state
                      Cursor
                         │
                         ▼
                Entity ID pendenti
                         │
                         ▼
                       Batch
                         │
                         ▼
                      Indexer
                         │
                         ▼
                    Dimensions
                         │
                         ▼
                Calcolo dell'indice
                         │
                         ▼

                  PUBBLICAZIONE

                   Tabelle indice
                         │
                  dove supportato
                         ▼
                  Replica / Swap
                         │
                         ▼
                    INDICE LIVE
                         │
                         ▼
                     FRONTEND
Il concetto chiave è questo:
L'indicizzazione Magento non è principalmente un meccanismo di rebuild. È una pipeline di sincronizzazione che mantiene proiezioni ottimizzate dei dati di business normalizzati.
Una volta compreso questo concetto, il comando:
bin/magento indexer:reindex
diventa soltanto una piccola parte del sistema.
La vera architettura è:
Rilevamento modifiche
          ↓
       Changelog
          ↓
   Consumer Cursor
          ↓
Elaborazione incrementale
          ↓
Calcolo dimensionale
          ↓
Pubblicazione sicura
Ed è proprio questa separazione che permette ad Adobe Commerce e Magento 2 di eseguire in modo asincrono calcoli di catalogo costosi mantenendo allo stesso tempo rapide le letture sul frontend.
FAQ
Cos'è un indice in Magento 2?
Un indice è una rappresentazione derivata dei dati di business Magento, ottimizzata per la lettura.
Invece di calcolare informazioni complesse come prezzi, regole o associazioni di categoria durante ogni richiesta frontend, Magento esegue questi calcoli in anticipo e memorizza il risultato nelle tabelle indice.
Cos'è MView in Magento 2?
MView significa Materialized View.
Magento utilizza il framework Magento\Framework\Mview per tracciare le modifiche alle entità del database e aggiornare incrementalmente gli indici.
Il sistema utilizza subscription sulle tabelle, trigger database, changelog e una posizione di avanzamento memorizzata per determinare cosa è cambiato dal ciclo di indicizzazione precedente.
Cosa sono le tabelle Magento *_cl?
Le tabelle che terminano con _cl sono changelog associati alle subscription MView.
Generalmente contengono almeno informazioni equivalenti a:
version_id
entity_id
Permettono a Magento di identificare quali entità sono state modificate e devono essere elaborate incrementalmente.
Cos'è version_id?
version_id è l'identificativo ordinato delle entry presenti nel changelog.
Permette a Magento di determinare la posizione delle modifiche e confrontarla con quella già elaborata dalla MView.
Può essere considerato concettualmente simile all'offset di uno stream di eventi.
Cosa significa mview_state.version_id?
Rappresenta l'avanzamento di una MView nel proprio changelog.
Se il changelog ha raggiunto:
20000
mentre lo stato MView è:
15000
esiste ancora lavoro non elaborato.
La differenza può essere utilizzata come indicatore operativo del lag dell'indexer, anche se non equivale direttamente al numero di prodotti in attesa.
Qual è la differenza tra indexer_state e mview_state?
indexer_state descrive lo stato operativo e di validità dell'indexer.
mview_state tiene invece traccia dell'avanzamento della MView nel changelog.
Semplificando:
indexer_state → "L'indice/indexer è OK?"

mview_state   → "Fino a dove abbiamo elaborato?"
Perché Magento utilizza trigger MySQL per l'indicizzazione schedulata?
I trigger permettono a Magento di rilevare rapidamente le modifiche al database senza eseguire il calcolo costoso dell'indice all'interno della richiesta che ha modificato i dati.
Il trigger registra l'entità interessata nel changelog e l'indicizzazione viene successivamente eseguita in maniera asincrona.
Magento reindicizza tutto il catalogo quando cambia un solo prodotto?
Normalmente no, quando l'indicizzazione incrementale funziona correttamente.
MView registra le entità interessate e l'indexer può elaborare soltanto quelle.
Un full reindex ricostruisce invece completamente l'indice.
Tutti gli indexer Magento utilizzano tabelle replica?
No.
Le tabelle replica, le tabelle di staging e il table switching sono strategie implementative utilizzate da specifici indexer.
Non bisogna considerarle una caratteristica universale di tutti gli indexer Magento.
Per analizzare un indexer specifico è necessario verificarne l'implementazione.
Posso eliminare le tabelle Magento *_tmp?
Non mentre un indexer potrebbe utilizzarle.
Le tabelle temporanee possono rimanere dopo processi falliti o interrotti, ma dovrebbero essere eliminate soltanto dopo aver verificato che nessun processo di indicizzazione attivo ne dipenda e dopo aver compreso come vengono utilizzate dall'indexer interessato.
Posso eliminare le tabelle Magento *_cl?
Non dovrebbero mai essere eliminate con leggerezza.
Le tabelle changelog fanno parte dell'architettura di indicizzazione incrementale.
Modificarle o eliminarle in modo errato può far perdere a Magento la traccia delle modifiche che devono ancora essere elaborate.
Perché le tabelle Magento *_cl continuano a crescere?
Le cause più comuni includono:
- cron non funzionante;
- errori nel consumer MView;
- indexer più lento rispetto alla velocità con cui vengono generate modifiche;
- importazioni molto grandi;
- aggiornamenti prodotto eccessivi;
- custom indexer inefficienti;
- problemi di performance del database.
Uno dei primi controlli da effettuare è confrontare la testa del changelog con mview_state.version_id.
Una tabella *_cl molto grande indica necessariamente un problema?
Non necessariamente.
La domanda più importante è capire se il cursore MView sta avanzando e se il backlog cresce continuamente.
Un grande backlog che viene rapidamente consumato può essere perfettamente normale dopo una grossa importazione.
Un backlog più piccolo ma in continua crescita potrebbe invece indicare un problema strutturale di throughput.
Perché un indexer:reindex manuale risolve il problema soltanto temporaneamente?
Perché il full reindex può correggere i dati derivati senza risolvere il problema che impedisce all'indicizzazione incrementale di funzionare.
Ad esempio, il cron potrebbe continuare a essere fermo oppure il consumer MView potrebbe non riuscire a mantenere il passo.
Quando arrivano nuove modifiche al catalogo, l'indice torna nuovamente obsoleto.
Perché l'indicizzazione Magento può essere lenta anche con relativamente pochi prodotti?
Il numero dei prodotti è soltanto uno dei fattori.
La complessità può dipendere anche da:
website
customer group
catalog rule
tipi di prodotto
inventory source
custom indexer
Un'installazione B2B multi-website può quindi richiedere molto più lavoro di indicizzazione rispetto a un altro ecommerce con lo stesso numero di SKU.
In produzione è meglio Update on Save o Update by Schedule?
Per la maggior parte dei workload di produzione, Adobe raccomanda Update by Schedule.
Questa modalità disaccoppia le operazioni di scrittura dall'indicizzazione e riduce il rischio che calcoli costosi o lock interferiscano con operazioni Admin e integrazioni.
La scelta può comunque dipendere dal workload e dal singolo indexer.
Come posso monitorare preventivamente l'indicizzazione Magento?
Come minimo è utile monitorare:
indexer_state.status
mview_state.version_id
MAX(*_cl.version_id)
esecuzioni cron
durata indexer
Per installazioni di grandi dimensioni può essere utile monitorare anche:
numero di entity distinte pendenti
età della modifica più vecchia non elaborata
throughput
velocità di crescita del backlog
database lock
utilizzo memoria PHP
Una differenza tra produzione e consumo del changelog che cresce continuamente è un forte indicatore del fatto che la pipeline di indicizzazione stia rimanendo indietro.
Fonti e approfondimenti
Adobe Commerce Developer Documentation
Architettura dell'indicizzazione
La documentazione Adobe descrive l'architettura di indicizzazione di Magento, compresi full indexing, partial indexing, MView, configurazione degli indexer e modalità di aggiornamento.
https://developer.adobe.com/commerce/php/development/components/indexing/
Creazione di custom indexer
Particolarmente utile per comprendere indexer.xml, mview.xml, executeRow(), executeList() ed executeFull().
https://developer.adobe.com/commerce/php/development/components/indexing/custom-indexer
Architettura del framework Adobe Commerce
Documentazione generale relativa al framework Commerce e ai suoi principali componenti architetturali.
https://developer.adobe.com/commerce/php/architecture/framework
Adobe Commerce Operations Documentation
Gestione degli indexer da CLI
Riferimento ufficiale per comandi come:
bin/magento indexer:status
bin/magento indexer:show-mode
bin/magento indexer:set-mode
bin/magento indexer:reindex
Index Management
Documentazione ufficiale relativa a Update on Save, Update by Schedule e gestione dello stato degli indexer.
https://experienceleague.adobe.com/en/docs/commerce-admin/systems/tools/index-management
Best practice per la configurazione degli indexer
Adobe raccomanda l'indicizzazione schedulata per i workload di produzione e analizza le implicazioni della configurazione degli indexer sulle performance.
Codice sorgente Magento 2
Per comprendere l'architettura a un livello ancora più profondo, il codice sorgente Magento rimane il riferimento definitivo.
Le aree particolarmente interessanti includono:
Magento\Framework\Mview
Magento\Framework\Indexer
Magento\Indexer
Magento\Catalog\Model\Indexer
Tra le classi e i componenti più utili da analizzare troviamo:
Magento\Framework\Mview\View
Magento\Framework\Mview\View\Subscription
Magento\Framework\Mview\View\Changelog
Magento\Framework\Indexer
Il codice sorgente è disponibile nel repository ufficiale Magento Open Source:
https://github.com/magento/magento2
Quando si analizza un indexer specifico è sempre consigliabile verificarne direttamente l'implementazione, perché non tutti gli indexer utilizzano esattamente la stessa strategia per tabelle temporanee, dimensioni, replica e table switching.
PHP 8.6 e Magento 2: cosa cambia davvero per sviluppatori e merchant
PHP continua il suo ciclo di evoluzione annuale e PHP 8.6 rappresenta il prossimo passo della piattaforma su cui si basa gran parte dell'ecosistema ecommerce.
Al momento della scrittura PHP 8.6 è ancora in fase Beta e la release stabile è prevista per novembre 2026. Non è quindi una versione da installare oggi su un ambiente Magento di produzione.
È però il momento giusto per iniziare a valutarne l'impatto.
Per Magento il passaggio a una nuova versione di PHP non riguarda infatti soltanto il core della piattaforma. Bisogna considerare almeno quattro livelli:
PHP → Magento → moduli di terze parti → codice custom
Ed è spesso negli ultimi due che emergono i problemi maggiori durante un upgrade.
Magento 2 supporta già PHP 8.6?
No.
Le attuali versioni della linea Magento Open Source / Adobe Commerce 2.4.8 supportano PHP 8.3 e PHP 8.4.
Questo significa che, anche se fosse tecnicamente possibile avviare Magento utilizzando PHP 8.6, una configurazione del genere non dovrebbe essere utilizzata in produzione fino al supporto ufficiale da parte di Adobe.
Il punto interessante è quindi un altro: quanto sarà complesso portare un progetto Magento esistente verso PHP 8.6 quando il supporto ufficiale arriverà?
La risposta dipenderà soprattutto dalla qualità del codice e delle estensioni installate.
Le novità di PHP 8.6
PHP 8.6 non sembra essere una release rivoluzionaria dal punto di vista sintattico. Prosegue piuttosto il percorso iniziato dalle precedenti versioni PHP 8.x: maggiore type safety, API più coerenti, controlli più rigorosi e progressiva eliminazione di comportamenti legacy.
Per Magento questo è particolarmente importante.
Magento è infatti un'applicazione PHP molto grande, fortemente object oriented e basata su Dependency Injection, Reflection, generated code, plugin, interceptor e un numero elevato di librerie Composer.
Piccole variazioni nel comportamento del linguaggio possono quindi avere effetti molto più evidenti rispetto a una normale applicazione PHP.
Partial Function Application
Una delle novità più interessanti di PHP 8.6 è la Partial Function Application.
Permette di creare callable partendo da funzioni o metodi esistenti lasciando alcuni argomenti da specificare successivamente.
Concettualmente permette di trasformare codice simile a:
$calculate = fn ($price) => calculateDiscount($price, 20);
in una forma nella quale PHP può costruire direttamente una funzione parzialmente applicata.
Per Magento non significa che dovremo improvvisamente riscrivere Service, Repository o ViewModel.
Può però risultare interessante nel codice applicativo che utilizza pipeline di trasformazione, collection processing, import/export o elaborazioni di catalogo.
Il beneficio principale è soprattutto una maggiore espressività del linguaggio.
clamp(): piccola funzione, molti casi d'uso ecommerce
PHP 8.6 introduce la funzione:
clamp($value, $min, $max);
che limita un valore all'interno di un intervallo.
Ad esempio:
$qty = clamp($requestedQty, 1, 100);
restituisce sempre un valore compreso tra 1 e 100.
In un progetto Magento situazioni di questo tipo sono frequenti:
$discount = max(0, min($discount, 100));
potrà diventare:
$discount = clamp($discount, 0, 100);
Possibili applicazioni riguardano quantità, percentuali di sconto, scoring, soglie, valori calcolati durante importazioni e normalizzazione di dati provenienti da sistemi esterni.
Non cambia l'architettura di Magento, ma rende più leggibile codice che oggi viene frequentemente implementato attraverso combinazioni di min() e max().
Nuovo enum SortDirection
PHP 8.6 introduce inoltre:
SortDirection::Ascending
SortDirection::Descending
La novità è interessante per Magento perché ordinamenti e collection sono presenti praticamente ovunque.
Nel codice Magento siamo abituati a valori come:
$collection->setOrder('created_at', 'DESC');
oppure a costanti e stringhe utilizzate per rappresentare ASC e DESC.
Il nuovo enum non sostituirà automaticamente le API Magento esistenti, ma rappresenta bene la direzione che PHP sta prendendo: ridurre progressivamente l'utilizzo di stringhe "magiche" in favore di costrutti tipizzati.
È un principio che vale anche nello sviluppo dei nuovi moduli Magento.
Readonly sempre più maturo
PHP 8.6 continua inoltre l'evoluzione delle proprietà readonly.
Per chi sviluppa Magento questo è interessante soprattutto nella costruzione di:
- DTO;
- Value Object;
- command;
- query object;
- oggetti utilizzati nelle integrazioni;
- strutture dati immutabili.
Un DTO moderno può essere molto più semplice rispetto alle classiche classi PHP utilizzate storicamente nell'ecosistema Magento.
Ad esempio:
final readonly class ProductData
{
    public function __construct(
        public string $sku,
        public string $name,
        public float $price
    ) {}
}
L'evoluzione del linguaggio rende sempre meno necessario scrivere grandi quantità di codice puramente infrastrutturale.
Miglioramenti alle Closure
PHP 8.6 introduce anche ottimizzazioni relative alle Closure.
È un cambiamento particolarmente interessante dal punto di vista delle performance, anche se non bisogna aspettarsi automaticamente un Magento "più veloce" semplicemente cambiando runtime.
Magento e le librerie che lo circondano fanno però largo uso di callback, Closure e callable.
Ogni miglioramento dell'engine in quest'area può quindi avere effetti interessanti soprattutto su applicazioni PHP molto grandi e con un numero elevato di operazioni per request.
La reale entità del miglioramento dovrà comunque essere misurata con benchmark Magento specifici.
Migliore gestione degli errori JSON
PHP 8.6 migliora anche le informazioni restituite quando json_decode() incontra JSON non valido, indicando con maggiore precisione dove si trova l'errore.
Può sembrare un dettaglio, ma in Magento il JSON è ovunque.
Pensiamo a:
- REST API;
- GraphQL;
- webhook;
- configurazioni;
- integrazioni ERP;
- marketplace;
- sistemi PIM;
- feed;
- code e sistemi asincroni.
Quando un sistema esterno invia payload molto grandi, sapere semplicemente che esiste un "Syntax error" non è particolarmente utile.
Una diagnostica più precisa può ridurre sensibilmente il tempo necessario per identificare payload malformati.
Il vero problema: le deprecazioni
La parte più importante di PHP 8.6 per un progetto Magento probabilmente non saranno le nuove feature.
Saranno le deprecazioni.
È una dinamica che abbiamo già visto durante le migrazioni:
PHP 7.4 → PHP 8.1 → PHP 8.2 → PHP 8.3 → PHP 8.4.
PHP sta diventando progressivamente più rigoroso e numerosi comportamenti storicamente tollerati vengono prima deprecati e successivamente eliminati.
Questo rappresenta un problema soprattutto per estensioni Magento datate.
Un'installazione Magento moderna può contenere decine di moduli provenienti da vendor differenti e migliaia di classi PHP custom.
Il fatto che il core Magento sia compatibile con una nuova versione di PHP non significa automaticamente che lo sia l'intero progetto.
Il problema delle estensioni Magento
Supponiamo di avere:
Magento / Adobe Commerce
│
├── Magento Core
├── Hyvä
├── Payment Provider
├── ERP Connector
├── Shipping Module
├── Search Module
├── Marketing Module
├── Feed Module
└── Custom Modules
Per dichiarare realmente un progetto compatibile con PHP 8.6 dobbiamo verificare tutti questi componenti.
Ed esiste un ulteriore livello:
Magento module
      ↓
Composer package
      ↓
Third-party library
Un modulo apparentemente compatibile potrebbe dipendere da una libreria che non lo è.
Per questo la verifica deve partire da Composer ma non può fermarsi a Composer.
Composer sarà il primo controllo
Quando Magento supporterà ufficialmente PHP 8.6, uno dei primi test da effettuare sarà:
composer why-not php 8.6
Il comando permette di individuare quali package impediscono l'utilizzo della nuova versione.
Potremmo trovare, ad esempio:
vendor/module-x
requires php ~8.2.0 || ~8.3.0
In questo caso il problema potrebbe non essere neppure il codice.
Il modulo potrebbe funzionare perfettamente con PHP 8.6, ma il relativo composer.json non permetterne l'installazione.
È una situazione molto comune durante gli upgrade Magento.
Static analysis prima dell'upgrade
Aspettare di aggiornare PHP in produzione per scoprire i problemi è l'approccio peggiore.
Una strategia migliore consiste nell'analizzare preventivamente il progetto con strumenti come:
PHPStan
PHP_CodeSniffer
PHPCompatibility
Composer
Magento Coding Standard
e successivamente eseguire test automatici sull'intero progetto.
L'obiettivo dovrebbe essere trasformare l'upgrade PHP da un'attività esplorativa a un processo verificabile.
Attenzione al rumore delle deprecazioni
Un altro problema tipico delle nuove versioni PHP è il numero di warning e deprecation generati da codice legacy.
In produzione possono avere conseguenze indirette.
Se vengono registrati migliaia di messaggi:
PHP Deprecated: ...
PHP Deprecated: ...
PHP Deprecated: ...
il problema non è soltanto estetico.
Può aumentare:
- I/O su disco;
- dimensione dei log;
- traffico verso sistemi di logging centralizzati;
- utilizzo CPU;
- costi di observability;
- difficoltà nell'individuare errori realmente importanti.
In sistemi Magento con traffico elevato una singola deprecation eseguita molte volte per request può trasformarsi rapidamente in milioni di righe di log.
PHP 8.6 renderà Magento più veloce?
È troppo presto per dirlo.
E soprattutto bisogna distinguere due concetti:
performance del runtime PHP
e
performance dell'applicazione Magento.
Magento dipende da molti altri componenti:
Browser
   ↓
CDN / Varnish
   ↓
Nginx
   ↓
PHP-FPM
   ↓
Magento
   ↓
Redis / Valkey
   ↓
MariaDB
   ↓
OpenSearch
Ridurre del 5% il tempo di esecuzione PHP non significa necessariamente ridurre del 5% il tempo di risposta percepito dall'utente.
Una request potrebbe trascorrere gran parte del proprio tempo aspettando MariaDB, Redis, OpenSearch o un servizio esterno.
Per questo i benchmark seri dovranno misurare almeno:
PHP 8.4 + Magento
vs
PHP 8.5 + Magento
vs
PHP 8.6 + Magento
utilizzando lo stesso database, dataset, configurazione PHP-FPM, cache e infrastruttura.
Quando aggiornare Magento a PHP 8.6?
Non appena PHP 8.6 sarà pubblicato?
No.
Il momento corretto sarà quando la propria versione Magento supporterà ufficialmente PHP 8.6 e l'intero stack applicativo sarà stato verificato.
La sequenza corretta dovrebbe essere:
PHP 8.6 Stable
        ↓
Supporto ufficiale Magento
        ↓
Verifica Composer dependencies
        ↓
Aggiornamento moduli
        ↓
Static analysis
        ↓
Unit / Integration tests
        ↓
Functional / E2E tests
        ↓
Staging
        ↓
Performance test
        ↓
Produzione
Saltare direttamente dal primo all'ultimo punto significa trasformare un normale aggiornamento tecnologico in un'attività ad alto rischio.
Conclusioni
PHP 8.6 non rivoluziona il modo in cui svilupperemo Magento 2, ma continua un processo molto più importante: la modernizzazione progressiva del linguaggio PHP.
Type safety, readonly objects, enum, API più coerenti, controlli più rigorosi e miglioramenti dell'engine stanno lentamente cambiando anche il modo in cui dovrebbe essere scritto il codice Magento.
Per chi gestisce installazioni Magento complesse il punto fondamentale, però, rimane un altro.
La compatibilità con una nuova versione PHP non è una proprietà di Magento: è una proprietà dell'intero progetto.
Core, moduli, librerie Composer, integrazioni e codice custom devono essere considerati come un unico sistema.
Per questo PHP 8.6 non è ancora qualcosa da installare sui server Magento di produzione.
È invece qualcosa che vale già la pena iniziare a testare nelle pipeline di sviluppo.
Perché il momento migliore per trovare un'incompatibilità con la prossima versione PHP non è durante l'upgrade.
È diversi mesi prima.
FAQ — PHP 8.6 e Magento 2
Magento 2 supporta già PHP 8.6?
No. Al momento PHP 8.6 non fa parte delle configurazioni ufficialmente supportate da Adobe Commerce o Magento Open Source.
Adobe Commerce 2.4.9 supporta ufficialmente PHP 8.5, mentre la linea 2.4.8 supporta PHP 8.3 e PHP 8.4.
Posso installare Magento 2 su PHP 8.6?
Tecnicamente è possibile iniziare a sperimentare con PHP 8.6 in ambienti di sviluppo, ma non è una configurazione da utilizzare in produzione.
Anche nel caso in cui Magento riesca ad avviarsi correttamente, potrebbero esserci incompatibilità nel core, nei moduli di terze parti o nelle dipendenze Composer.
È quindi opportuno attendere il supporto ufficiale da parte di Adobe.
Magento 2.4.8 sarà compatibile con PHP 8.6?
Attualmente Magento/Adobe Commerce 2.4.8 supporta PHP 8.3 e PHP 8.4.
Non è quindi possibile considerare PHP 8.6 una configurazione supportata per Magento 2.4.8.
Qual è la versione PHP supportata da Magento 2.4.9?
Adobe Commerce 2.4.9 supporta ufficialmente PHP 8.5.
PHP 8.4 è consentito da Adobe per il processo di upgrade, ma non è raccomandato come runtime di produzione per la versione 2.4.9.
Come posso verificare se un progetto Magento è pronto per PHP 8.6?
Un primo controllo può essere effettuato attraverso Composer:
composer why-not php 8.6
Questo permette di individuare le dipendenze che dichiarano un requisito PHP incompatibile.
Il controllo dovrebbe poi essere completato attraverso static analysis e test automatici utilizzando strumenti come PHPStan, PHP_CodeSniffer, PHPCompatibility, PHPUnit e test E2E.
Se Magento Core è compatibile con PHP 8.6, anche i moduli lo saranno?
Non necessariamente.
La compatibilità deve essere verificata sull'intero stack applicativo:
PHP
 ↓
Magento Core
 ↓
Moduli di terze parti
 ↓
Moduli custom
 ↓
Dipendenze Composer
Un singolo package non aggiornato può impedire l'upgrade oppure generare errori durante l'esecuzione.
PHP 8.6 renderà Magento più veloce?
Non necessariamente.
Gli eventuali miglioramenti del runtime PHP devono essere misurati nel contesto dell'intera architettura Magento.
Database, OpenSearch, Redis/Valkey, Varnish, servizi esterni e codice applicativo possono incidere sulle performance molto più del runtime PHP stesso.
Saranno quindi necessari benchmark specifici prima di poter quantificare eventuali vantaggi prestazionali.
Conviene prepararsi già adesso a PHP 8.6?
Sì, soprattutto per progetti Magento complessi.
Non significa utilizzare PHP 8.6 in produzione, ma mantenere aggiornate le dipendenze, eliminare codice deprecato, migliorare la copertura dei test e verificare periodicamente la compatibilità dei moduli.
In questo modo il futuro upgrade diventa un'attività pianificabile invece di un intervento emergenziale.
Fonti e approfondimenti
Per approfondire PHP 8.6 e la compatibilità con Magento consigliamo principalmente le fonti ufficiali PHP e Adobe.
PHP
- PHP — sito ufficiale
Release, documentazione e aggiornamenti sullo sviluppo del linguaggio.
https://www.php.net/ - PHP — Supported Versions
Ciclo di vita e supporto delle differenti versioni PHP.
https://www.php.net/supported-versions.php - PHP RFC
Le proposte ufficiali attraverso le quali vengono introdotte le nuove funzionalità e le modifiche al linguaggio.
https://wiki.php.net/rfc - PHP.Watch — PHP 8.6
Analisi tecnica delle nuove funzionalità, modifiche e deprecazioni introdotte da PHP 8.6.
https://php.watch/versions/8.6
Magento / Adobe Commerce
- Adobe Commerce — System Requirements
La fonte principale per verificare le combinazioni ufficialmente supportate di PHP, Composer, OpenSearch, MariaDB, Valkey, RabbitMQ e degli altri componenti dello stack.
https://experienceleague.adobe.com/en/docs/commerce-operations/installation-guide/system-requirements - Adobe Commerce 2.4.9 — Release Notes
Documentazione ufficiale della release 2.4.9, che introduce il supporto a PHP 8.5.
https://experienceleague.adobe.com/en/docs/commerce-operations/release/notes/adobe-commerce/2-4-9 - Adobe Commerce — Packages
Elenco delle dipendenze Composer utilizzate da Adobe Commerce.
https://experienceleague.adobe.com/en/docs/commerce-operations/release/packages/adobe-commerce - Magento Open Source — GitHub
Repository ufficiale del progetto Magento Open Source.
https://github.com/magento/magento2
Tool per verificare la compatibilità
- Composer
https://getcomposer.org/ - PHPStan
https://phpstan.org/ - PHPCompatibility
https://github.com/PHPCompatibility/PHPCompatibility - PHP_CodeSniffer
https://github.com/PHPCSStandards/PHP_CodeSniffer
Nota: PHP 8.6 è ancora in fase di sviluppo. Funzionalità, deprecazioni e dettagli implementativi possono cambiare prima della release stabile. Prima di qualsiasi aggiornamento di un ambiente Magento di produzione è necessario verificare i System Requirements ufficiali Adobe e la compatibilità di tutte le estensioni installate.
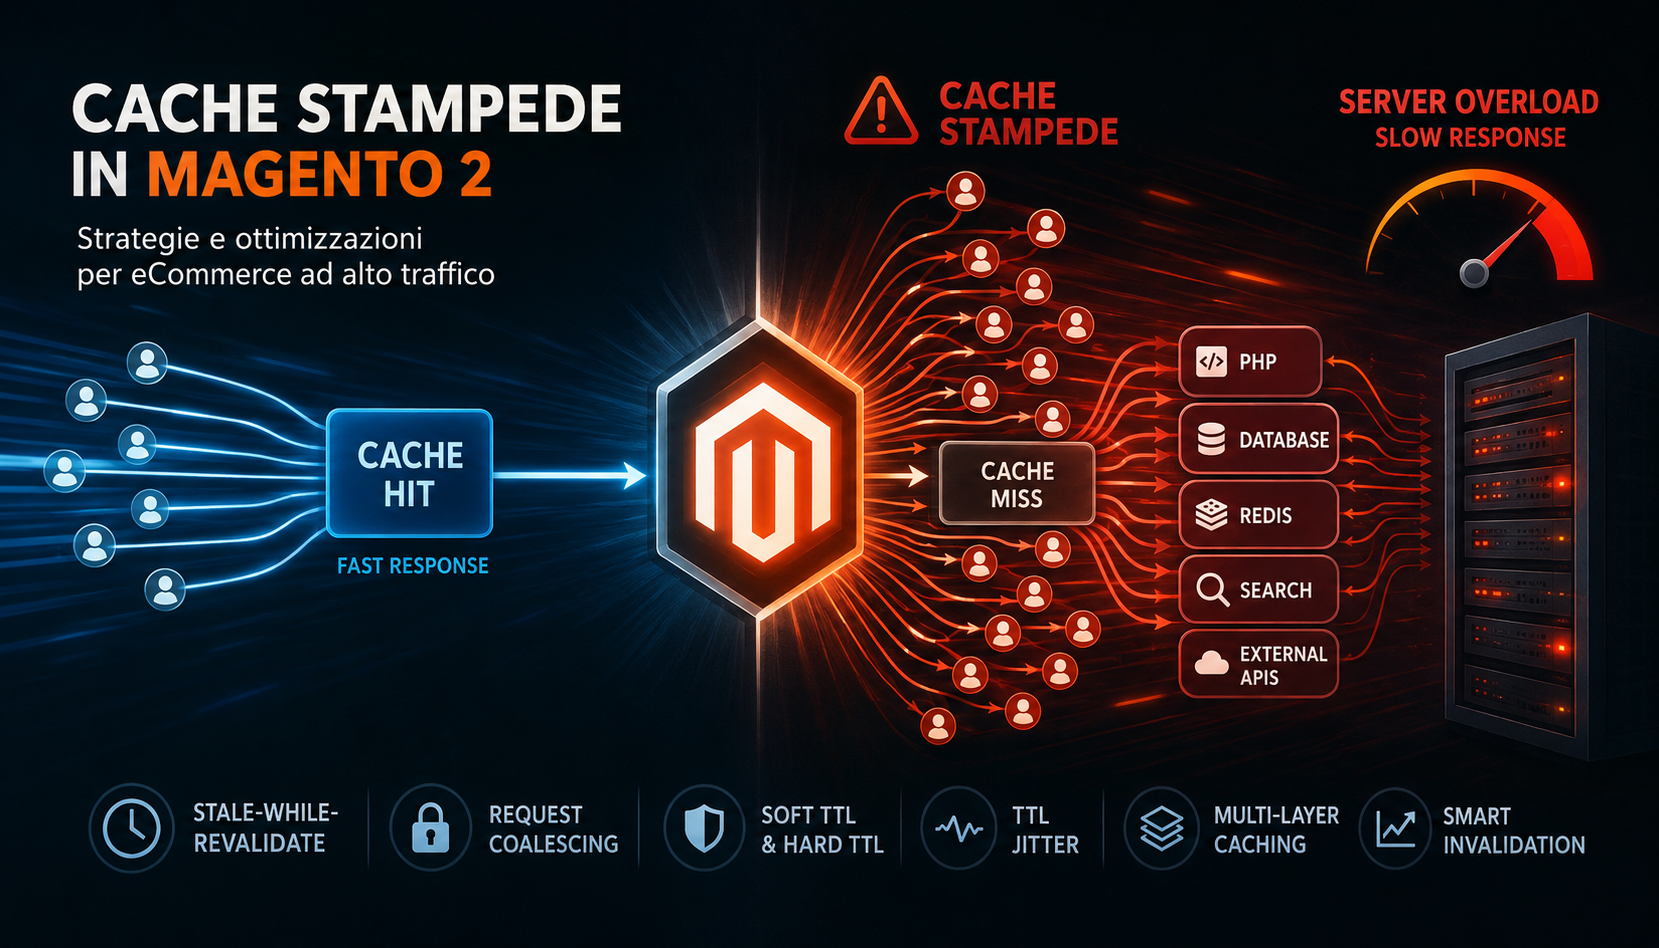
Cache Stampede in Magento 2: come progettare e ottimizzare eCommerce ad alto traffico
Quando si parla di performance in Magento 2, l'attenzione si concentra spesso su Redis, Varnish, database, OpenSearch e tempi di risposta PHP.
Nei progetti ad alto traffico, però, le performance non dipendono soltanto dalla velocità con cui il sistema risponde in condizioni normali. Un aspetto altrettanto importante è come l'infrastruttura reagisce quando una cache scade o viene invalidata mentre centinaia o migliaia di richieste stanno raggiungendo contemporaneamente lo stesso contenuto.
È il problema noto come Cache Stampede, chiamato anche Thundering Herd Problem.
In questo articolo vediamo come questo fenomeno si applica a Magento 2 e Adobe Commerce e quali strategie utilizziamo in Devlogica per progettare piattaforme eCommerce capaci di sostenere traffico elevato mantenendo tempi di risposta prevedibili.
Perché la cache è fondamentale in Magento 2
Magento dispone di un'architettura di caching multilivello.
In una tipica installazione production possiamo avere:
Browser
   │
   ▼
CDN
   │
   ▼
Varnish / Fastly
   │
   ▼
Nginx
   │
   ▼
PHP-FPM
   │
   ▼
Magento
   │
   ├── Redis / Valkey
   ├── OpenSearch
   └── MySQL
Adobe Commerce utilizza diversi tipi di cache applicativa per configurazione, layout, HTML block, collection e Full Page Cache. Per gli ambienti production on-premises Adobe raccomanda Varnish come Full Page Cache, mentre Adobe Commerce Cloud utilizza Fastly.
Quando tutte queste cache sono "calde", una piattaforma Magento correttamente progettata può gestire volumi di traffico molto elevati.
Il problema nasce durante le transizioni:
CACHE HIT
    ↓
CACHE INVALIDATION
    ↓
CACHE MISS
    ↓
CACHE REBUILD
    ↓
CACHE HIT
È proprio il periodo tra invalidation e rebuild che può diventare critico.
Cos'è una Cache Stampede
Immaginiamo una pagina prodotto molto visitata.
La pagina è presente nella Full Page Cache:
GET /prodotto-x
       │
       ▼
    Varnish
       │
       ▼
   CACHE HIT
       │
       ▼
   Response
Magento non viene praticamente coinvolto.
Supponiamo però che il prodotto venga modificato e che la relativa cache venga invalidata.
La richiesta successiva diventa:
GET /prodotto-x
       │
       ▼
    Varnish
       │
       ▼
   CACHE MISS
       │
       ▼
     Magento
       │
       ├── PHP
       ├── Cache
       ├── OpenSearch
       └── MySQL
Fin qui non c'è nulla di particolarmente problematico.
Ma cosa succede se quella pagina riceve 1.000 richieste quasi contemporaneamente?
Potenzialmente:
             CACHE INVALIDATED
                    │
                    ▼
              1000 requests
                    │
                    ▼
               CACHE MISS
                    │
        ┌───────────┼───────────┐
        ▼           ▼           ▼
     Magento     Magento     Magento
        │           │           │
       PHP         PHP         PHP
        │           │           │
      MySQL       MySQL       MySQL
Molte richieste cercano contemporaneamente di ricostruire informazioni che pochi millisecondi prima erano disponibili direttamente dalla cache.
Questo è il Cache Stampede.
Adobe stessa evidenzia che l'invalidazione della cache può aumentare i tempi di risposta perché, in assenza del dato cached, Commerce deve recuperare informazioni dal database, elaborarle e ricostruire la cache utilizzando maggiori risorse.
Perché il problema è particolarmente importante negli eCommerce
Il traffico di un eCommerce raramente è distribuito uniformemente.
Normalmente una piccola parte del catalogo genera una percentuale molto elevata delle richieste.
Pensiamo a:
- un prodotto appena lanciato;
- una promozione particolarmente aggressiva;
- una categoria durante Black Friday;
- un prodotto mostrato durante una campagna televisiva;
- una landing page utilizzata da una campagna advertising;
- prodotti diventati improvvisamente virali.
In questi casi abbiamo delle hot key, ovvero contenuti che ricevono una quantità di richieste enormemente superiore alla media.
Finché il dato è cached:
10.000 requests
       │
       ▼
     CACHE
       │
       ▼
10.000 responses
Il carico sull'application layer rimane minimo.
Quando la cache scompare improvvisamente, però, lo scenario può diventare:
10.000 requests
       │
       ▼
   CACHE MISS
       │
       ▼
Magento application layer
       │
       ▼
Database / OpenSearch / APIs
Il problema quindi non è necessariamente la capacità media del sistema.
È la capacità di assorbire improvvisi picchi di cache regeneration.
Strategia 1: Full Page Cache con Varnish
Il primo livello di protezione per un Magento ad alto traffico è evitare che richieste inutili raggiungano Magento.
Per installazioni on-premises, Adobe raccomanda esplicitamente Varnish per gli ambienti production perché la Full Page Cache integrata è significativamente meno performante.
L'architettura diventa:
              Internet
                  │
                  ▼
                 CDN
                  │
                  ▼
               Varnish
                  │
          ┌───────┴───────┐
          │               │
     CACHE HIT        CACHE MISS
          │               │
          ▼               ▼
      Response          Magento
L'obiettivo è semplice:
Magento dovrebbe elaborare soltanto le richieste che hanno realmente bisogno di Magento.
Su piattaforme ad alto traffico questo principio ha un impatto enorme sulla capacità complessiva del sistema.
Strategia 2: Stale-While-Revalidate
Una delle strategie più efficaci contro i Cache Stampede consiste nel non considerare immediatamente inutilizzabile un contenuto nel momento esatto in cui supera il TTL.
Supponiamo:
TTL = 5 minuti
Nell'approccio più semplice:
0 -------------------- 300s
        CACHE HIT

                         ↓

                     EXPIRED
                         ↓
                    CACHE MISS
Con un approccio stale-while-revalidate, invece:
0 ---------------- 300 ----------- 360
        FRESH             STALE
Tra 300 e 360 secondi il contenuto non è più considerato fresco, ma può ancora essere utilizzato temporaneamente mentre viene generata una nuova versione.
Il comportamento diventa:
Request
   │
   ▼
Cache expired?
   │
   YES
   │
   ▼
Serve stale content
   │
   └──────────────► regenerate cache
L'utente continua quindi a ricevere una risposta veloce mentre il sistema aggiorna il contenuto.
Varnish supporta questo modello tramite la Grace Mode. Adobe documenta che Varnish può servire temporaneamente un oggetto stale oltre il TTL mentre recupera una nuova versione dal backend, riducendo i tempi di caricamento e il traffico verso Commerce.
Per molte tipologie di contenuto eCommerce, qualche secondo di potenziale staleness è un compromesso molto migliore rispetto a sovraccaricare improvvisamente l'application layer.
Strategia 3: Request Coalescing
Un'altra tecnica estremamente importante è il Request Coalescing, chiamato anche single-flight.
L'idea è semplice.
Se 500 richieste richiedono contemporaneamente lo stesso dato non presente in cache, non è necessario che tutte e 500 lo rigenerino.
È sufficiente che lo faccia una sola richiesta.
500 requests
      │
      ▼
  CACHE MISS
      │
      ▼
 regeneration lock
      │
      ├── Request #1 → regenerate
      │
      ├── Request #2 ─┐
      ├── Request #3  │
      ├── Request #4  │ wait / stale
      │               │
      └── Request #500┘
Quando la prima richiesta termina:
Request #1
    │
    ▼
expensive operation
    │
    ▼
CACHE SET
    │
    ▼
499 requests → CACHE HIT
In questo modo il backend esegue una sola operazione costosa anziché centinaia di operazioni identiche.
Questa tecnica diventa particolarmente interessante per servizi applicativi, integrazioni, API, resolver GraphQL e dati aggregati costosi da generare.
Strategia 4: Soft TTL e Hard TTL
Non tutte le cache devono necessariamente avere un solo momento di scadenza.
Per alcuni dati utilizziamo concettualmente due soglie:
            Soft TTL             Hard TTL
               │                    │
───────────────┼────────────────────┼────────
    FRESH      │       STALE        │ INVALID
───────────────┴────────────────────┴────────
Il comportamento può quindi essere:
FRESH
  ↓
return immediately

STALE
  ↓
return cached data
  +
trigger refresh

INVALID
  ↓
force regeneration
Questa strategia evita che il sistema passi istantaneamente da:
100% CACHE HIT
a:
100% CACHE MISS
durante un picco di traffico.
Strategia 5: TTL Jitter
Un problema meno evidente si verifica quando molte cache vengono create contemporaneamente utilizzando lo stesso TTL.
Supponiamo di generare 50.000 elementi con:
TTL = 3600 secondi
Dopo esattamente un'ora potremmo avere:
50.000 cache entries
          │
          ▼
       EXPIRE
          │
          ▼
massive regeneration
Un approccio più robusto consiste nell'introdurre una piccola variazione casuale nel TTL:
TTL base = 3600
jitter   = ±300
ottenendo scadenze distribuite nel tempo:
55 min
57 min
59 min
61 min
63 min
65 min
Questo semplice accorgimento può ridurre significativamente i picchi di rigenerazione delle cache applicative.
Strategia 6: caching multilivello
Un'architettura Magento moderna non dovrebbe considerare la cache come un singolo componente.
La cache è una gerarchia:
Browser Cache
      │
      ▼
     CDN
      │
      ▼
Varnish / Fastly
      │
      ▼
Local application cache
      │
      ▼
Redis / Valkey
      │
      ▼
Database
Ogni livello deve intercettare le richieste prima che raggiungano quello più costoso.
Adobe Commerce supporta inoltre il caching L2 (two-level), nel quale ogni web node dispone di una cache locale mantenendo Redis o Valkey come cache remota condivisa.
Il principio è:
              Redis / Valkey
                    │
        ┌───────────┴───────────┐
        │                       │
     PHP #1                  PHP #2
        │                       │
   Local Cache              Local Cache
Questo riduce i round-trip verso il sistema di cache remoto.
La documentazione Adobe indica che una normale istanza Commerce può trasferire circa 300 KB di dati cache per richiesta e che, aumentando il numero di richieste, il traffico verso lo storage remoto può diventare significativo.
Per Adobe Commerce 2.4.9+, inoltre, Adobe introduce la moderna implementazione L2 basata su Symfony Cache e indica Valkey come backend per questa configurazione.
Strategia 7: ridurre le invalidazioni inutili
Una strategia spesso sottovalutata consiste nel non concentrarsi esclusivamente sulla velocità con cui ricostruiamo una cache.
Dobbiamo anche chiederci:
Perché la stiamo invalidando?
Una piattaforma può avere una cache estremamente veloce ma invalidarla troppo frequentemente.
In Magento è quindi importante analizzare:
UPDATE
   │
   ▼
Cache Tags
   │
   ▼
Invalidation
   │
   ▼
Varnish Purge
   │
   ▼
Regeneration
Quando Commerce esegue operazioni di clean, flush o refresh, anche gli oggetti interessati presenti in Varnish possono essere eliminati.
Su cataloghi molto grandi o siti con frequenti aggiornamenti di prodotto, prezzo e disponibilità, il design della strategia di invalidazione diventa quindi importante quanto il caching stesso.
Il vero obiettivo: proteggere il backend
Tutte queste strategie hanno in realtà lo stesso obiettivo.
Non si tratta semplicemente di ottenere:
Response time = 50 ms
invece di:
Response time = 100 ms
L'obiettivo è costruire un sistema nel quale un improvviso aumento del traffico non provochi questa catena:
Traffic spike
     ↓
Cache misses
     ↓
PHP saturation
     ↓
Database saturation
     ↓
Increasing latency
     ↓
More concurrent requests
     ↓
Further saturation
     ↓
OUTAGE
Questa dinamica può generare un effetto a cascata.
Una piattaforma progettata correttamente cerca invece di ottenere:
Traffic spike
     ↓
CDN / Varnish
     ↓
Cache protection
     ↓
Controlled regeneration
     ↓
Stable application layer
     ↓
Stable database
Non ottimizziamo solo la media: P95 e P99
Un altro errore comune nell'analisi delle performance consiste nel guardare esclusivamente il tempo medio di risposta.
Immaginiamo:
Average response: 120 ms
Può sembrare un risultato eccellente.
Ma potremmo avere:
P50    80 ms
P95   450 ms
P99  3200 ms
Il problema è quindi nascosto nella coda della distribuzione.
Gli utenti che arrivano durante una cache regeneration possono avere un'esperienza completamente diversa dagli altri.
Per questo nelle nostre analisi consideriamo anche:
Cache Hit Ratio

P50
P95
P99

Cache Miss Rate

Backend Response Time

PHP-FPM saturation

Database connections

Redis / Valkey latency

OpenSearch latency

Cache regeneration time
Le performance di un eCommerce ad alto traffico sono prima di tutto un problema di stabilità sotto carico, non soltanto di velocità.
Come Devlogica ottimizza Magento per siti ad alto traffico
In Devlogica affrontiamo l'ottimizzazione Magento partendo dall'architettura complessiva e non da singole micro-ottimizzazioni.
Un tipico processo di analisi considera diversi livelli.
1. Traffic analysis
Identifichiamo:
Hot Products
Hot Categories
Landing Pages
Traffic Peaks
API Traffic
GraphQL Traffic
Bot Traffic
L'obiettivo è capire dove viene realmente generato il carico.
2. Cache architecture
Analizziamo l'intera catena:
Browser
   ↓
CDN
   ↓
Varnish / Fastly
   ↓
Magento FPC
   ↓
Application Cache
   ↓
Redis / Valkey
Misuriamo cache hit ratio, TTL, invalidazioni e pattern di purge.
3. Application profiling
Individuiamo le operazioni Magento più costose:
Controllers
GraphQL resolvers
Plugins
Observers
Repositories
Collections
Database queries
External APIs
Una cache efficace non può compensare indefinitamente codice applicativo inefficiente.
4. Database analysis
Analizziamo:
slow queries
indexes
locks
connection saturation
query volume
read/write patterns
L'obiettivo è ridurre il numero di operazioni che raggiungono MySQL e rendere efficienti quelle inevitabili.
5. Cache invalidation analysis
Verifichiamo quali operazioni generano invalidazioni e quanto è ampio il loro impatto.
Cerchiamo situazioni come:
small data update
       ↓
large cache invalidation
       ↓
massive regeneration
che possono essere particolarmente costose durante i periodi di traffico elevato.
6. Load testing
Infine simuliamo condizioni realistiche:
Normal traffic

Traffic spike

Cold cache

Warm cache

Cache invalidation

Concurrent requests

High API traffic
Perché un sistema apparentemente veloce con cache completamente calda può comportarsi in maniera completamente diversa pochi secondi dopo un'invalidazione.
Performance Engineering, non semplicemente "Magento tuning"
Per noi l'ottimizzazione di Magento non significa modificare qualche parametro PHP o aumentare indiscriminatamente CPU e RAM.
Significa progettare il sistema affinché:
meno richieste
raggiungano Magento

meno richieste Magento
raggiungano il database

meno operazioni
vengano ripetute inutilmente

le cache
non scadano tutte contemporaneamente

le invalidazioni
abbiano un impatto controllato

i picchi di traffico
non diventino picchi infrastrutturali
L'obiettivo finale è ottenere un'architettura nella quale il costo di una richiesta diminuisce progressivamente man mano che aumenta il traffico servito dalla cache.
Conclusioni
Magento 2 e Adobe Commerce dispongono già di strumenti molto potenti per costruire piattaforme ad alte prestazioni: Full Page Cache, Varnish, Fastly, Redis/Valkey e caching L2.
La differenza tra una configurazione standard e una piattaforma realmente progettata per l'alto traffico, però, sta spesso nel modo in cui questi strumenti vengono utilizzati insieme.
Tecniche come:
- stale-while-revalidate;
- grace period;
- request coalescing;
- soft e hard TTL;
- TTL jitter;
- caching multilivello;
- controllo delle invalidazioni;
- profiling e load testing;
permettono di affrontare uno dei problemi più insidiosi dei sistemi distribuiti ad alto traffico: evitare che la perdita temporanea della cache trasferisca improvvisamente tutto il carico sull'application layer e sul database.
La domanda corretta quindi non è soltanto:
Quanto è veloce Magento quando la cache funziona?
Ma soprattutto:
Cosa succede alla piattaforma quando la cache viene invalidata mentre migliaia di utenti stanno effettuando richieste?
È proprio in questi scenari che una corretta attività di Performance Engineering fa la differenza tra un eCommerce semplicemente veloce e un eCommerce realmente scalabile.
Devlogica — Magento Performance & Scalability
Devlogica progetta, analizza e ottimizza piattaforme Magento 2 e Adobe Commerce ad alto traffico, intervenendo sull'intera architettura applicativa: caching, Varnish/Fastly, Redis/Valkey, PHP, MySQL, OpenSearch, GraphQL, integrazioni e infrastruttura.
Il nostro approccio parte dalla misurazione del comportamento reale della piattaforma, individua i colli di bottiglia e definisce una strategia di ottimizzazione orientata non soltanto alla velocità, ma soprattutto a scalabilità, stabilità e prevedibilità sotto carico.
Perché un eCommerce performante non deve essere veloce soltanto quando tutto funziona nelle condizioni ideali.
Deve continuare a esserlo quando arriva il traffico. Contattaci per una consulenza

Magento 2: perché un’architettura Docker potrebbe diventare lo standard
Magento resta una piattaforma estremamente potente per progetti e-commerce complessi, ma richiede un’infrastruttura solida, prevedibile e mantenibile.
Per questo stiamo valutando con interesse architetture basate su Docker, tra cui anche una possibile gestione remota tramite Dockhand. Non si tratta di una scelta già adottata in modo definitivo, ma di un’ipotesi tecnica interessante, da confrontare con altre soluzioni infrastrutturali.
Il punto centrale non è solo “usare Docker”. Il vero obiettivo è rendere Magento più semplice da distribuire, aggiornare, monitorare e proteggere nel tempo.
Perché Docker è interessante per Magento
Uno dei problemi storici di Magento è la complessità dell’ambiente applicativo.
Un progetto Magento moderno può includere:
- PHP-FPM;
- Nginx o Apache;
- MariaDB/MySQL;
- Redis;
- OpenSearch o Elasticsearch;
- RabbitMQ;
- cron;
- queue consumer;
- servizi di import/export;
- strumenti di deploy;
- sistemi di backup e monitoring.
Gestire tutto questo manualmente su server tradizionali può diventare fragile. Ogni ambiente rischia di essere leggermente diverso dagli altri: sviluppo, staging e produzione non sono mai perfettamente allineati.
Con Docker, invece, l’ambiente viene descritto come codice. Questo permette di avere configurazioni riproducibili, versionate e più facili da controllare.
Configurazione e ottimizzazione più semplici
Una stack Docker ben progettata consente di definire in modo chiaro versioni, servizi, variabili d’ambiente, volumi, network e dipendenze.
Questo è particolarmente utile in Magento, dove piccoli dettagli infrastrutturali possono avere un impatto importante sulle performance:
- versione di PHP;
- estensioni abilitate;
- configurazione di OPcache;
- parametri PHP-FPM;
- configurazione Redis;
- limiti di memoria;
- configurazione OpenSearch;
- cron e consumer;
- modalità developer, staging o production.
Avere tutto dichiarato riduce gli interventi manuali e rende più semplice replicare una configurazione stabile su più progetti.
Portabilità: eseguire Magento su qualsiasi host Linux
Un altro vantaggio importante è la portabilità.
Una stack containerizzata può essere eseguita su diversi provider o server Linux, riducendo il lock-in infrastrutturale. Questo significa poter valutare soluzioni come Hetzner, AWS, Azure, DigitalOcean, server dedicati o ambienti privati senza dover ripensare completamente l’architettura.
Per molte aziende questo è un tema strategico: non dipendere troppo da un singolo provider e mantenere il controllo sulla propria piattaforma e-commerce.
Sicurezza: isolamento e superfici ridotte
Docker non rende automaticamente sicura un’applicazione, ma permette di costruire un modello più ordinato.
Una configurazione corretta può prevedere:
- container isolati per ogni servizio;
- network privati non esposti pubblicamente;
- porte pubbliche limitate al reverse proxy;
- credenziali gestite tramite variabili o secret;
- permessi ridotti sui container;
- immagini aggiornate e controllate;
- separazione tra servizi applicativi, database e code;
- backup e restore più standardizzati.
Questo approccio riduce il rischio tipico delle installazioni “artigianali”, dove nel tempo si accumulano configurazioni manuali difficili da verificare.
Modularità: ogni componente può evolvere
Magento non vive da solo. Dipende da molti componenti esterni.
Una stack modulare permette di aggiornare o sostituire singoli servizi con minore impatto:
- aggiornare PHP da una versione all’altra;
- cambiare versione di MariaDB;
- sostituire Elasticsearch con OpenSearch;
- aggiungere RabbitMQ;
- introdurre un servizio di monitoring;
- aggiungere un worker dedicato agli import;
- separare cron e queue consumer;
- creare servizi dedicati per integrazioni ERP, PIM o marketplace.
Questa modularità è molto utile nei progetti e-commerce reali, dove l’architettura cresce nel tempo e deve adattarsi a nuove esigenze.
Integrazione con GitOps, CI/CD e servizi esterni
Un altro aspetto interessante è l’integrazione naturale con workflow moderni.
Una stack Docker può essere collegata a processi di:
- build automatica;
- deploy da Git;
- rollback;
- gestione dei branch;
- ambienti temporanei;
- aggiornamenti controllati;
- monitoring;
- alerting;
- backup automatici;
- gestione SSL;
- reverse proxy;
- logging centralizzato.
Qui strumenti come Dockhand possono diventare interessanti, perché promettono una gestione più semplice e remota degli stack, delle route, dei servizi e delle configurazioni.
Ma il principio rimane valido anche con altre soluzioni: l’infrastruttura deve diventare dichiarativa, versionabile e gestibile in modo prevedibile.
Cosa tenere presente
Docker non elimina la complessità. La sposta in un punto più controllabile.
Per adottare bene questo modello servono alcune attenzioni:
- immagini Docker mantenute e aggiornate;
- gestione corretta dei volumi persistenti;
- backup testati realmente;
- strategia chiara per database e media;
- monitoring delle risorse;
- gestione sicura dei secret;
- deploy senza downtime dove necessario;
- competenze DevOps adeguate;
- documentazione dello stack.
Una stack Docker improvvisata può creare problemi tanto quanto un server configurato male. La differenza la fa la qualità dell’architettura.
Docker, Dockhand o altre architetture?
Dockhand è una delle opzioni interessanti da valutare, soprattutto se l’obiettivo è gestire stack Docker in modo remoto, modulare e più semplice.
Tuttavia non è l’unica possibilità. A seconda del progetto si possono considerare anche:
- Docker Compose gestito internamente;
- Kubernetes;
- PaaS specializzati;
- hosting Magento managed;
- infrastrutture cloud native;
- server dedicati con automation custom.
La scelta dipende da budget, complessità del progetto, competenze interne, traffico, requisiti di sicurezza e necessità di controllo.
Il punto strategico
Dopo il 2026, la gestione di Magento dovrà essere sempre meno manuale e sempre più automatizzata.
Chi lavora su Adobe Commerce e Magento Open Source dovrebbe iniziare a trattare l’infrastruttura come parte del prodotto, non come un dettaglio tecnico secondario.
Un ambiente riproducibile, portabile e sicuro non è solo un vantaggio per gli sviluppatori. È un vantaggio diretto per il business: meno downtime, meno errori, deploy più rapidi, aggiornamenti più controllati e maggiore indipendenza tecnologica.
Conclusione
Migrare Magento verso una stack Docker gestita in modo moderno può essere una delle strade più interessanti per il futuro.
Dockhand rappresenta una possibile direzione, ma il messaggio più importante è più ampio:
essere proprietari della propria piattaforma e-commerce significa anche essere proprietari della propria infrastruttura.
La domanda non è soltanto quale tool usare, ma quale architettura permetta di far evolvere Magento in modo sostenibile, sicuro e controllato nei prossimi anni.

Magento lento? Il problema potrebbe non essere Magento
Quando un eCommerce Magento presenta tempi di caricamento elevati, la prima reazione è spesso la stessa:
"Magento è pesante."
Da qui iniziano discussioni su migrazioni, refactoring, nuovi temi, nuove infrastrutture o addirittura cambi di piattaforma.
Nella nostra esperienza, però, il problema raramente è Magento.
Molto più spesso le cause sono riconducibili a configurazioni errate, infrastrutture non ottimizzate, moduli sviluppati senza attenzione alle performance o processi che nel tempo hanno degradato l'efficienza della piattaforma.
Un caso reale
Recentemente siamo stati coinvolti nell'analisi di uno store Magento che presentava prestazioni molto basse secondo Lighthouse.
I risultati iniziali evidenziavano una situazione critica:
- Performance: 18
- Accessibility: 23
- Best Practices: 34
- SEO: 28
Una situazione di questo tipo non rappresenta soltanto un problema tecnico.
Ha un impatto diretto su:
- Esperienza utente
- Posizionamento organico sui motori di ricerca
- Tasso di conversione
- Costo delle campagne advertising
- Capacità di gestire picchi di traffico
Dopo un intervento di ottimizzazione strutturato, i risultati sono cambiati radicalmente:
- Performance: 98
- Accessibility: 96
- Best Practices: 100
- SEO: 100
Il tutto senza modificare il core di Magento e senza affrontare un progetto di replatforming.
Dove si nascondono realmente i problemi
Molte aziende investono decine di migliaia di euro nello sviluppo di nuove funzionalità senza rendersi conto che il collo di bottiglia si trova altrove.
Tra le problematiche che incontriamo più frequentemente troviamo:
Configurazioni server non ottimizzate
Una configurazione errata di Nginx, Apache, PHP-FPM o del database può compromettere gravemente le prestazioni dell'intero store.
Spesso troviamo:
- Pool PHP mal configurati
- Compressione assente o inefficiente
- Cache non sfruttate correttamente
- Risorse hardware sottoutilizzate
Caching inefficace
Magento dispone di un sistema di caching estremamente avanzato.
Tuttavia è frequente trovare installazioni dove:
- Varnish non è configurato correttamente
- Full Page Cache non viene sfruttata
- Blocchi dinamici invalidano inutilmente la cache
- CDN assenti o mal configurate
Moduli di terze parti
Molti problemi di performance derivano da estensioni installate nel tempo.
In particolare:
- Query SQL inefficienti
- Observer eseguiti ad ogni richiesta
- API esterne chiamate in modo sincrono
- Caricamento eccessivo di JavaScript
Frontend e Core Web Vitals
Negli ultimi anni Google ha dato sempre maggiore importanza ai Core Web Vitals.
Tra le criticità più comuni troviamo:
- Immagini non ottimizzate
- JavaScript bloccante
- Font caricati in modo inefficiente
- Layout Shift elevato
- Temi custom privi di ottimizzazioni moderne
Perché la velocità è un investimento
Un sito veloce non migliora soltanto il punteggio Lighthouse.
Produce risultati concreti sul business.
Tra i principali benefici:
Maggiore conversione
Gli utenti acquistano di più quando il sito risponde rapidamente.
Migliore SEO
Google premia le esperienze utente migliori e le performance sono uno dei fattori considerati.
Minore abbandono
Ogni secondo di attesa aumenta la probabilità che l'utente lasci il sito.
Migliore ritorno sugli investimenti marketing
Portare traffico su un sito lento significa sprecare parte del budget advertising.
Quando serve davvero una migrazione?
Una domanda che riceviamo spesso è:
"Dobbiamo cambiare piattaforma?"
Nella maggior parte dei casi la risposta è no.
Prima di valutare una migrazione è fondamentale comprendere:
- Dove si trovano i colli di bottiglia
- Quali processi stanno degradando le prestazioni
- Quali interventi possono generare il maggiore ritorno sull'investimento
Spesso un audit tecnico approfondito evidenzia margini di miglioramento enormi ottenibili con investimenti molto inferiori rispetto a una migrazione completa.
Il nostro approccio
In DevLogica affrontiamo le performance Magento con un approccio basato sui dati.
Analizziamo:
- Infrastruttura
- Database
- Configurazione Magento
- Cache
- Frontend
- Core Web Vitals
- Estensioni di terze parti
L'obiettivo non è ottenere un numero più alto su Lighthouse.
L'obiettivo è rendere lo store più veloce, più stabile e più profittevole.
Conclusioni
Se il tuo Magento è lento, non dare per scontato che il problema sia Magento.
Nella maggior parte dei casi esistono opportunità di ottimizzazione che possono migliorare drasticamente le prestazioni senza dover affrontare costosi progetti di riscrittura o migrazione.
Prima di investire in una nuova piattaforma, assicurati di conoscere davvero quali sono le cause dei rallentamenti.
Potresti scoprire che la soluzione è molto più semplice di quanto immagini.
Vuoi sapere come sta performando il tuo Magento?
Contattaci per un audit tecnico delle performance.
Analizzeremo la tua piattaforma e individueremo le aree di miglioramento che possono avere il maggiore impatto su conversioni, SEO ed esperienza utente.

Magento 2 Enterprise Architecture: dall'architettura AWS ufficiale a una soluzione sostenibile su Hetzner
Introduzione
Quando si parla di architetture Magento 2 scalabili, uno dei riferimenti più interessanti è il whitepaper AWS dedicato a Magento Open Source e Adobe Commerce.
L'architettura proposta da AWS rappresenta un modello enterprise moderno, progettato per garantire:
- Alta disponibilità
- Scalabilità orizzontale
- Disaster recovery
- Ridondanza multi-zona
- Performance elevate
Tuttavia, per molte aziende di medie dimensioni, il costo operativo di una simile infrastruttura può risultare sproporzionato rispetto ai reali requisiti di business.
La domanda diventa quindi:
È possibile ottenere gli stessi benefici architetturali senza sostenere i costi di AWS?
La risposta è sì.
In questo articolo analizzeremo l'architettura AWS ufficiale e mostreremo come realizzare una soluzione equivalente utilizzando Hetzner Cloud.
L'architettura AWS di riferimento
L'architettura AWS prevede diversi livelli di separazione.
Layer di distribuzione
- CloudFront (CDN)
- Elastic Load Balancer
Obiettivo:
- ridurre la latenza
- distribuire il traffico
- assorbire picchi improvvisi
Layer di cache
- Varnish
Funzioni:
- cache delle pagine
- riduzione del carico PHP
- miglioramento del TTFB
Layer applicativo
Cluster Magento composto da più nodi.
Ogni nodo esegue:
- Nginx
- PHP-FPM
- Magento
I nodi sono inseriti in Auto Scaling Group.
Layer servizi
Magento utilizza:
Redis
Per:
- sessioni
- cache
- full page cache
RabbitMQ
Per:
- code asincrone
- import/export
- indicizzazione
OpenSearch
Per:
- catalogo
- ricerca
- filtri
Layer dati
AWS propone:
- Amazon RDS
- Aurora MySQL
- replica asincrona
Layer storage
Amazon S3 viene utilizzato per:
- immagini prodotto
- allegati
- media Magento
Il problema reale
Questa architettura è eccellente.
Ma spesso viene adottata da aziende che:
- gestiscono meno di 500 ordini al giorno
- hanno cataloghi inferiori a 100.000 SKU
- non registrano picchi superiori a qualche centinaio di utenti contemporanei
In questi casi il costo infrastrutturale può facilmente superare diverse migliaia di euro al mese.
Molte PMI finiscono per pagare capacità che non utilizzeranno mai.
Una proposta alternativa: Hetzner Cloud
Hetzner offre oggi componenti sufficientemente maturi per realizzare una piattaforma Magento altamente affidabile.
La nostra architettura di riferimento è la seguente.
Cloudflare
      │
Hetzner Load Balancer
      │
 ┌──────────────┐
 │   Varnish    │
 │   Varnish    │
 └──────────────┘
      │
 ┌──────────────┐
 │ Magento Node │
 │ Magento Node │
 └──────────────┘
      │
 ┌──────────────┐
 │ Redis        │
 │ RabbitMQ     │
 │ OpenSearch   │
 └──────────────┘
      │
 ┌──────────────┐
 │ MariaDB HA   │
 │ Replica      │
 └──────────────┘
      │
Object Storage S3
Mapping AWS → Hetzner
| AWS | Hetzner |
|---|---|
| CloudFront | Cloudflare |
| ELB | Hetzner Load Balancer |
| EC2 | Hetzner Cloud Server |
| Auto Scaling Group | Terraform + Ansible |
| ElastiCache Redis | Redis dedicato |
| Amazon MQ | RabbitMQ dedicato |
| OpenSearch Service | OpenSearch dedicato |
| RDS MySQL | MariaDB/MySQL dedicato |
| S3 | Hetzner Object Storage |
Il valore dei dati
Uno degli errori più comuni nei progetti ecommerce è concentrarsi esclusivamente sul frontend.
La vera ricchezza di Magento non è il tema grafico.
Sono i dati.
- ordini
- clienti
- prodotti
- disponibilità
- prezzi
- promozioni
- integrazioni ERP
- cronologia acquisti
Una piattaforma proprietaria come Magento permette di mantenere il pieno controllo di questo patrimonio informativo.
A differenza di molte piattaforme SaaS (come ad esempio Shopify), l'azienda conserva:
- accesso completo al database
- possibilità di analisi avanzate
- integrazione con sistemi BI
- processi personalizzati
- automazioni proprietarie
L'infrastruttura deve essere progettata per proteggere e valorizzare questi dati.
Quando serve davvero AWS?
AWS rimane la scelta ideale quando:
- si gestiscono milioni di visite mensili
- si opera in più continenti
- esistono requisiti stringenti di compliance
- sono richiesti SLA enterprise
- il team DevOps è già orientato all'ecosistema AWS
Quando Hetzner è la scelta migliore?
Hetzner rappresenta una soluzione estremamente competitiva per:
- PMI
- aziende B2B
- ecommerce tra 1 e 20 milioni di fatturato
- cataloghi medio-grandi
- team tecnici con competenze Magento
In questi scenari è possibile ottenere performance elevate, alta affidabilità e costi operativi molto più contenuti.
Conclusioni
L'architettura AWS proposta da Adobe e Amazon rappresenta un eccellente modello di riferimento.
Tuttavia, non tutte le aziende necessitano dell'intero ecosistema AWS.
Per molte realtà, una piattaforma costruita su Hetzner Cloud, Cloudflare e componenti open source come Redis, RabbitMQ e OpenSearch permette di raggiungere livelli di affidabilità e performance molto simili, mantenendo un controllo completo sui dati e riducendo drasticamente il costo totale di proprietà.
La domanda non dovrebbe essere:
"Possiamo permetterci AWS?"
Ma piuttosto:
"Qual è l'architettura più efficiente per il nostro business?"
Contattaci se vuoi migliorare la tua architettura server