Consulente Adobe Commerce: guida completa per scegliere l’esperto giusto
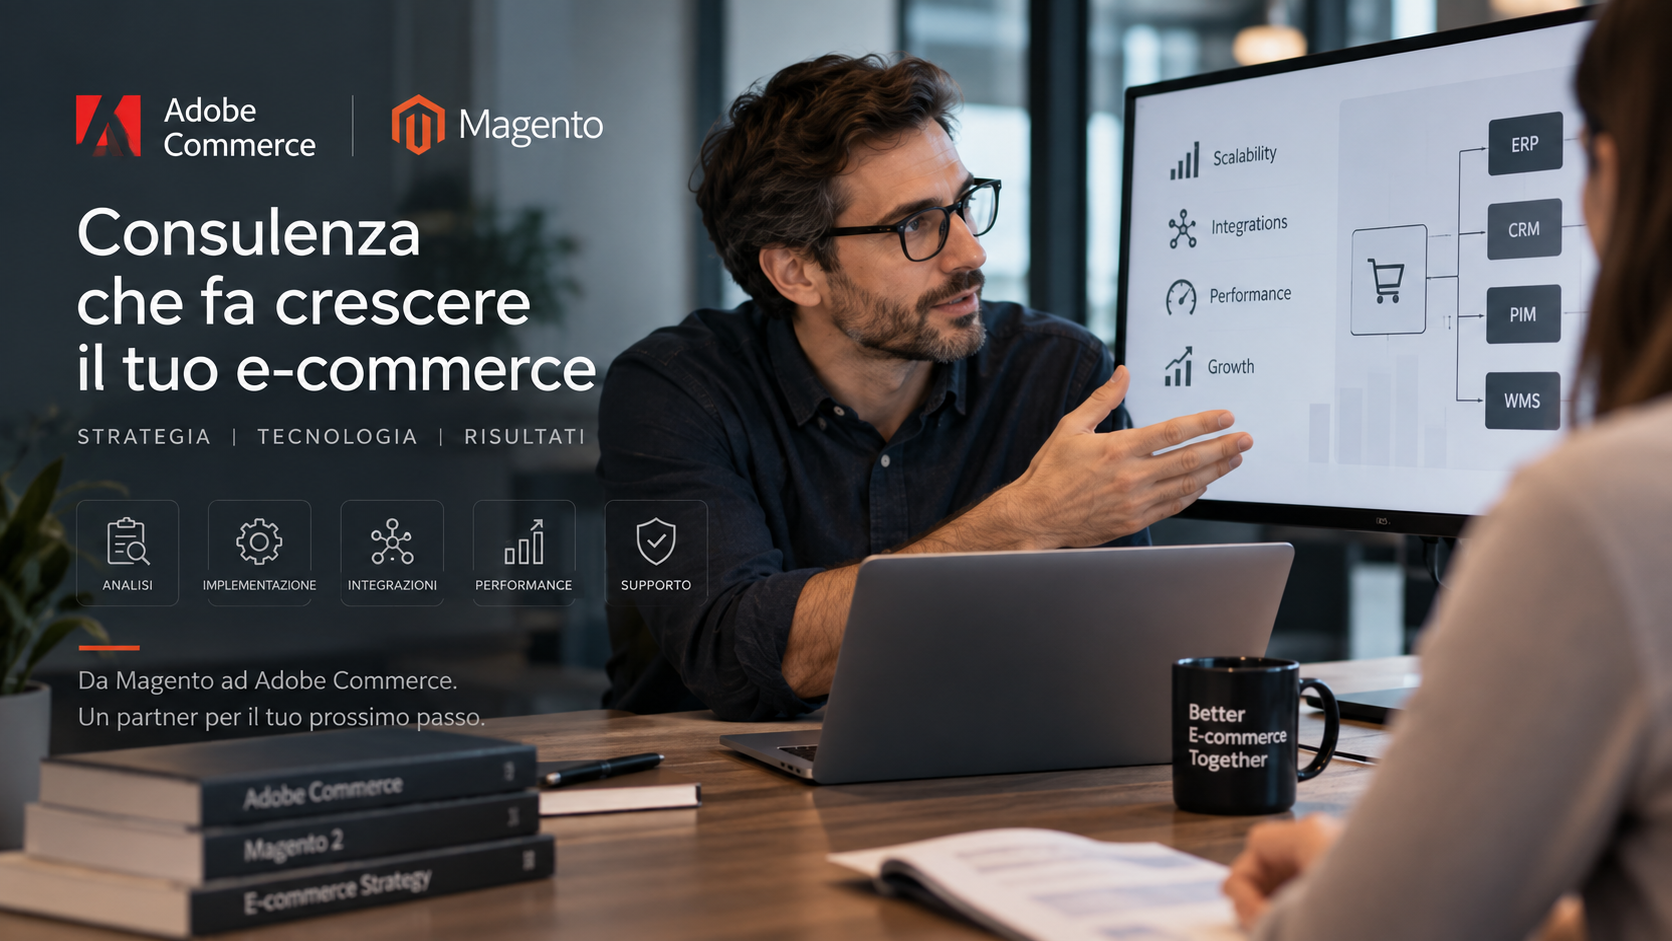
Adobe Commerce è una piattaforma e-commerce pensata per progetti complessi, nei quali catalogo, prezzi, promozioni, integrazioni, logistica e processi aziendali devono funzionare come un unico ecosistema.
La flessibilità della piattaforma è uno dei suoi principali punti di forza, ma comporta anche una notevole complessità tecnica.
Quando un progetto cresce, affidarsi semplicemente a uno sviluppatore Magento può non essere sufficiente. Diventa importante avere una figura capace di analizzare l'intera architettura, comprendere le esigenze di business e tradurle in soluzioni tecniche sostenibili.
È qui che entra in gioco il consulente Adobe Commerce.
In questa guida vediamo cosa fa, quali competenze dovrebbe avere, quali servizi può offrire e soprattutto come scegliere il partner giusto per un progetto Adobe Commerce o Magento.
Chi è un consulente Adobe Commerce
Un consulente Adobe Commerce è un professionista specializzato nella progettazione, implementazione, evoluzione e ottimizzazione di piattaforme e-commerce basate su Adobe Commerce e Magento.
Il suo ruolo non coincide necessariamente con quello di un developer.
Uno sviluppatore si concentra principalmente sull'implementazione tecnica: moduli, API, frontend, personalizzazioni e bug fixing.
Il consulente Adobe Commerce deve invece avere una visione più ampia dell'ecosistema.
Deve essere in grado di comprendere:
- architettura della piattaforma;
- processi commerciali;
- catalogo e pricing;
- integrazioni con ERP e sistemi gestionali;
- CRM;
- PIM;
- sistemi di pagamento;
- logistica e fulfillment;
- marketplace;
- infrastruttura cloud;
- performance;
- sicurezza;
- processi di sviluppo e deployment.
In progetti particolarmente articolati il consulente può inoltre lavorare insieme a solution architect, developer, DevOps, project manager e specialisti UX.
Il suo compito principale è assicurarsi che le scelte tecniche siano coerenti con gli obiettivi del business e con l'evoluzione futura della piattaforma.
Adobe Commerce e Magento: perché serve una consulenza specializzata
Adobe Commerce deriva da Magento e ne mantiene l'architettura e gran parte dell'ecosistema tecnologico.
Questo significa lavorare con una piattaforma estremamente flessibile, ma anche con un sistema nel quale decisioni apparentemente semplici possono avere conseguenze importanti.
Un modulo sviluppato male, ad esempio, può aumentare drasticamente i tempi di risposta del sito.
Una sincronizzazione ERP progettata senza considerare volumi e concorrenza può generare problemi durante l'aggiornamento di migliaia di prodotti.
Una personalizzazione eccessiva del core può rendere più complessi gli aggiornamenti futuri.
Una strategia di caching non corretta può annullare i benefici di un'infrastruttura performante.
Per questo una buona consulenza Adobe Commerce non dovrebbe limitarsi alla domanda:
"Come sviluppiamo questa funzionalità?"
La domanda corretta spesso è:
"Qual è il modo più semplice, robusto e scalabile per soddisfare questo requisito?"
La differenza può incidere significativamente sul costo totale della piattaforma nel corso degli anni.
Competenze essenziali di un consulente Adobe Commerce
Un consulente Adobe Commerce dovrebbe possedere competenze che vanno oltre lo sviluppo Magento tradizionale.
Conoscenza approfondita di Magento e Adobe Commerce
È fondamentale conoscere l'architettura della piattaforma e i suoi principali meccanismi:
- Dependency Injection;
- plugin e observer;
- cron e message queue;
- indexer;
- cache;
- GraphQL;
- REST API;
- database;
- catalogo;
- checkout;
- ordini;
- pagamenti;
- promozioni;
- customer management;
- Multi Source Inventory;
- store view e configurazioni multi-store.
Questa conoscenza permette di distinguere tra ciò che può essere ottenuto tramite configurazione e ciò che richiede realmente uno sviluppo custom.
Sviluppo e personalizzazione
Quando la piattaforma standard non è sufficiente, il consulente deve saper progettare estensioni mantenibili e compatibili con l'architettura Magento.
Un principio fondamentale dovrebbe essere:
personalizzare solo quando esiste una reale necessità di business.
Ridurre il codice custom significa generalmente diminuire costi di manutenzione, rischi e complessità degli upgrade.
Integrazioni
Nei progetti enterprise Adobe Commerce raramente funziona come sistema isolato.
È normalmente necessario integrarlo con altri sistemi:
- ERP;
- CRM;
- PIM;
- WMS;
- OMS;
- sistemi di pagamento;
- corrieri;
- marketplace;
- sistemi marketing;
- sistemi di customer care;
- piattaforme di Business Intelligence.
Il consulente deve quindi avere esperienza nella progettazione di API, code asincrone, webhook, middleware e sistemi di sincronizzazione.
Performance
Un e-commerce lento può avere conseguenze dirette sull'esperienza utente e sulle conversioni.
Un consulente Adobe Commerce deve essere in grado di analizzare elementi come:
- query SQL;
- indexer;
- cron;
- cache;
- Full Page Cache;
- Redis;
- OpenSearch;
- PHP;
- code asincrone;
- API;
- GraphQL;
- frontend;
- infrastruttura.
L'obiettivo non è semplicemente avere server più potenti, ma individuare dove si trova realmente il collo di bottiglia.
DevOps e processi di rilascio
Un progetto Adobe Commerce moderno dovrebbe disporre di processi strutturati di sviluppo e deployment.
Tra gli elementi da valutare troviamo:
- Git;
- CI/CD;
- ambienti separati;
- automated testing;
- deployment ripetibili;
- monitoring;
- logging;
- rollback strategy.
Una pipeline corretta riduce il rischio associato ai rilasci e permette al team di evolvere la piattaforma più rapidamente.
Servizi offerti da un consulente Adobe Commerce
La consulenza può intervenire in diverse fasi del ciclo di vita di una piattaforma.
Assessment Adobe Commerce
Un assessment tecnico permette di analizzare lo stato corrente del progetto.
Può includere:
- architettura;
- qualità del codice;
- moduli custom;
- estensioni di terze parti;
- performance;
- sicurezza;
- infrastruttura;
- processi di deployment;
- integrazioni;
- database;
- cron;
- indicizzazione;
- debito tecnico.
Il risultato dovrebbe essere un documento operativo con problemi identificati, priorità, rischi e possibili interventi.
Non semplicemente una lista di errori.
Implementazione Adobe Commerce
Per un nuovo progetto il consulente può supportare il cliente nella definizione dell'architettura prima dell'inizio dello sviluppo.
Questo significa identificare:
- requisiti;
- componenti;
- integrazioni;
- responsabilità dei diversi sistemi;
- flussi dati;
- strategia infrastrutturale;
- modalità di deployment;
- roadmap.
Una corretta progettazione iniziale può evitare costose revisioni architetturali successive.
Migrazione Magento e Adobe Commerce
Una migrazione può riguardare differenti scenari:
- Magento Open Source verso Adobe Commerce;
- Magento 1 verso Magento 2;
- upgrade di versioni Magento obsolete;
- migrazione da altre piattaforme e-commerce;
- replatforming verso una nuova architettura.
La migrazione deve considerare non soltanto prodotti e clienti, ma anche ordini, URL, SEO, integrazioni, moduli custom e processi aziendali.
Integrazione con sistemi esterni
Uno degli ambiti nei quali la consulenza specialistica offre maggiore valore è la progettazione delle integrazioni.
Un Adobe Commerce enterprise può scambiare continuamente informazioni relative a:
Catalogo
ERP/PIM → Adobe Commerce
Disponibilità
ERP/WMS → Adobe Commerce
Ordini
Adobe Commerce → ERP/OMS
Spedizioni
ERP/WMS → Adobe Commerce
Clienti
Adobe Commerce ↔ CRM
Marketplace
Adobe Commerce ↔ Amazon/eBay/altri canali
Quando i volumi aumentano, è importante progettare correttamente sincronizzazioni, retry, idempotenza, logging e gestione degli errori.
Consulenza strategica vs implementazione tecnica
Non tutti gli interventi richiedono sviluppo.
È utile distinguere tra consulenza strategica e implementazione tecnica.
Consulenza strategica
La consulenza strategica può riguardare:
- analisi dell'architettura;
- technology selection;
- roadmap;
- definizione delle priorità;
- valutazione make-or-buy;
- riduzione del debito tecnico;
- scalabilità;
- revisione dei processi;
- strategia di integrazione.
Il deliverable può essere una roadmap tecnica con attività organizzate per impatto, rischio, costo e priorità.
Implementazione tecnica
L'implementazione riguarda invece la realizzazione concreta degli interventi:
- sviluppo moduli;
- API;
- integrazioni;
- checkout;
- GraphQL;
- frontend;
- migrazioni;
- performance optimization;
- upgrade;
- automazioni.
Nei progetti più efficaci le due attività lavorano insieme.
Prima si identifica cosa conviene fare, poi si definisce come implementarlo.
Come scegliere il consulente Adobe Commerce giusto
La scelta non dovrebbe essere basata esclusivamente sulla tariffa giornaliera.
È più utile valutare alcuni elementi concreti.
Esperienza reale su Magento e Adobe Commerce
È importante verificare che il consulente abbia lavorato su progetti reali e possibilmente complessi.
Un progetto con catalogo ridotto e poche integrazioni presenta problematiche molto diverse da una piattaforma con centinaia di migliaia di SKU, più store e numerosi sistemi esterni.
Esperienza sulle integrazioni
Chiedete quali sistemi il consulente ha già integrato.
L'esperienza con ERP, PIM, CRM, marketplace, sistemi logistici e sistemi di pagamento è spesso più importante della conoscenza di una singola estensione Magento.
Certificazioni Adobe
Le certificazioni Adobe rappresentano un elemento utile per verificare la conoscenza della piattaforma.
Non devono però essere l'unico criterio.
La combinazione ideale è:
certificazione + esperienza concreta + capacità architetturale.
Metodo di lavoro
Chiedete come viene affrontato un nuovo requisito.
Un buon consulente dovrebbe iniziare dall'analisi del problema prima di proporre lo sviluppo.
Dovrebbe inoltre essere in grado di spiegare:
- alternative;
- costi;
- rischi;
- impatto sugli upgrade;
- impatto sulle performance;
- manutenzione futura.
Capacità di comunicazione
Una parte importante del lavoro consiste nel trasformare problemi tecnici complessi in decisioni comprensibili.
Il consulente deve riuscire a comunicare efficacemente sia con gli sviluppatori sia con stakeholder non tecnici.
ROI e benefici della consulenza Adobe Commerce
Misurare il ROI di una consulenza tecnologica significa guardare oltre il costo iniziale dell'intervento.
I benefici possono derivare da diverse aree.
Riduzione dei costi operativi
Automatizzare processi manuali e correggere integrazioni inefficienti può ridurre significativamente il lavoro operativo necessario per gestire l'e-commerce.
Riduzione del time-to-market
Un'architettura corretta e processi di deployment efficienti permettono di rilasciare nuove funzionalità più rapidamente.
Migliori performance
Ottimizzare backend, database, cache e frontend può migliorare i tempi di risposta della piattaforma e l'esperienza degli utenti.
Maggiore scalabilità
L'architettura deve poter gestire l'aumento di:
- traffico;
- ordini;
- prodotti;
- marketplace;
- store;
- integrazioni.
Senza richiedere continue riprogettazioni.
Riduzione del rischio
Aggiornamenti mancanti, dipendenze obsolete, moduli non mantenuti e personalizzazioni invasive rappresentano rischi tecnici.
Una roadmap di manutenzione permette di affrontarli in modo progressivo.
Quando richiedere una consulenza Adobe Commerce
Alcuni segnali indicano chiaramente che può essere utile effettuare un assessment specialistico:
- Magento è diventato progressivamente più lento;
- gli aggiornamenti sono difficili o rischiosi;
- il progetto contiene molto codice custom;
- gli import richiedono troppo tempo;
- ERP e Magento spesso non risultano sincronizzati;
- gli ordini richiedono interventi manuali;
- esistono frequenti problemi dopo i deployment;
- il team ha difficoltà a individuare la causa dei problemi;
- si sta pianificando una migrazione;
- si vuole introdurre un nuovo ERP, PIM, WMS o marketplace;
- l'e-commerce deve crescere significativamente nei prossimi anni.
In questi casi può essere più conveniente iniziare con un assessment circoscritto anziché avviare immediatamente un grande progetto di sviluppo.
Devlogica: consulenza Adobe Commerce e Magento
Devlogica lavora su progetti Magento e Adobe Commerce, affiancando aziende e team tecnici nello sviluppo e nell'evoluzione di piattaforme e-commerce complesse.
Il nostro approccio parte dall'analisi dell'ecosistema nel suo complesso.
Non consideriamo Adobe Commerce come un'applicazione isolata, ma come un componente dell'architettura digitale aziendale.
Lavoriamo su aree come:
- sviluppo Magento 2 e Adobe Commerce;
- architettura e code review;
- sviluppo di moduli custom;
- integrazioni ERP;
- API REST e GraphQL;
- sistemi PIM;
- marketplace;
- sistemi logistici;
- performance optimization;
- upgrade Magento;
- automazione dei processi;
- CI/CD;
- testing automatico;
- supporto e manutenzione evolutiva.
L'obiettivo è costruire soluzioni che non funzionino soltanto al momento del rilascio, ma che rimangano manutenibili, aggiornabili e scalabili nel tempo.
Hai un progetto Adobe Commerce da valutare?
Se stai sviluppando una nuova piattaforma, devi aggiornare un'installazione Magento esistente oppure stai affrontando problemi di performance, integrazione o scalabilità, un assessment tecnico può essere il punto di partenza.
Possiamo analizzare l'architettura esistente, individuare criticità e debito tecnico e definire una roadmap di intervento.
Contatta Devlogica per parlare del tuo progetto Adobe Commerce.
FAQ sul consulente Adobe Commerce
Quanto costa un consulente Adobe Commerce?
Il costo dipende dalla complessità del progetto e dal tipo di intervento richiesto. Un assessment architetturale, un'attività continuativa di supporto e la progettazione di una nuova piattaforma richiedono modalità di lavoro differenti.
Per questo è generalmente preferibile definire prima obiettivi e perimetro dell'intervento.
Qual è la differenza tra Magento e Adobe Commerce?
Magento Open Source rappresenta la versione open source della piattaforma, mentre Adobe Commerce offre funzionalità e servizi destinati principalmente a scenari commerciali ed enterprise.
Entrambe condividono una parte significativa dell'architettura tecnologica.
Un consulente Adobe Commerce deve essere anche uno sviluppatore?
Non necessariamente, ma una solida esperienza tecnica rappresenta un vantaggio importante.
Per valutare correttamente architettura, performance, integrazioni e personalizzazioni è necessario comprendere in profondità il funzionamento della piattaforma.
Quando conviene fare un assessment Magento?
È particolarmente utile prima di un upgrade importante, una migrazione, un cambio di agenzia o partner tecnologico oppure quando la piattaforma presenta problemi ricorrenti di performance, stabilità o manutenzione.
È possibile integrare Adobe Commerce con un ERP?
Sì. L'integrazione con ERP è uno degli scenari più comuni.
Possono essere sincronizzati catalogo, prezzi, disponibilità, clienti, ordini, fatture e spedizioni. L'architettura dipende dai volumi, dai processi aziendali e dalle API disponibili.
Adobe Commerce può essere utilizzato con un frontend headless?
Sì. Adobe Commerce mette a disposizione API e GraphQL che consentono di implementare architetture headless e frontend separati dal backend commerce.
La scelta tra frontend tradizionale e headless dovrebbe però essere valutata in funzione dei requisiti reali del progetto.
Come capire se un progetto Magento ha troppo debito tecnico?
Alcuni indicatori frequenti sono upgrade molto difficili, regressioni dopo ogni rilascio, moduli non più mantenuti, modifiche al core, performance instabili, assenza di test automatici e difficoltà nel comprendere le dipendenze tra componenti.
Un codebase assessment permette di quantificare questi problemi e definire le priorità di intervento.
ERP farmaceutico: cos'è, come funziona e come integrarlo con l'ecommerce
Gestire una farmacia moderna significa coordinare molti più processi rispetto alla semplice vendita al banco.
Catalogo prodotti, disponibilità, ordini, acquisti dai fornitori, prezzi, promozioni, ecommerce, marketplace e logistica producono continuamente informazioni che devono rimanere sincronizzate.
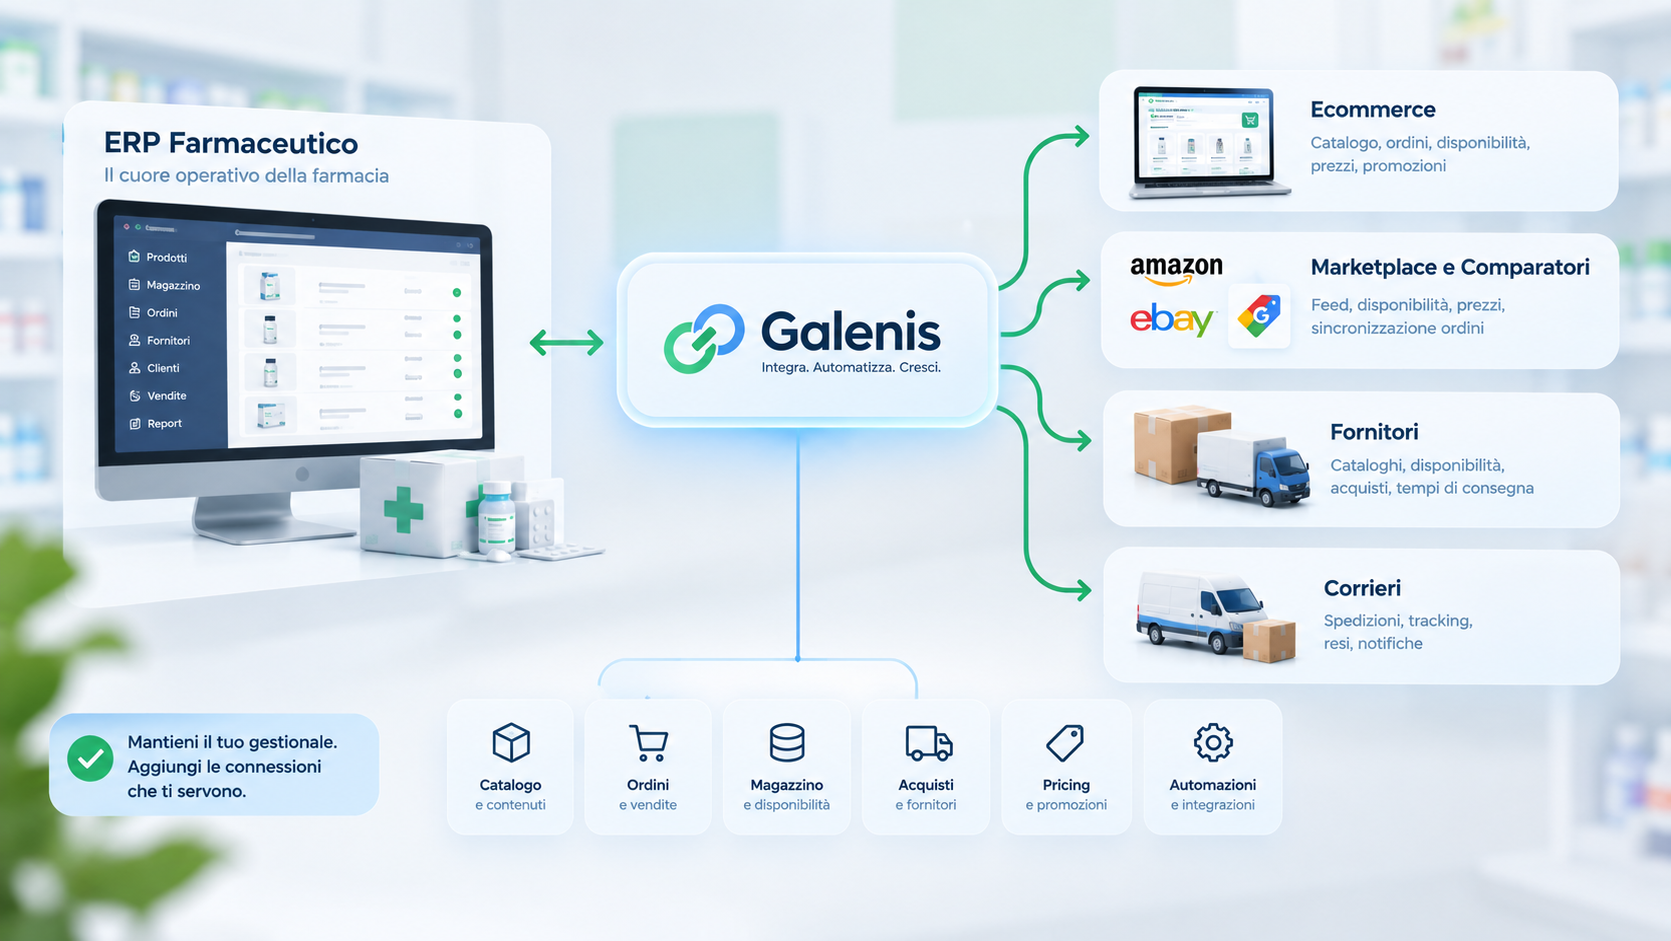
Al centro di questa infrastruttura troviamo spesso il gestionale o ERP farmaceutico.
Ma cosa succede quando la farmacia apre anche un ecommerce?
Il problema non è semplicemente "collegare il gestionale al sito".
La vera sfida consiste nel creare un'architettura capace di far comunicare ERP, ecommerce, fornitori, marketplace e servizi esterni senza trasformare ogni integrazione in un progetto separato.
In questo articolo vediamo cos'è un ERP farmaceutico, come funziona e come integrarlo correttamente con un ecommerce.
Cos'è un ERP farmaceutico?
ERP significa Enterprise Resource Planning.
In termini generali, un ERP è un software che centralizza e coordina i principali processi operativi di un'azienda.
Nel settore farmaceutico assume caratteristiche specifiche perché deve gestire dati e processi propri della farmacia.
Un ERP o gestionale farmaceutico può occuparsi, ad esempio, di:
- anagrafiche prodotto;
- disponibilità;
- magazzino;
- ordini;
- fornitori;
- acquisti;
- prezzi;
- documenti;
- clienti;
- vendite;
- statistiche;
- processi amministrativi.
Per una farmacia fisica rappresenta spesso il sistema centrale dell'attività.
Quando viene introdotto l'ecommerce, però, compare un secondo ecosistema informativo.
ERP farmaceutico e gestionale farmacia sono la stessa cosa?
Nel linguaggio quotidiano i termini vengono spesso utilizzati come sinonimi.
Tecnicamente un ERP tende ad avere una copertura più ampia dei processi aziendali, mentre un gestionale può concentrarsi su funzioni operative specifiche.
Nel settore farmacia la distinzione è spesso meno netta.
La domanda più importante non è quindi come viene chiamato il software, ma:
quali informazioni gestisce e quali sistemi deve alimentare?
Quando una farmacia vende online, il gestionale non opera più da solo.
Deve entrare in relazione con un ecosistema molto più ampio.
Cosa cambia con l'ecommerce?
Consideriamo una farmacia esclusivamente fisica.
Il flusso può essere relativamente lineare:
Fornitori
    ↓
Gestionale
    ↓
Magazzino
    ↓
Vendita
Introducendo un ecommerce lo scenario cambia:
                   Ecommerce
                       ↑
                       │
Fornitori ←→ Gestionale farmacia ←→ Magazzino
                       │
                       ↓
                  Punto vendita
Se aggiungiamo marketplace e comparatori:
                     Ecommerce
                         ↑
                         │
Marketplace ←→ Gestionale farmacia ←→ Fornitori
                         │
                         ↓
                    Magazzino
                         │
                         ↓
                     Corrieri
Il gestionale deve quindi scambiare informazioni con numerosi sistemi esterni.
Ed è qui che iniziano i problemi di integrazione.
Quali dati devono essere sincronizzati?
Integrare un ERP farmaceutico con un ecommerce significa sincronizzare diverse categorie di informazioni.
Catalogo
Il gestionale può essere la fonte di alcuni dati:
EAN
codice prodotto
descrizione
prezzo
IVA
disponibilità
L'ecommerce necessita però di molte altre informazioni:
titolo SEO
descrizione ecommerce
immagini
categorie
attributi
schede informative
brand
URL
meta description
Questo significa che raramente un singolo sistema contiene tutto il catalogo necessario alla vendita online.
Disponibilità e stock
Uno degli aspetti più delicati è la sincronizzazione delle disponibilità.
Un prodotto può essere venduto contemporaneamente:
- in farmacia;
- sul sito ecommerce;
- su Amazon;
- su eBay;
- attraverso altri marketplace.
Se la disponibilità non viene aggiornata rapidamente, può verificarsi una situazione di overselling.
Ad esempio:
Stock gestionale: 3

Ecommerce: 3
Marketplace A: 3
Marketplace B: 3
Questo non significa che siano disponibili nove pezzi.
Significa che gli stessi tre pezzi sono esposti su più canali.
Serve quindi un sistema capace di propagare velocemente le variazioni di stock.
Gli ordini devono viaggiare nella direzione opposta
Per il catalogo il flusso può essere:
ERP
 ↓
Ecommerce
Per gli ordini avviene normalmente il contrario:
Ecommerce
 ↓
ERP
Ma con più canali:
Ecommerce ─────┐
               │
Amazon ────────┼──→ ERP
               │
eBay ──────────┤
               │
Marketplace ───┘
Ogni piattaforma utilizza però:
- formati differenti;
- stati differenti;
- identificativi differenti;
- API differenti.
Il problema diventa quindi normalizzare gli ordini prima di trasferirli al gestionale.
Perché un collegamento diretto ERP-ecommerce può non bastare
La prima soluzione che viene normalmente implementata è:
ERP ←→ Ecommerce
Per una configurazione semplice può funzionare perfettamente.
Il problema emerge quando il progetto cresce.
Supponiamo di aggiungere:
- Amazon;
- eBay;
- Google Merchant;
- Trovaprezzi;
- un secondo fornitore;
- un sistema di repricing;
- un servizio di scraping;
- più corrieri.
L'architettura può rapidamente trasformarsi in:
ERP ←→ Ecommerce
ERP ←→ Marketplace
ERP ←→ Fornitore A
ERP ←→ Fornitore B
Ecommerce ←→ Google
Ecommerce ←→ Trovaprezzi
Ecommerce ←→ Corriere
Marketplace ←→ Corriere
Ogni nuova integrazione introduce:
- mapping;
- credenziali;
- schedulazioni;
- log;
- gestione degli errori;
- retry;
- monitoraggio.
La complessità cresce rapidamente.
Il middleware come layer di integrazione
Una soluzione alternativa consiste nell'introdurre un middleware.
Il middleware si posiziona tra i sistemi:
                Ecommerce
                    ↕
Marketplace ←→ Middleware ←→ ERP farmacia
                    ↕
                Fornitori
                    ↕
                 Corrieri
Il suo compito non è sostituire il gestionale.
Serve invece a coordinare lo scambio delle informazioni.
ERP e middleware svolgono funzioni differenti
È importante distinguere i due ruoli.
ERP farmaceutico
Gestisce il core operativo della farmacia:
Magazzino
Vendite
Acquisti
Fornitori
Documenti
Processi amministrativi
Middleware
Gestisce principalmente integrazioni e automazioni:
Sincronizzazione catalogo
Ordini ecommerce
Marketplace
Feed
Fornitori
Pricing
Corrieri
Automazioni
L'architettura diventa:
                   CANALI

       Ecommerce   Marketplace   Comparatori
            \          |          /
             \         |         /
              ┌─────────────────┐
              │   MIDDLEWARE    │
              └─────────────────┘
                       │
                       ▼
              ┌─────────────────┐
              │ ERP FARMACEUTICO│
              └─────────────────┘
                       │
              ┌────────┴────────┐
              ▼                 ▼
          Magazzino          Fornitori
Un esempio concreto: aggiornamento disponibilità
Supponiamo che venga venduto un prodotto nella farmacia fisica.
Il gestionale registra:
Stock precedente: 12
Vendita: 1
Stock attuale: 11
Il middleware rileva la variazione:
ERP
 ↓
Middleware
e aggiorna:
Ecommerce → 11

Marketplace A → 11

Marketplace B → 11
Naturalmente possono essere applicate regole più sofisticate.
Ad esempio:
Stock ERP: 11

Stock ecommerce: 9
Stock marketplace: 7
mantenendo quantità di sicurezza per ridurre il rischio di overselling.
Un altro esempio: ordine ecommerce
Il cliente effettua un ordine:
Ecommerce
    ↓
Middleware
    ↓
Normalizzazione ordine
    ↓
ERP farmacia
Il gestionale può quindi:
- registrare l'ordine;
- aggiornare la disponibilità;
- attivare il processo di preparazione;
- alimentare i processi amministrativi previsti.
Il middleware può contemporaneamente gestire altre attività.
Ad esempio:
Ordine ricevuto
      ↓
ERP aggiornato
      ↓
Disponibilità aggiornata
      ↓
Marketplace aggiornati
      ↓
Spedizione creata
      ↓
Tracking acquisito
      ↓
Ecommerce aggiornato
Un singolo evento genera quindi diverse automazioni.
Integrare anche i fornitori
Un ecommerce farmaceutico può avere un catalogo molto più ampio rispetto allo stock fisicamente disponibile.
Per questo motivo l'integrazione con i fornitori può diventare particolarmente importante.
Il sistema può acquisire:
disponibilità
prezzi
tempi di consegna
condizioni
cataloghi
Quando lo stock interno non è sufficiente, può essere possibile determinare automaticamente il fornitore più conveniente.
Ad esempio:
| Fornitore | Disponibilità | Prezzo | Consegna |
|---|---|---|---|
| A | 24 | €8,20 | 24h |
| B | 100 | €8,45 | 12h |
| C | 8 | €7,95 | 48h |
La scelta non deve necessariamente basarsi soltanto sul prezzo.
Può considerare:
- disponibilità;
- costo;
- tempi;
- minimo d'ordine;
- condizioni commerciali.
ERP farmaceutico e Farmadati
Nel settore farmacia una parte importante delle informazioni di prodotto può provenire da banche dati specializzate.
Questo introduce un'altra fonte:
                 Farmadati
                     ↓
ERP ←→ Middleware ←→ Ecommerce
                     ↑
                 Fornitori
Il middleware può combinare dati provenienti da fonti differenti.
Ad esempio:
ERP
→ codice
→ stock
→ prezzo

Farmadati
→ informazioni prodotto

Ecommerce
→ contenuti SEO
→ immagini
→ categorie

Fornitore
→ disponibilità
→ costo
Il catalogo ecommerce diventa quindi il risultato della composizione di più fonti informative.
Integrare il pricing
Il prezzo online può seguire logiche differenti rispetto al prezzo della farmacia fisica.
È possibile applicare:
Costo
+
Margine
+
Regole commerciali
+
Analisi concorrenza
=
Prezzo ecommerce
Il middleware può quindi diventare anche il punto in cui vengono applicate le regole di pricing.
Ad esempio:
Prezzo ERP
      ↓
Regole pricing
      ↓
Controllo margine
      ↓
Confronto concorrenza
      ↓
Prezzo ecommerce
Questo permette di evitare aggiornamenti manuali su migliaia di prodotti.
Collegare anche comparatori e marketplace
Una volta centralizzato il catalogo, lo stesso dato può alimentare diversi canali.
                    Google Merchant
                          ↑
                          │
Trovaprezzi ←── Middleware ──→ Marketplace
                          │
                          ↓
                      Ecommerce
Il vantaggio è importante.
Le regole vengono gestite centralmente invece di essere replicate per ogni integrazione.
Gestione degli errori: il punto spesso dimenticato
Un'integrazione non deve funzionare soltanto quando tutto procede correttamente.
Deve soprattutto sapere cosa fare quando qualcosa fallisce.
Ad esempio:
ERP non raggiungibile

API ecommerce in errore

Marketplace non disponibile

Prodotto senza mapping

EAN errato

Ordine non importabile

Corriere temporaneamente offline
Un sistema di integrazione dovrebbe quindi prevedere almeno:
- logging;
- retry automatici;
- code;
- alert;
- dashboard;
- gestione manuale delle eccezioni.
L'obiettivo è evitare che un errore temporaneo provochi la perdita di un ordine o interrompa l'intero processo.
API, webhook e sincronizzazioni
L'integrazione può utilizzare diversi meccanismi.
API
Permettono ai sistemi di comunicare direttamente.
Ad esempio:
GET /products

GET /stock

POST /orders

POST /shipments
Webhook
Permettono di reagire agli eventi.
OrderCreated
      ↓
Webhook
      ↓
Middleware
Sincronizzazioni schedulate
Quando webhook o API real-time non sono disponibili:
Ogni 5 minuti
      ↓
Controllo variazioni
      ↓
Sincronizzazione
Nella pratica un'infrastruttura può utilizzare contemporaneamente tutte queste tecniche.
Come entra Galenis in questa architettura?
Galenis non nasce per sostituire il gestionale della farmacia.
Il suo ruolo è differente.
Galenis può posizionarsi come middleware tra il gestionale e l'ecosistema digitale della farmacia.
                     ┌──────────────┐
                     │  Ecommerce   │
                     └──────┬───────┘
                            │
       ┌────────────────────┼──────────────────┐
       │                    │                  │
       ▼                    ▼                  ▼
 Marketplace          Comparatori          Corrieri
       │                    │                  │
       └────────────────────┼──────────────────┘
                            │
                     ┌──────▼──────┐
                     │   GALENIS   │
                     └──────┬──────┘
                            │
              ┌─────────────┼─────────────┐
              ▼             ▼             ▼
          Gestionale    Farmadati     Fornitori
Questo permette di mantenere il gestionale esistente e costruire progressivamente sopra di esso i processi necessari all'ecommerce.
Cosa può centralizzare Galenis?
A seconda dell'infrastruttura della farmacia, il middleware può gestire processi come:
Catalogo
Sincronizzazione delle informazioni prodotto tra gestionale ed ecommerce.
Vendite e ordini
Acquisizione degli ordini provenienti dai diversi canali e trasferimento verso il gestionale.
Acquisti fornitori
Disponibilità, prezzi e processi di approvvigionamento.
Promozioni e pricing
Regole commerciali e aggiornamento dei prezzi online.
Farmadati
Integrazione delle informazioni provenienti dalla banca dati.
Comparatori
Generazione e aggiornamento dei feed verso servizi come Trovaprezzi.
Google Merchant
Sincronizzazione del catalogo destinato a Google.
Marketplace
Gestione dei flussi verso piattaforme come eBay e Amazon.
Scraping concorrenti
Raccolta di informazioni utili per monitoraggio e strategie di pricing.
In questo modo ogni nuova integrazione non deve necessariamente essere sviluppata direttamente all'interno dell'ecommerce o dell'ERP.
Devo cambiare ERP per automatizzare il mio ecommerce?
Non necessariamente.
Questo è un punto importante.
Una farmacia può avere un gestionale utilizzato da anni che svolge perfettamente le proprie funzioni operative.
Cambiarlo esclusivamente per esigenze ecommerce può significare:
- migrazione dei dati;
- formazione;
- modifica delle procedure;
- rischi operativi;
- costi;
- tempi di progetto.
In molti casi può essere più razionale mantenere l'ERP e costruire un layer di integrazione intorno ad esso.
Il requisito fondamentale è poter accedere ai dati necessari attraverso:
- API;
- web service;
- database;
- esportazioni;
- file;
- altri protocolli supportati.
Come valutare l'integrazione del proprio ERP
Prima di iniziare un progetto conviene analizzare cinque aree.
| Area | Domanda |
|---|---|
| Catalogo | Dove si trova il dato principale del prodotto? |
| Stock | Qual è il sistema autorevole per la disponibilità? |
| Ordini | Dove devono essere registrate le vendite online? |
| Prezzi | Quale sistema decide il prezzo ecommerce? |
| Integrazioni | Quali API o sistemi di scambio dati sono disponibili? |
Da questa analisi emerge l'architettura corretta.
Non esiste necessariamente una soluzione identica per tutte le farmacie.
Quando serve un middleware?
Un collegamento diretto può essere sufficiente quando l'infrastruttura è semplice:
ERP ↔ Ecommerce
Un middleware diventa progressivamente più interessante quando entrano in gioco:
- più marketplace;
- più fornitori;
- migliaia di prodotti;
- comparatori;
- sistemi di repricing;
- più corrieri;
- automazioni degli acquisti;
- feed differenti;
- sincronizzazioni frequenti;
- processi che coinvolgono diversi sistemi.
Una buona indicazione è questa:
se ogni nuovo canale richiede una nuova integrazione punto-punto, probabilmente è arrivato il momento di introdurre un layer di integrazione.
FAQ
Cos'è un ERP farmaceutico?
È un sistema software utilizzato per gestire e coordinare processi operativi della farmacia come prodotti, magazzino, vendite, acquisti, fornitori e altre attività amministrative.
Un ERP farmaceutico può essere collegato a un ecommerce?
Sì. L'integrazione può avvenire tramite API, web service, database, file o altri sistemi di scambio dati messi a disposizione dal gestionale.
È necessario sostituire il gestionale per aprire un ecommerce?
Non necessariamente. Se il gestionale permette di accedere ai dati necessari, può essere integrato con l'ecommerce direttamente oppure attraverso un middleware.
Cosa deve essere sincronizzato tra ERP ed ecommerce?
Normalmente almeno prodotti, disponibilità, prezzi e ordini. In sistemi più evoluti possono essere sincronizzati anche fornitori, acquisti, tracking, marketplace e altre informazioni.
Quanto spesso deve essere aggiornato lo stock?
Dipende dai volumi e dai canali di vendita. Con stock limitato e più marketplace è preferibile ridurre il più possibile il tempo tra una variazione e la sua propagazione.
Cos'è un middleware per farmacia?
È un software che si posiziona tra gestionale e sistemi esterni e coordina integrazioni, trasformazioni dei dati e automazioni.
Galenis sostituisce l'ERP della farmacia?
No. Galenis è pensato per integrarsi con il gestionale e collegarlo a ecommerce, fornitori, marketplace, comparatori e altri servizi.
Posso mantenere il mio ecommerce esistente?
Sì. L'obiettivo di un middleware è proprio evitare, quando possibile, di sostituire sistemi che già svolgono correttamente la loro funzione.
È possibile integrare Magento o WooCommerce?
Sì. Entrambe le piattaforme mettono a disposizione sistemi di integrazione che consentono di sincronizzare catalogo, ordini e altre informazioni con applicazioni esterne.
Conclusioni
Un ERP farmaceutico rimane uno dei componenti fondamentali dell'infrastruttura informatica di una farmacia.
Con l'ecommerce, però, non è più necessariamente l'unico sistema centrale.
Attorno ad esso iniziano a gravitare:
Ecommerce
Marketplace
Fornitori
Comparatori
Corrieri
Banche dati
Pricing
Marketing
Il problema diventa quindi orchestrare questi sistemi senza creare decine di integrazioni indipendenti.
Un'architettura basata su un middleware permette di separare chiaramente le responsabilità:
ERP
→ gestisce il core della farmacia

Ecommerce
→ gestisce l'esperienza di vendita online

Galenis
→ integra e automatizza i sistemi
In questo modo la farmacia può mantenere gli strumenti che già utilizza e aggiungere progressivamente nuovi canali e automazioni.
Vuoi integrare il tuo gestionale con l'ecommerce?
Se utilizzi già un ERP o gestionale farmaceutico possiamo analizzare come vengono gestiti oggi catalogo, disponibilità, prezzi, ordini e fornitori.
L'obiettivo non è necessariamente sostituire il software esistente.
Con Galenis possiamo costruire il layer di integrazione tra gestionale, ecommerce, marketplace, fornitori e servizi esterni, automatizzando progressivamente i processi che oggi richiedono attività manuali.
Automatizzare spedizioni, tracking e resi in una farmacia online
Automatizzare spedizioni, tracking e resi in una farmacia online
Gestire un ecommerce farmaceutico non significa soltanto pubblicare prodotti e acquisire ordini.
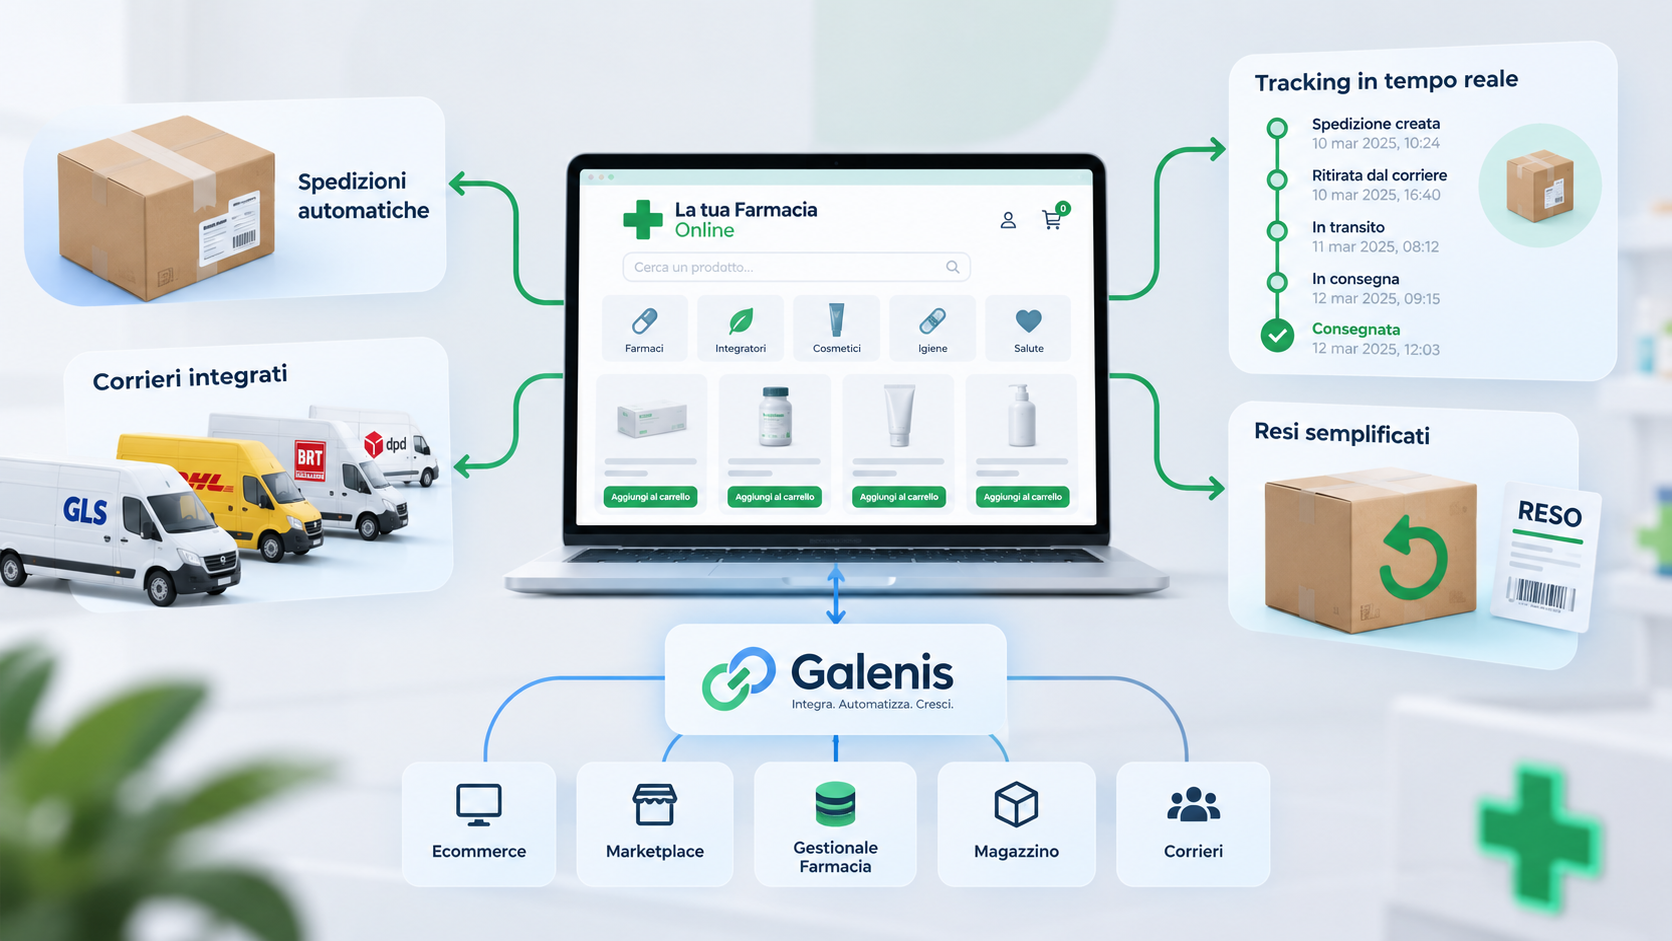
Quando i volumi crescono, una parte importante del lavoro quotidiano si sposta sulle operazioni successive alla vendita: preparazione delle spedizioni, comunicazione con i corrieri, generazione delle etichette, aggiornamento del tracking, notifiche al cliente e gestione di eventuali resi.
Se questi processi vengono gestiti manualmente o attraverso sistemi non integrati, ogni ordine può richiedere diversi interventi da parte degli operatori.
Con poche decine di spedizioni al giorno il problema può sembrare gestibile. Con centinaia di ordini, invece, diventa rapidamente un limite alla crescita.
L'obiettivo dovrebbe essere semplice:
l'operatore gestisce le eccezioni, mentre il sistema gestisce automaticamente il flusso ordinario.
In questo articolo vediamo come progettare un processo automatizzato per spedizioni, tracking e resi in una farmacia online.
Perché la logistica diventa rapidamente un collo di bottiglia
Un ordine ecommerce attraversa normalmente diverse fasi:
- ricezione dell'ordine;
- verifica della disponibilità;
- preparazione;
- assegnazione del corriere;
- creazione della spedizione;
- generazione dell'etichetta;
- affidamento al corriere;
- acquisizione del tracking;
- aggiornamento dello stato dell'ordine;
- comunicazione al cliente;
- eventuale gestione del reso.
Quando ecommerce, gestionale, magazzino e corriere non sono realmente integrati, alcune di queste attività vengono eseguite manualmente.
L'operatore deve quindi passare continuamente da un sistema all'altro.
Il risultato è un processo che funziona, ma che scala male all'aumentare degli ordini.
Il problema delle integrazioni isolate
Una farmacia online può utilizzare contemporaneamente:
- Magento, WooCommerce o un'altra piattaforma ecommerce;
- un gestionale della farmacia;
- software di magazzino;
- uno o più corrieri;
- marketplace;
- sistemi ERP;
- software amministrativi.
Il problema non è necessariamente la mancanza di integrazioni.
Spesso il problema è esattamente l'opposto: esistono molte integrazioni indipendenti tra loro.
Ad esempio:
Ecommerce → Gestionale

Ecommerce → Corriere A

Ecommerce → Corriere B

Marketplace → Gestionale

Marketplace → Corriere

Gestionale → Magazzino
Ogni collegamento implementa proprie regole, mapping e procedure di gestione degli errori.
Quando viene aggiunto un nuovo canale di vendita o un nuovo corriere, la complessità aumenta ulteriormente.
Un approccio più sostenibile consiste nell'introdurre un layer centrale di orchestrazione.
                 ┌───────────────┐
                 │   Ecommerce   │
                 └───────┬───────┘
                         │
                 ┌───────▼───────┐
                 │     Galenis   │
                 │ Integration   │
                 │     Layer     │
                 └───────┬───────┘
                         │
          ┌──────────────┼──────────────┐
          │              │              │
          ▼              ▼              ▼
     Gestionale      Corriere A     Corriere B
In questo modello è il middleware a coordinare i diversi sistemi.
1. Automatizzare la creazione delle spedizioni
Il primo processo da automatizzare è la creazione della spedizione.
Quando un ordine raggiunge uno stato configurato, il sistema può inviare automaticamente al corriere tutte le informazioni necessarie:
- destinatario;
- indirizzo;
- CAP;
- località;
- telefono;
- email;
- numero ordine;
- numero colli;
- peso;
- eventuale contrassegno;
- servizi accessori.
Il corriere restituisce quindi i dati della spedizione.
Tra questi normalmente troviamo:
shipment_id
tracking_number
label
carrier
service
L'etichetta può essere immediatamente resa disponibile al magazzino.
L'operatore non deve quindi reinserire manualmente indirizzo e informazioni dell'ordine sul portale del corriere.
2. Gestire più corrieri automaticamente
Molti ecommerce utilizzano più di un corriere.
La scelta può dipendere da diversi fattori:
- destinazione;
- peso;
- valore dell'ordine;
- servizio richiesto;
- tempi di consegna;
- costo;
- disponibilità del servizio;
- tipologia di prodotto.
Queste regole possono essere automatizzate.
Ad esempio:
SE destinazione = Italia
E peso < 5 kg
→ Corriere A

SE peso >= 5 kg
→ Corriere B

SE destinazione = isole
→ Corriere C

SE servizio = consegna express
→ Corriere A Express
Le regole possono essere modificate senza cambiare il normale processo di evasione degli ordini.
Questo permette alla farmacia di adottare una vera strategia multi-carrier.
3. Generare automaticamente le etichette
Uno dei passaggi che genera più lavoro operativo è la produzione delle etichette di spedizione.
Con un'integrazione tramite API il processo può diventare:
Ordine pronto
      ↓
Creazione spedizione
      ↓
Chiamata API corriere
      ↓
Tracking assegnato
      ↓
Etichetta generata
      ↓
Stampa
L'etichetta può essere:
- salvata nel sistema;
- inviata alla postazione di magazzino;
- stampata automaticamente;
- associata all'ordine.
Questo riduce sia il tempo necessario per preparare le spedizioni sia il rischio di errori di trascrizione.
4. Sincronizzare automaticamente il tracking
Il tracking non dovrebbe essere un dato inserito manualmente.
Una volta creata la spedizione, il codice restituito dal corriere può essere propagato automaticamente verso tutti i sistemi interessati.
Ad esempio:
Corriere
   ↓
Galenis
   ↓
Ecommerce
   ↓
Gestionale
   ↓
Marketplace
   ↓
Cliente
In questo modo tutti i sistemi utilizzano lo stesso tracking.
È particolarmente importante quando gli ordini provengono da più canali.
Un ordine Amazon, eBay o proveniente direttamente dall'ecommerce può seguire lo stesso processo logistico, mentre il middleware si occupa di aggiornare il canale corretto.
5. Aggiornare automaticamente lo stato della spedizione
Il tracking non serve soltanto al cliente.
Può diventare una vera fonte di informazioni operative.
Attraverso le API dei corrieri è possibile acquisire eventi come:
spedizione creata
ritirata dal corriere
in transito
in consegna
consegnata
tentata consegna
giacenza
indirizzo errato
rifiutata
ritorno al mittente
Questi eventi possono aggiornare automaticamente lo stato interno dell'ordine.
La farmacia può quindi sapere quali spedizioni stanno procedendo normalmente e quali richiedono attenzione.
6. Gestire le eccezioni invece delle spedizioni
Questo è probabilmente il cambiamento operativo più importante.
In un sistema tradizionale gli operatori controllano le spedizioni.
In un sistema automatizzato gli operatori controllano solo le anomalie.
Il sistema può creare automaticamente alert per situazioni come:
Tracking non aggiornato da 48 ore

Tentata consegna

Spedizione in giacenza

Indirizzo non valido

Pacco danneggiato

Ritorno al mittente
La dashboard operativa potrebbe quindi mostrare:
| Stato | Spedizioni |
|---|---|
| Regolari | 487 |
| In consegna | 82 |
| Consegnate | 351 |
| Da verificare | 9 |
| In giacenza | 4 |
L'operatore non deve controllare 487 spedizioni.
Deve occuparsi delle 13 che richiedono un intervento.
È questo il principio che permette alla logistica ecommerce di scalare.
7. Automatizzare le comunicazioni al cliente
Ogni evento logistico può generare automaticamente una comunicazione.
Ad esempio:
Spedizione affidata al corriere
Il cliente riceve:
- conferma della spedizione;
- nome del corriere;
- tracking;
- collegamento alla pagina di monitoraggio.
Spedizione in consegna
È possibile inviare una nuova notifica.
Problema di consegna
Il sistema può informare il cliente oppure creare una richiesta di intervento per il customer service.
Consegna completata
Può partire automaticamente una comunicazione post-vendita.
Il vantaggio è duplice: migliorare l'esperienza del cliente e ridurre le richieste del tipo:
"Dov'è il mio ordine?"
8. Automatizzare anche i resi
Il reso viene spesso trattato come un processo completamente separato dalla spedizione.
Dal punto di vista dei sistemi informativi, invece, dovrebbe essere considerato parte dello stesso ciclo dell'ordine.
Un processo strutturato può essere:
Richiesta reso
      ↓
Verifica delle condizioni
      ↓
Autorizzazione
      ↓
Creazione RMA
      ↓
Generazione etichetta di reso
      ↓
Spedizione del cliente
      ↓
Tracking reso
      ↓
Ricezione in magazzino
      ↓
Verifica
      ↓
Rimborso / altra azione prevista
Anche in questo caso molti passaggi possono essere automatizzati.
9. RMA: dare un'identità al reso
Per gestire correttamente i resi è utile introdurre un identificativo RMA (Return Merchandise Authorization).
Ad esempio:
Ordine: 10004521

RMA: RMA-2026-001245
L'RMA permette di collegare:
- ordine originale;
- cliente;
- prodotti restituiti;
- motivazione;
- tracking del reso;
- stato della pratica;
- esito del controllo;
- eventuale rimborso.
Quando il pacco arriva in magazzino, l'operatore può quindi identificare immediatamente la pratica associata.
10. Automatizzare l'etichetta di reso
Quando previsto dalle procedure commerciali e dalla tipologia di prodotto, il sistema può generare automaticamente anche la spedizione inversa.
Il processo diventa:
RMA autorizzato
      ↓
API corriere
      ↓
Creazione spedizione di reso
      ↓
Generazione etichetta
      ↓
Invio al cliente
Il tracking della spedizione inversa viene associato direttamente alla pratica.
La farmacia può quindi sapere quando il prodotto è stato spedito e quando dovrebbe rientrare in magazzino.
11. Attenzione alle specificità del settore farmaceutico
In una farmacia online la gestione del reso non può essere progettata esclusivamente come un problema logistico.
Occorre considerare:
- normativa applicabile;
- tipologia del prodotto;
- condizioni di conservazione;
- integrità della confezione;
- eventuali restrizioni alla restituzione;
- procedure interne della farmacia.
Per questo motivo il workflow dovrebbe supportare regole differenti per categoria di prodotto.
Ad esempio:
Richiesta reso
      ↓
Identificazione prodotto
      ↓
Verifica regole applicabili
      ↓
Autorizzazione automatica
      oppure
Revisione operatore
L'automazione non significa quindi eliminare i controlli.
Significa automatizzare ciò che può essere automatizzato e indirizzare agli operatori i casi che richiedono una decisione.
12. Collegare logistica, ecommerce e gestionale
Il vero vantaggio emerge quando spedizioni e resi non sono processi isolati.
Consideriamo un ordine:
Cliente
   ↓
Ecommerce
   ↓
Galenis
   ↓
Gestionale farmacia
   ↓
Preparazione ordine
   ↓
Corriere
   ↓
Tracking
   ↓
Ecommerce / Marketplace
   ↓
Cliente
In caso di reso:
Cliente
   ↓
Richiesta reso
   ↓
Galenis
   ↓
RMA
   ↓
Corriere
   ↓
Magazzino
   ↓
Gestionale
   ↓
Ecommerce
Il middleware mantiene sincronizzati i diversi sistemi.
13. Centralizzare gli eventi logistici
Un'architettura evoluta può trattare ogni cambiamento come un evento.
Ad esempio:
OrderReadyForShipment

ShipmentCreated

ShipmentPickedUp

ShipmentInTransit

ShipmentOutForDelivery

ShipmentDelivered

ShipmentException

ReturnRequested

ReturnAuthorized

ReturnReceived
Ogni evento può attivare automaticamente altre operazioni.
Ad esempio:
ShipmentDelivered
        ↓
Aggiorna ecommerce
        ↓
Aggiorna gestionale
        ↓
Chiudi spedizione
        ↓
Invia comunicazione cliente
Questo approccio riduce l'accoppiamento tra i sistemi e rende più semplice aggiungere nuovi canali o nuove automazioni.
14. Monitorare SLA e performance dei corrieri
Centralizzare i dati logistici permette anche di misurare le performance.
Alcuni KPI interessanti sono:
| KPI | Significato |
|---|---|
| Tempo medio evasione | ordine → affidamento al corriere |
| Tempo medio consegna | affidamento → consegna |
| First delivery success | consegne riuscite al primo tentativo |
| Tasso giacenze | spedizioni finite in giacenza |
| Tasso resi | ordini che generano un reso |
| Delivery exception rate | spedizioni con anomalie |
| Costo medio spedizione | costo logistico per ordine |
Questi dati permettono di confrontare i corrieri sulla base delle performance effettivamente registrate.
15. Quanto tempo può essere risparmiato?
Supponiamo che una farmacia gestisca 300 ordini al giorno.
Se le attività manuali legate alla spedizione richiedono mediamente anche solo 2 minuti per ordine:
300 × 2 minuti = 600 minuti

600 minuti = 10 ore/giorno
Sono oltre 200 ore operative al mese.
Naturalmente il risparmio effettivo dipende dal processo esistente, ma il principio è evidente: pochi minuti moltiplicati per migliaia di ordini diventano rapidamente un costo significativo.
L'obiettivo dell'automazione è spostare il lavoro umano dalle operazioni ripetitive alle eccezioni che richiedono realmente attenzione.
Come può intervenire Galenis
Galenis nasce come middleware per collegare i sistemi utilizzati dalla farmacia online.
Non sostituisce necessariamente ecommerce o gestionale.
Introduce invece un layer che può coordinare:
Gestionale farmacia
        ↕
      Galenis
        ↕
Ecommerce
        ↕
Marketplace
        ↕
Corrieri
        ↕
Fornitori
Sul fronte logistico questo permette di centralizzare processi come:
- acquisizione degli ordini;
- selezione del corriere;
- creazione delle spedizioni;
- generazione delle etichette;
- sincronizzazione del tracking;
- monitoraggio degli eventi;
- gestione delle anomalie;
- comunicazioni;
- resi e RMA.
La logistica diventa quindi parte dello stesso processo di automazione che collega catalogo, ordini, acquisti, marketplace e gestionale.
Quando conviene automatizzare?
L'automazione diventa particolarmente interessante quando:
- il numero degli ordini sta aumentando;
- vengono utilizzati più corrieri;
- gli ordini arrivano da ecommerce e marketplace;
- il tracking viene ancora inserito manualmente;
- il customer service riceve molte richieste sullo stato delle spedizioni;
- le giacenze vengono controllate manualmente;
- la gestione dei resi avviene tramite email;
- gli operatori devono copiare dati tra più sistemi.
Non è necessario automatizzare tutto contemporaneamente.
Spesso conviene partire dai processi con maggiore volume e maggiore componente manuale.
Un possibile percorso di automazione
Una roadmap pragmatica può essere:
Fase 1 — Spedizioni
Automatizzare:
Ordine → Corriere → Etichetta → Tracking
Fase 2 — Tracking
Aggiungere:
Corriere → Eventi → Ecommerce → Cliente
Fase 3 — Eccezioni
Gestire automaticamente:
Giacenze
Tentate consegne
Tracking bloccati
Ritorni al mittente
Fase 4 — Resi
Introdurre:
RMA → Etichetta → Tracking reso → Ricezione
Fase 5 — Analytics
Misurare:
Tempi
Costi
SLA
Anomalie
Performance corrieri
Tasso resi
In questo modo l'investimento cresce insieme ai volumi e alle esigenze operative della farmacia.
FAQ
È possibile integrare più corrieri nello stesso sistema?
Sì. Un middleware può normalizzare le diverse API dei corrieri e presentare all'ecommerce un'interfaccia comune per creazione spedizioni, tracking ed eventi.
Il tracking può essere aggiornato automaticamente?
Sì. A seconda delle API disponibili, gli aggiornamenti possono essere ricevuti tramite webhook oppure acquisiti periodicamente interrogando il sistema del corriere.
È possibile scegliere automaticamente il corriere?
Sì. È possibile definire regole basate su destinazione, peso, valore dell'ordine, servizio, costo o altri parametri.
Le etichette possono essere generate automaticamente?
Sì. Se il corriere mette a disposizione le API necessarie, il sistema può creare la spedizione e acquisire direttamente l'etichetta.
È possibile gestire anche ordini provenienti dai marketplace?
Sì. Il middleware può normalizzare ordini provenienti da ecommerce e marketplace e applicare un processo logistico comune, aggiornando successivamente il canale di origine.
Come vengono gestiti gli errori del corriere?
Gli errori dovrebbero essere registrati e classificati. Il sistema può ritentare automaticamente le operazioni temporaneamente fallite oppure creare un'eccezione che richiede l'intervento di un operatore.
È possibile automatizzare completamente i resi?
Non sempre. Alcune fasi possono richiedere verifiche commerciali, logistiche o normative. Il sistema può però automatizzare la raccolta della richiesta, l'RMA, la generazione dell'etichetta, il tracking e l'aggiornamento dei sistemi coinvolti.
Galenis sostituisce il gestionale della farmacia?
No. Galenis può funzionare come middleware tra gestionale, ecommerce, fornitori, marketplace e servizi esterni, lasciando al gestionale le funzioni per cui è già utilizzato.
Conclusioni
La logistica di un ecommerce non dovrebbe crescere linearmente con il numero degli ordini.
Passare da 100 a 500 ordini al giorno non dovrebbe significare moltiplicare per cinque il lavoro amministrativo necessario per gestire spedizioni e tracking.
Per ottenere questo risultato è necessario trasformare il processo:
gestione manuale degli ordini
            ↓
automazione del flusso ordinario
            ↓
gestione delle sole eccezioni
Creazione delle spedizioni, etichette, tracking, notifiche, anomalie e resi possono diventare parti di un unico workflow integrato.
Per una farmacia online questo significa meno attività ripetitive, meno errori e una struttura operativa capace di sostenere volumi maggiori senza aumentare proporzionalmente il lavoro manuale.
Vuoi automatizzare la logistica del tuo ecommerce farmaceutico?
Possiamo analizzare il flusso attuale tra gestionale, ecommerce, marketplace e corrieri e individuare quali attività possono essere automatizzate.
Con Galenis possiamo costruire un'integrazione progressiva partendo dai processi che oggi assorbono più tempo: spedizioni, tracking, anomalie o resi.
Magento 2 lento: 15 controlli da fare prima di cambiare server
Un Magento 2 lento non significa necessariamente che il server sia sottodimensionato.
Quando un ecommerce impiega diversi secondi per generare una pagina, il primo impulso è spesso aumentare CPU e RAM, passare a un server più potente o cambiare provider.
In alcuni casi è necessario. In molti altri significa semplicemente spostare il problema su un'infrastruttura più costosa.
Le performance di Magento 2 dipendono da numerosi componenti: PHP, database, cache, Redis, Varnish, OpenSearch, cron, indexer, moduli di terze parti, codice custom, frontend e servizi esterni.
Prima di cambiare server conviene quindi individuare il vero collo di bottiglia.
Ecco 15 controlli da effettuare quando Magento 2 è lento.
Perché Magento 2 può diventare lento?
Magento è una piattaforma ecommerce complessa.
Una singola richiesta può coinvolgere:
- PHP;
- database MySQL/MariaDB;
- cache;
- Redis;
- Varnish;
- OpenSearch;
- filesystem;
- sessioni;
- moduli custom;
- estensioni di terze parti;
- API esterne;
- frontend JavaScript;
- immagini e contenuti statici.
Per questo una diagnosi basata semplicemente sull'utilizzo della CPU è spesso insufficiente.
Bisogna innanzitutto distinguere tra due problemi molto diversi:
backend lento: Magento impiega troppo tempo a generare la risposta;
frontend lento: il server risponde velocemente, ma il browser impiega troppo tempo a visualizzare la pagina.
Questa distinzione restringe immediatamente il campo di ricerca.
1. Misurare il TTFB
Il primo parametro da controllare è il Time to First Byte (TTFB).
Indica quanto tempo trascorre prima che il browser inizi a ricevere la risposta dal server.
Un TTFB elevato può indicare problemi relativi a:
- PHP;
- database;
- cache;
- chiamate esterne;
- codice applicativo;
- infrastruttura.
Se invece il TTFB è buono ma la pagina appare lentamente, il problema potrebbe essere principalmente frontend.
Prima di ottimizzare bisogna quindi misurare dove viene perso il tempo.
2. Verificare che Magento sia in Production Mode
Sembra banale, ma è uno dei primi controlli da effettuare.
Magento dovrebbe essere eseguito in modalità:
bin/magento deploy:mode:show
In produzione il risultato dovrebbe essere:
Current application mode: production
Utilizzare Developer Mode su un ambiente pubblico può peggiorare sensibilmente le performance.
3. Controllare la Full Page Cache
La Full Page Cache (FPC) è fondamentale per le performance di Magento.
È possibile controllarne lo stato con:
bin/magento cache:status
La cache deve essere attiva e correttamente configurata.
Se una pagina teoricamente cacheabile viene continuamente rigenerata da PHP, il carico applicativo aumenta enormemente.
Un problema particolarmente insidioso è rappresentato dai moduli custom che rendono accidentalmente non cacheabili intere pagine.
4. Verificare Varnish
Su installazioni con traffico significativo, Varnish può ridurre drasticamente il numero di richieste che raggiungono PHP.
Ma non basta installarlo.
Bisogna verificare che stia realmente servendo le pagine dalla cache.
È utile controllare:
- HIT/MISS;
- TTL;
- header HTTP;
- invalidazioni;
- configurazione VCL;
- pagine escluse dalla cache.
Una configurazione Varnish formalmente attiva ma con una percentuale elevata di MISS offre benefici molto inferiori alle aspettative.
5. Controllare Redis
Magento può utilizzare Redis per diversi tipi di dati, tra cui cache e sessioni.
Occorre verificare:
- configurazione;
- memoria disponibile;
- eviction;
- latency;
- connessioni;
- utilizzo effettivo da parte di Magento.
Redis non rende automaticamente veloce Magento.
Un Redis saturo, mal configurato o collocato su un'infrastruttura con elevata latenza può diventare esso stesso un collo di bottiglia.
6. Analizzare le query SQL lente
Il database è uno dei primi componenti da analizzare quando Magento rallenta.
È importante identificare:
- slow query;
- query ripetitive;
- query prive di indici adeguati;
- lock;
- tabelle molto grandi;
- operazioni custom particolarmente costose.
Il problema può provenire dal core, ma molto frequentemente deriva da:
- estensioni;
- personalizzazioni;
- integrazioni;
- collection Magento utilizzate male.
Una singola funzionalità custom può generare centinaia di query inutili durante la costruzione di una pagina.
7. Controllare dimensione e stato delle tabelle
Un database Magento utilizzato per anni può accumulare grandi quantità di dati.
È opportuno controllare la crescita di tabelle relative a:
- log;
- quote;
- sessioni;
- cron;
- report;
- integrazioni;
- moduli custom.
Il problema non è semplicemente avere un database grande.
Bisogna individuare quali tabelle stanno crescendo, perché stanno crescendo e come vengono interrogate.
Aggiungere RAM al database senza analizzare questi aspetti può soltanto rimandare il problema.
8. Verificare indexer e cron
Magento utilizza intensivamente processi asincroni.
Controlliamo gli indexer:
bin/magento indexer:status
e il cron:
bin/magento cron:run
Index non aggiornati, cron bloccati o job estremamente lunghi possono avere effetti sull'intero sistema.
È importante analizzare:
- durata dei job;
- frequenza;
- sovrapposizioni;
- errori;
- processi rimasti bloccati;
- consumo di CPU e memoria.
Un cron apparentemente secondario può saturare periodicamente il server e provocare rallentamenti difficili da diagnosticare.
9. Controllare OpenSearch
Nei cataloghi grandi, anche il motore di ricerca può influenzare significativamente le performance.
Occorre monitorare:
- stato del cluster;
- memoria;
- heap;
- shard;
- indici;
- tempi delle query;
- CPU;
- operazioni di indexing.
Problemi di OpenSearch possono manifestarsi soprattutto su:
- ricerca;
- categorie;
- navigazione;
- filtri;
- reindex.
Aumentare le risorse del web server non risolve un collo di bottiglia nel cluster OpenSearch.
10. Analizzare moduli di terze parti e codice custom
Questo è uno dei controlli più importanti.
Magento può essere configurato perfettamente e continuare a essere lento a causa di una singola estensione.
I problemi tipici comprendono:
- plugin eseguiti troppo frequentemente;
- observer pesanti;
- query ripetitive;
- caricamento completo di collection;
- chiamate HTTP sincrone;
- elaborazioni effettuate durante la request;
- uso scorretto del repository pattern;
- blocchi non cacheabili;
- logica complessa inserita nel rendering.
Non bisogna quindi chiedersi soltanto:
"Magento è lento?"
La domanda più utile è:
"Quale componente sta consumando il tempo della richiesta?"
11. Cercare chiamate verso API esterne
Un ecommerce moderno comunica spesso con molti sistemi:
- ERP;
- CRM;
- sistemi di pagamento;
- servizi logistici;
- marketplace;
- sistemi marketing;
- motori di raccomandazione;
- servizi antifrode.
Una chiamata HTTP sincrona durante il caricamento della pagina può rallentare l'intera esperienza.
Immaginiamo:
Magento:       250 ms
API esterna: 1.800 ms
Totale:      2.050 ms
Il server Magento non è il problema.
Quando possibile, operazioni non strettamente necessarie alla risposta dovrebbero essere spostate verso processi asincroni, queue o background job.
12. Controllare PHP-FPM e OPcache
Una configurazione PHP non adeguata può limitare le performance anche su server potenti.
Tra i parametri da analizzare troviamo:
- numero di worker PHP-FPM;
- memoria disponibile;
memory_limit;- process manager;
- processi saturati;
- timeout;
- OPcache.
Un server con molta RAM ma pochi worker disponibili può creare code di richieste durante i picchi.
Al contrario, configurare troppi worker rispetto alla memoria disponibile può provocare swapping e peggiorare drasticamente le performance.
Il dimensionamento deve essere basato su misurazioni reali del consumo per processo.
13. Controllare immagini e frontend
Non tutti i problemi attribuiti a Magento sono realmente problemi backend.
Una pagina può essere generata velocemente dal server ma risultare comunque lenta a causa di:
- immagini troppo pesanti;
- JavaScript;
- CSS;
- font;
- script di tracking;
- tag manager;
- widget esterni;
- slider;
- video;
- chat;
- script marketing.
Occorre quindi analizzare anche metriche frontend e Core Web Vitals.
Questo aspetto è particolarmente importante quando si utilizzano frontend complessi o temi pesantemente personalizzati.
Soluzioni moderne come Hyvä possono ridurre significativamente la complessità frontend rispetto ad alcune implementazioni tradizionali, ma anche in questo caso la qualità dell'implementazione rimane determinante.
14. Analizzare log ed errori
I log possono rivelare problemi che non emergono immediatamente durante la navigazione.
Tra i file e le sorgenti da controllare troviamo:
var/log/system.log
var/log/exception.log
var/log/debug.log
oltre ai log di:
- PHP-FPM;
- Nginx/Apache;
- MySQL;
- Redis;
- Varnish;
- OpenSearch;
- sistema operativo.
Un numero elevato di exception intercettate, warning o retry può consumare risorse senza produrre un errore evidente all'utente.
È importante anche verificare che applicazioni o moduli custom non stiano generando quantità anomale di log.
15. Utilizzare un profiler/APM prima di aumentare il server
Questo è probabilmente il controllo più importante.
Prima di investire nell'infrastruttura è opportuno profilare l'applicazione.
Strumenti APM e profiler permettono di visualizzare dove viene realmente trascorso il tempo.
Una request da 3 secondi potrebbe, per esempio, essere composta da:
Magento/PHP             320 ms
Database                410 ms
Modulo custom           180 ms
API ERP               1.750 ms
Altro                   340 ms
--------------------------------
Totale                3.000 ms
Senza profiling potremmo concludere:
"Magento ha bisogno di un server più potente."
Con il profiling scopriamo invece che quasi il 60% del tempo dipende da una chiamata esterna.
Sono due problemi completamente diversi.
Quando serve davvero cambiare server?
Dopo aver effettuato questi controlli potrebbe emergere che l'infrastruttura è effettivamente sottodimensionata.
È possibile osservare, per esempio:
- CPU costantemente elevata;
- memoria insufficiente;
- swapping;
- PHP-FPM saturo;
- I/O elevato;
- database senza risorse;
- Redis senza memoria;
- OpenSearch sottodimensionato.
In questo caso aumentare le risorse è perfettamente ragionevole.
La differenza è che la decisione viene presa sulla base dei dati, non per tentativi.
Magento lento: perché cambiare server può non risolvere il problema
Supponiamo che una pagina impieghi 4 secondi.
Cambiamo server e raddoppiamo CPU e RAM.
La pagina passa a 3,5 secondi.
Abbiamo ottenuto un miglioramento marginale aumentando permanentemente il costo dell'infrastruttura.
Se invece scopriamo che 2,5 secondi dipendono da una query SQL custom o da una API esterna, possiamo intervenire direttamente sul problema.
È per questo che una corretta analisi delle performance Magento 2 deve precedere il dimensionamento dell'infrastruttura.
Checklist: Magento 2 lento
Prima di cambiare server verifica questi 15 punti:
- TTFB e tempi reali di risposta
- Production Mode
- Full Page Cache
- Varnish
- Redis
- Slow query SQL
- Dimensione e stato delle tabelle
- Indexer e cron
- OpenSearch
- Moduli e codice custom
- API e servizi esterni
- PHP-FPM e OPcache
- Frontend, immagini e JavaScript
- Log ed errori
- Profiling/APM
Soltanto dopo questa analisi ha senso chiedersi se servono più CPU, RAM o una diversa infrastruttura.
Un approccio corretto alla performance analysis di Magento 2
Una performance audit efficace dovrebbe seguire un processo ripetibile:
Misurare → identificare → profilare → correggere → misurare nuovamente.
Non:
Magento è lento → aumentare il server → sperare.
Questo approccio consente anche di quantificare il risultato.
Per esempio:
PRIMA

Homepage TTFB:       1.850 ms
Categoria TTFB:      2.430 ms
Prodotto TTFB:       1.720 ms


DOPO

Homepage TTFB:         280 ms
Categoria TTFB:        410 ms
Prodotto TTFB:         320 ms
Numeri di questo tipo permettono di capire esattamente se l'intervento ha prodotto un miglioramento e dove.
Magento 2 lento? Parti da una diagnosi, non dal server
Le performance di Magento 2 sono il risultato dell'interazione tra applicazione, database, cache, ricerca, frontend, integrazioni e infrastruttura.
Per questo cambiare server dovrebbe essere una conseguenza della diagnosi, non il primo tentativo di soluzione.
Un'analisi tecnica può identificare query lente, problemi di cache, moduli inefficienti, chiamate esterne, cron problematici o configurazioni non ottimali che altrimenti continuerebbero a consumare risorse anche su un'infrastruttura più potente.
Prima di aumentare i costi del server, conviene quindi capire esattamente dove Magento sta perdendo tempo.
FAQ
Perché Magento 2 è lento?
Le cause possono essere numerose: cache non configurata correttamente, query SQL inefficienti, moduli di terze parti, codice custom, Redis, Varnish, OpenSearch, cron, API esterne o risorse server insufficienti. È necessario profilare l'applicazione per identificare il collo di bottiglia.
Come velocizzare Magento 2?
Bisogna prima misurare le performance e identificare il componente responsabile. Gli interventi possono riguardare Full Page Cache, Varnish, Redis, database, PHP-FPM, OpenSearch, codice custom, frontend e infrastruttura.
Magento 2 ha bisogno di Varnish?
Varnish è raccomandato per ottenere performance elevate nella gestione delle pagine cacheabili. La semplice installazione non è però sufficiente: occorre verificare hit rate, invalidazioni e corretta configurazione della cache.
Redis velocizza Magento 2?
Redis può migliorare la gestione di cache e sessioni, ma deve essere dimensionato e configurato correttamente. Un'istanza Redis satura o con elevata latenza può diventare un collo di bottiglia.
Come capire se Magento è lento per colpa del server?
È necessario monitorare CPU, memoria, I/O, PHP-FPM, database e altri servizi durante il carico reale. Se le risorse non sono sature, il problema potrebbe trovarsi nell'applicazione o nelle integrazioni.
Come trovare le query lente in Magento 2?
È possibile utilizzare gli strumenti del database, slow query log e sistemi APM/profiling per individuare query particolarmente costose o ripetute.
Perché Magento diventa lento con molti prodotti?
Cataloghi grandi aumentano il lavoro necessario per indexing, ricerca, categorie, attributi e operazioni sul database. La dimensione del catalogo, però, non è sufficiente da sola a spiegare le performance: architettura e configurazione rimangono determinanti.
Hyvä rende Magento più veloce?
Hyvä riduce notevolmente la complessità del frontend rispetto ad alcune implementazioni Magento tradizionali. Non risolve però automaticamente problemi backend relativi a database, PHP, cache, OpenSearch o integrazioni.
Aumentare CPU e RAM velocizza Magento?
Può farlo quando CPU o memoria rappresentano realmente il collo di bottiglia. Se il problema deriva da una query lenta, una chiamata API o codice inefficiente, aumentare le risorse può produrre benefici limitati.
Quando conviene fare una performance audit Magento?
Quando il sito presenta TTFB elevati, rallentamenti durante i picchi, categorie o checkout lenti, timeout, aumento progressivo delle risorse necessarie o performance peggiori dopo l'installazione di nuovi moduli o personalizzazioni.
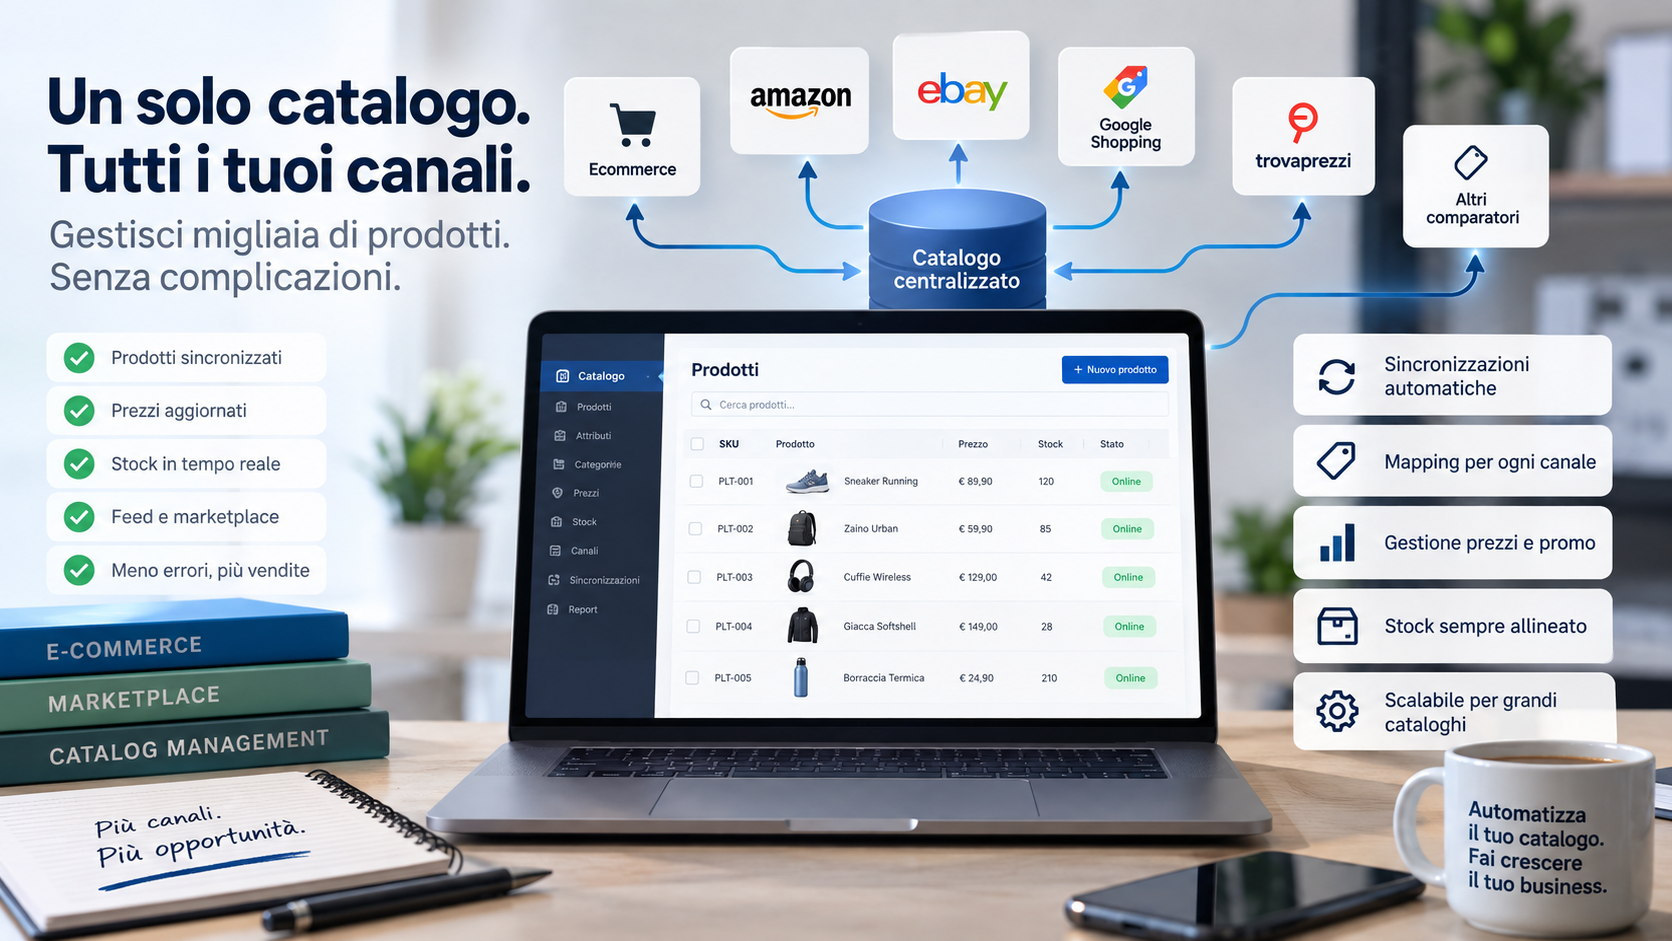
Come gestire migliaia di prodotti su ecommerce, marketplace e comparatori
Gestire un ecommerce con qualche centinaio di prodotti è relativamente semplice. La complessità cambia radicalmente quando il catalogo cresce e bisogna gestire migliaia o decine di migliaia di prodotti, magari pubblicati contemporaneamente sul sito ecommerce, su marketplace come Amazon ed eBay, su Google Shopping e su comparatori di prezzo come Trovaprezzi.
A quel punto aggiornare manualmente prezzi, disponibilità, descrizioni e attributi non è più soltanto inefficiente: diventa una fonte continua di errori.
La soluzione consiste nel trasformare il catalogo da un insieme di dati distribuiti tra piattaforme diverse a un flusso centralizzato e automatizzato, nel quale ogni sistema riceve le informazioni corrette nel formato richiesto.
In questo articolo vediamo come organizzare il catalog management di un ecommerce, come sincronizzare migliaia di prodotti su più canali e quali processi conviene automatizzare.
Perché gestire un catalogo ecommerce complesso diventa difficile
Un prodotto apparentemente semplice può essere composto da decine di informazioni:
- SKU e codici identificativi;
- EAN/GTIN;
- nome prodotto;
- descrizione;
- categoria;
- brand;
- immagini;
- attributi tecnici;
- prezzo;
- prezzo promozionale;
- disponibilità;
- quantità a magazzino;
- aliquota IVA;
- peso e dimensioni;
- tempi di consegna;
- informazioni specifiche richieste dai marketplace.
Quando il catalogo contiene 20.000 prodotti, anche soltanto 20 attributi per articolo significano potenzialmente 400.000 informazioni da mantenere coerenti.
La difficoltà aumenta ulteriormente perché gli stessi dati devono essere utilizzati da sistemi differenti.
Un ecommerce potrebbe, per esempio, utilizzare contemporaneamente:
- un gestionale o ERP;
- Magento, Adobe Commerce, WooCommerce o un'altra piattaforma ecommerce;
- Amazon;
- eBay;
- Google Merchant Center;
- Trovaprezzi;
- altri comparatori;
- sistemi pubblicitari;
- software di business intelligence;
- fornitori e distributori.
Il vero problema, quindi, non è semplicemente dove memorizzare i prodotti, ma stabilire quale sistema è responsabile di ogni informazione e come sincronizzarla con tutti gli altri.
Il problema dei cataloghi gestiti manualmente
Quando i dati vengono aggiornati manualmente su piattaforme differenti si creano inevitabilmente disallineamenti.
Un prodotto potrebbe risultare:
- disponibile sull'ecommerce ma esaurito nel gestionale;
- a €29,90 sul sito e €32,90 su un marketplace;
- in promozione su Google Shopping ma non sull'ecommerce;
- classificato correttamente sul sito ma nella categoria sbagliata su un comparatore;
- privo di EAN su un marketplace;
- pubblicato con immagini o descrizioni non aggiornate.
Con poche referenze questi problemi possono essere corretti manualmente.
Con migliaia di SKU, invece, il controllo manuale non scala.
Occorre cambiare approccio.
Centralizzare la gestione del catalogo
Il principio fondamentale di una buona architettura di catalog management è semplice:
ogni informazione deve avere una fonte autorevole e le altre piattaforme devono ricevere automaticamente gli aggiornamenti.
Non significa necessariamente utilizzare un unico database per tutto.
Significa definire chiaramente il master di ciascun dato.
Per esempio:
| Informazione | Sistema master |
|---|---|
| SKU | ERP |
| EAN | ERP/PIM |
| Nome prodotto | PIM |
| Descrizione | PIM |
| Immagini | PIM/DAM |
| Prezzo | ERP/Pricing Engine |
| Promozioni | Pricing Engine |
| Stock | ERP/WMS |
| Categorie ecommerce | Ecommerce/PIM |
| Mapping marketplace | Middleware/PIM |
Una volta stabilite le responsabilità, le informazioni possono essere distribuite automaticamente.
ERP, PIM, ecommerce e middleware: quali sono le differenze?
Quando si parla di cataloghi complessi vengono spesso utilizzati termini come ERP, PIM e middleware.
Non svolgono però la stessa funzione.
ERP
L'ERP o gestionale aziendale normalmente gestisce informazioni operative come:
- anagrafiche;
- codici prodotto;
- acquisti;
- fornitori;
- prezzi;
- magazzino;
- disponibilità;
- ordini;
- fatturazione.
Non sempre è lo strumento migliore per gestire informazioni commerciali particolarmente ricche.
PIM
Un Product Information Management (PIM) è invece progettato per organizzare e arricchire le informazioni di prodotto.
Può gestire:
- descrizioni;
- attributi;
- tassonomie;
- traduzioni;
- immagini;
- documentazione;
- informazioni tecniche;
- dati specifici per determinati canali.
Ecommerce
La piattaforma ecommerce dovrebbe principalmente occuparsi della vendita online.
Utilizzarla come unico repository aziendale di tutte le informazioni può creare forti dipendenze tecnologiche e rendere più difficili le integrazioni.
Middleware
Il middleware si colloca tra i diversi sistemi e orchestra gli scambi di informazioni.
Un'architettura semplificata può essere:
ERP / Gestionale → Middleware → Ecommerce → Marketplace / Comparatori
oppure:
ERP + PIM → Middleware → Ecommerce + Marketplace + Comparatori
Il middleware può inoltre applicare trasformazioni, mapping e regole prima di distribuire i dati.
Sincronizzare migliaia di prodotti automaticamente
Una sincronizzazione efficace non dovrebbe necessariamente trasferire continuamente l'intero catalogo.
Un sistema moderno dovrebbe identificare ciò che è cambiato.
Supponiamo di avere un catalogo da 50.000 prodotti.
Durante un'ora potrebbero cambiare:
- 320 disponibilità;
- 40 prezzi;
- 12 promozioni;
- 8 descrizioni;
- 3 nuovi prodotti.
Non avrebbe senso elaborare ogni volta tutte le 50.000 referenze.
È molto più efficiente lavorare attraverso aggiornamenti incrementali.
Il sistema identifica i prodotti modificati e propaga soltanto le informazioni necessarie.
Questo riduce:
- traffico;
- chiamate API;
- tempi di elaborazione;
- carico sui server;
- possibilità di errore.
API, feed e code di messaggi
Esistono diversi modi per sincronizzare un catalogo.
API
Le API permettono ai sistemi di comunicare direttamente.
Sono particolarmente utili quando servono aggiornamenti frequenti o quasi real-time.
Esempio:
Gestionale → API → Middleware → API → Ecommerce
Quando cambia una disponibilità, l'informazione può essere propagata rapidamente agli altri sistemi.
Feed
Comparatori e piattaforme pubblicitarie utilizzano frequentemente feed XML, CSV o altri formati strutturati.
Un feed potrebbe contenere:
SKU
EAN
Nome
URL
Immagine
Prezzo
Prezzo promozionale
Disponibilità
Categoria
Brand
Il sistema di catalog management deve quindi generare automaticamente il formato richiesto da ciascun destinatario.
Eventi e code
Nelle architetture più evolute è possibile utilizzare un approccio event-driven.
Quando avviene qualcosa, viene generato un evento.
Per esempio:
ProductCreated
ProductUpdated
PriceChanged
StockChanged
PromotionStarted
PromotionEnded
I diversi servizi possono reagire agli eventi e aggiornare i sistemi interessati.
Questo approccio permette di costruire integrazioni più robuste e scalabili.
Ogni marketplace richiede dati diversi
Uno degli errori più frequenti consiste nel pensare che basti esportare lo stesso catalogo verso tutti i canali.
In realtà ogni piattaforma può avere requisiti differenti.
Amazon può richiedere determinati attributi.
Google Merchant può utilizzare una propria tassonomia.
Un comparatore di prezzi può richiedere specifici campi nel feed.
eBay può avere categorie e caratteristiche differenti dall'ecommerce.
Serve quindi un livello di mapping.
Per esempio:
Categoria interna:
Integratori > Vitamine > Vitamina C

Google:
Health & Beauty > Health Care

Marketplace:
Salute > Integratori > Vitamine

Comparatore:
Integratori alimentari
Il prodotto rimane uno solo, ma la sua rappresentazione cambia in funzione del canale.
Gestire prezzi differenti per ogni canale
La multicanalità introduce un'altra complessità: il prezzo.
Non è detto che lo stesso prodotto debba avere lo stesso prezzo ovunque.
Si possono applicare regole come:
Prezzo ecommerce = prezzo base

Prezzo marketplace =
prezzo base
+ commissione marketplace
+ costo logistico

Prezzo promozionale =
prezzo base - sconto

Prezzo minimo =
costo prodotto + margine minimo
In questo caso il catalog management può essere collegato a un pricing engine.
Questo permette di automatizzare:
- prezzi;
- promozioni;
- markup;
- markdown;
- soglie di marginalità;
- prezzi specifici per marketplace;
- strategie di repricing.
Sincronizzare correttamente le disponibilità
La disponibilità è probabilmente una delle informazioni più critiche.
Vendere un prodotto non realmente disponibile può causare:
- annullamento dell'ordine;
- ritardi;
- aumento delle richieste al customer care;
- recensioni negative;
- penalizzazioni sui marketplace.
Per questo lo stock dovrebbe essere aggiornato frequentemente a partire dal sistema che conosce realmente la disponibilità: normalmente ERP o WMS.
In alcuni scenari è inoltre utile applicare un buffer di sicurezza.
Se il magazzino contiene 5 unità, per esempio, il marketplace potrebbe ricevere una disponibilità di 3.
In questo modo si riduce il rischio di overselling quando più canali vendono contemporaneamente lo stesso articolo.
Validare i dati prima della pubblicazione
Automatizzare non significa pubblicare qualsiasi dato automaticamente.
Prima di distribuire un prodotto è opportuno applicare delle regole di validazione.
Un prodotto potrebbe essere pubblicabile soltanto se:
SKU presente
EAN valido
Nome presente
Categoria assegnata
Prezzo > 0
Immagine presente
Disponibilità > 0
Brand valorizzato
Se una condizione non viene rispettata, il prodotto può essere inserito in una coda di errore.
L'operatore deve quindi vedere chiaramente:
- prodotto;
- canale;
- errore;
- data;
- ultimo tentativo;
- azione richiesta.
Questo trasforma la gestione del catalogo da un processo manuale a una gestione per eccezioni.
Ed è uno dei passaggi fondamentali per amministrare cataloghi molto grandi.
Gestire per eccezioni invece che per prodotti
Con 50.000 prodotti non è realistico controllare quotidianamente 50.000 schede.
Bisogna controllare soltanto ciò che presenta anomalie.
Una dashboard potrebbe mostrare:
Prodotti totali:        52.430
Pubblicati:              51.820
Con errori:                 173
Senza EAN:                   84
Prezzo anomalo:              21
Stock non sincronizzato:     12
Feed rifiutati:               7
L'operatore non deve quindi "gestire 52.430 prodotti".
Deve gestire 297 eccezioni.
È una differenza organizzativa enorme.
Monitorare tutte le sincronizzazioni
Un sistema di catalog management dovrebbe fornire completa visibilità sui processi automatici.
Per ogni sincronizzazione è utile conoscere:
- ultima esecuzione;
- durata;
- numero di prodotti elaborati;
- prodotti aggiornati;
- errori;
- warning;
- retry effettuati.
È inoltre opportuno configurare notifiche quando:
- un feed non viene generato;
- un marketplace rifiuta molti prodotti;
- una API smette di rispondere;
- il numero di errori supera una soglia;
- una sincronizzazione non viene eseguita entro il tempo previsto.
L'automazione senza monitoring rischia infatti di trasformare un problema evidente in un problema invisibile.
Catalog management per ecommerce farmaceutici
La complessità aumenta ulteriormente in settori caratterizzati da cataloghi molto grandi e informazioni provenienti da fonti differenti.
Un ecommerce farmaceutico, per esempio, può dover combinare:
- dati del gestionale;
- informazioni Farmadati;
- disponibilità interne;
- disponibilità dei fornitori;
- prezzi di acquisto;
- prezzi ecommerce;
- promozioni;
- informazioni commerciali;
- feed per Trovaprezzi;
- Google Merchant;
- marketplace;
- dati relativi ai concorrenti.
In questi scenari il problema non è semplicemente "importare prodotti".
Serve una vera orchestrazione del catalogo.
Un esempio di architettura
Una possibile architettura potrebbe essere:
                 ┌──────────────┐
                 │ Gestionale   │
                 └──────┬───────┘
                        │
                 ┌──────▼───────┐
                 │ Catalog Hub  │
                 │ / Middleware │
                 └──────┬───────┘
                        │
       ┌────────────────┼─────────────────┐
       │                │                 │
       ▼                ▼                 ▼
   Ecommerce       Marketplace       Comparatori
       │                │                 │
       ▼                ▼                 ▼
 Magento /          Amazon /          Google /
 WooCommerce          eBay           Trovaprezzi
Il Catalog Hub diventa il punto nel quale vengono applicate:
- normalizzazione;
- validazione;
- mapping;
- trasformazione;
- regole di pricing;
- sincronizzazione;
- monitoring.
Quando serve davvero un sistema di catalog management?
Non esiste una soglia universale.
Il numero di prodotti è soltanto uno dei fattori.
Un catalogo di 2.000 prodotti distribuito su sei canali può essere molto più complesso di un catalogo da 30.000 prodotti venduto esclusivamente attraverso un ecommerce.
I segnali più importanti sono altri:
- molti aggiornamenti manuali;
- prezzi differenti tra piattaforme;
- frequenti errori di stock;
- feed modificati manualmente;
- difficoltà nel capire quale sistema contiene il dato corretto;
- nuovi marketplace difficili da integrare;
- operatori impegnati continuamente a correggere prodotti;
- aggiornamenti che richiedono ore;
- errori scoperti dai clienti anziché dai sistemi di monitoring.
Quando questi problemi diventano frequenti, è il processo di catalog management che deve essere riprogettato.
I vantaggi dell'automazione del catalogo
Centralizzare e automatizzare la gestione permette innanzitutto di ridurre il lavoro manuale.
Ma il vantaggio più importante è la scalabilità.
Con una buona architettura, passare da:
5.000 → 20.000 → 50.000 prodotti
oppure da:
1 → 3 → 8 canali di vendita
non dovrebbe comportare un aumento proporzionale del personale necessario per amministrare il catalogo.
L'obiettivo è costruire un'infrastruttura nella quale siano i sistemi a gestire il normale flusso operativo e le persone intervengano soltanto sulle eccezioni.
Conclusioni
Gestire migliaia di prodotti su ecommerce, marketplace e comparatori non è principalmente un problema di quantità.
È un problema di architettura del dato e sincronizzazione.
ERP, PIM, ecommerce, marketplace e comparatori devono far parte di un flusso nel quale sia sempre chiaro:
- da dove proviene il dato;
- quale sistema ne è responsabile;
- come viene trasformato;
- dove deve essere pubblicato;
- cosa succede quando qualcosa va storto.
Centralizzare il catalog management, automatizzare le sincronizzazioni e gestire le anomalie per eccezione permette di mantenere sotto controllo anche cataloghi con decine di migliaia di prodotti.
Ed è soprattutto ciò che rende possibile aggiungere nuovi marketplace, comparatori e canali di vendita senza moltiplicare il lavoro operativo.
FAQ
Come gestire un ecommerce con migliaia di prodotti?
La soluzione più efficace consiste nel centralizzare le informazioni e automatizzare la sincronizzazione tra gestionale, PIM, ecommerce, marketplace e comparatori. Gli operatori dovrebbero intervenire principalmente sulle eccezioni anziché aggiornare manualmente i singoli prodotti.
Cos'è il catalog management?
Il catalog management comprende i processi utilizzati per raccogliere, organizzare, arricchire, validare e distribuire le informazioni relative ai prodotti sui diversi canali digitali.
Qual è la differenza tra PIM ed ERP?
L'ERP gestisce principalmente processi operativi e amministrativi come acquisti, magazzino, ordini e disponibilità. Il PIM è specializzato nella gestione e nell'arricchimento delle informazioni di prodotto destinate ai diversi canali.
Come sincronizzare ecommerce e marketplace?
La sincronizzazione può essere realizzata attraverso API, feed o architetture event-driven. È consigliabile utilizzare un middleware che gestisca mapping, trasformazioni, errori e regole specifiche per ciascun marketplace.
Come evitare prezzi diversi tra ecommerce e marketplace?
È necessario stabilire una fonte autorevole per il prezzo e distribuire automaticamente gli aggiornamenti. Se i prezzi devono essere differenti per canale, è possibile utilizzare regole di pricing centralizzate.
Come evitare di vendere prodotti non disponibili?
Le disponibilità dovrebbero essere sincronizzate frequentemente dal sistema responsabile del magazzino. È possibile inoltre utilizzare stock buffer per ridurre il rischio di overselling tra più canali.
Come gestire 50.000 prodotti senza controllarli manualmente?
Attraverso una gestione per eccezioni. Il sistema controlla automaticamente dati, sincronizzazioni e pubblicazioni e segnala soltanto i prodotti che presentano anomalie.
È necessario un PIM per gestire migliaia di prodotti?
Non necessariamente. Dipende dalla complessità delle informazioni e dal numero di canali. In alcuni progetti ERP, ecommerce e middleware sono sufficienti; in altri casi un PIM diventa fondamentale per centralizzare e arricchire le informazioni.
Come pubblicare lo stesso catalogo su Google, Trovaprezzi, Amazon ed eBay?
È necessario mantenere un catalogo centrale e creare mapping specifici per ciascun canale. Ogni destinazione può infatti avere categorie, attributi, formati e requisiti differenti.
Perché utilizzare un middleware per il catalogo ecommerce?
Un middleware disaccoppia i sistemi e centralizza sincronizzazioni, mapping, trasformazioni, validazioni e monitoring. Questo rende più semplice aggiungere nuovi canali senza creare integrazioni punto-punto difficili da mantenere.
Fonti e approfondimenti
Per approfondire gli standard e i concetti citati nell'articolo:
- Google Merchant Center — specifiche e requisiti dei dati prodotto.
- GS1 — standard GTIN e identificazione dei prodotti.
- Adobe Commerce Developer Documentation — catalogo e integrazioni.
- Amazon Selling Partner API — integrazione dei cataloghi marketplace.
- eBay Developers Program — API per inventory e listing.
- Akeneo — documentazione e concetti relativi al Product Information Management.
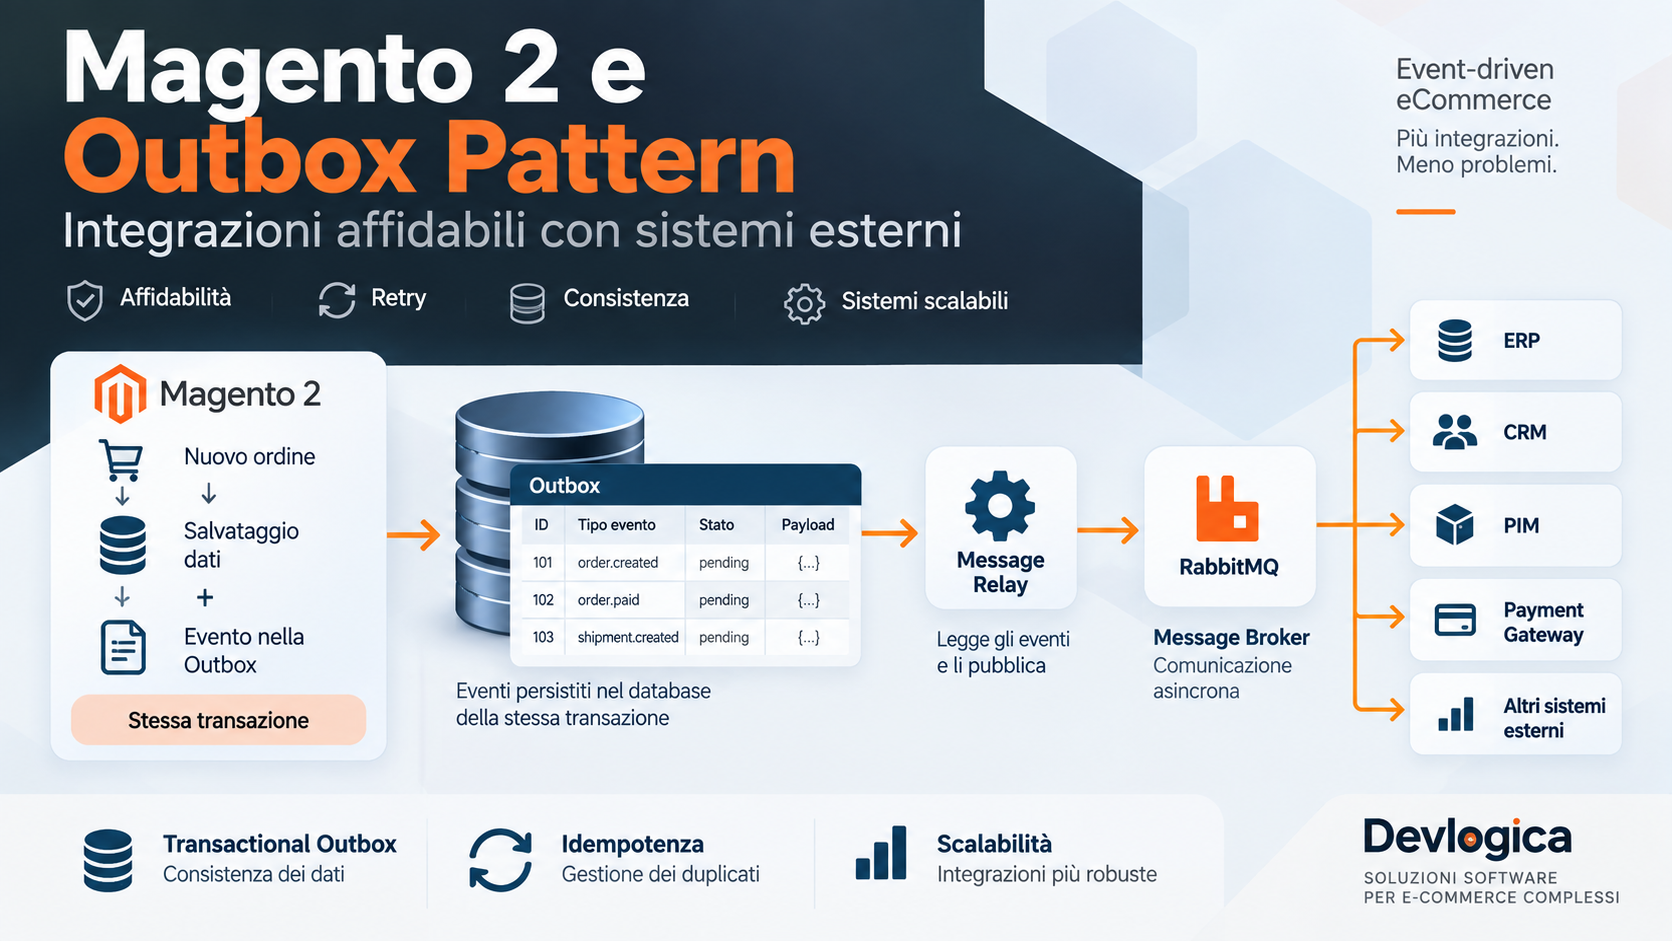
Magento 2 e Outbox Pattern: integrazioni affidabili con sistemi esterni
Integrare Magento 2 con ERP, OMS, CRM, PIM, sistemi di pagamento, middleware e servizi esterni è una delle attività più comuni nei progetti ecommerce enterprise.
Ma cosa succede quando Magento salva correttamente un ordine nel database e, subito dopo, la chiamata verso il sistema esterno fallisce?
Oppure quando un messaggio viene inviato a RabbitMQ, ma la transazione Magento che avrebbe dovuto generarlo viene successivamente annullata?
Sono problemi tipici dei sistemi distribuiti.
Una soluzione architetturale particolarmente efficace è il Transactional Outbox Pattern, comunemente chiamato semplicemente Outbox Pattern.
In questo articolo vediamo perché è utile nelle integrazioni Magento 2, quale problema risolve e come implementarlo in un modulo Adobe Commerce/Magento Open Source.
Il problema: Magento e i sistemi esterni non condividono la stessa transazione
Consideriamo un caso molto comune.
Quando viene creato un ordine dobbiamo:
- salvare l'ordine in Magento;
- notificare l'ordine a un ERP.
Una prima implementazione potrebbe essere concettualmente simile a questa:
$orderRepository->save($order);

$erpClient->sendOrder($order);
Sembra ragionevole.
Il problema è che abbiamo due operazioni indipendenti:
Magento Database
       +
External ERP
Non esiste una transazione ACID che comprenda entrambe.
Possiamo quindi trovarci in questa situazione:
SAVE ORDER
    ↓
COMMIT DATABASE
    ↓
CALL ERP
    ↓
TIMEOUT
Magento contiene l'ordine.
L'ERP no.
Il sistema è entrato in uno stato inconsistente.
Il problema del Dual Write
In architettura distribuita questo scenario viene generalmente chiamato dual write problem.
Un'operazione di business deve modificare due sistemi differenti:
Database Magento
       +
Sistema esterno
e vorremmo che entrambe le operazioni fossero atomiche.
Idealmente:
BEGIN TRANSACTION

SAVE ORDER
SEND ORDER TO ERP

COMMIT
Ma il database Magento non può effettuare il rollback di una richiesta HTTP già elaborata dall'ERP.
Allo stesso modo, l'ERP non partecipa normalmente alla transazione MySQL di Magento.
Il problema diventa ancora più evidente se utilizziamo un message broker.
Supponiamo di fare:
$orderRepository->save($order);

$publisher->publish(
    'order.created',
    $message
);
Abbiamo comunque due sistemi:
MySQL
 +
RabbitMQ
Anche in questo caso le operazioni non sono automaticamente atomiche.
Perché pubblicare l'evento prima del commit non risolve il problema
Potremmo provare a pubblicare il messaggio prima del commit:
BEGIN TRANSACTION

SAVE ORDER

PUBLISH EVENT
        ↓
     RabbitMQ

COMMIT
Ma immaginiamo che RabbitMQ riceva correttamente il messaggio e successivamente il database effettui un rollback.
Avremo:
RabbitMQ → OrderCreated #123

Magento → Order #123 NON ESISTE
Il consumer potrebbe quindi elaborare un evento relativo a uno stato che non è mai stato realmente confermato nel sistema sorgente.
Pubblicare dopo il commit non basta
Possiamo invertire il problema:
BEGIN TRANSACTION

SAVE ORDER

COMMIT

PUBLISH EVENT
Ora siamo sicuri che l'ordine esista.
Ma cosa succede se il processo PHP termina subito dopo il commit?
COMMIT
   ↓
PHP PROCESS CRASH
   ↓
EVENT NOT PUBLISHED
L'ordine esiste nel database, ma nessun sistema esterno ne viene informato.
Abbiamo eliminato un problema creandone un altro.
Il Transactional Outbox Pattern
L'Outbox Pattern cambia completamente l'approccio.
Invece di cercare di aggiornare contemporaneamente database e sistema esterno, registriamo l'intenzione di inviare il messaggio nello stesso database della transazione principale.
L'architettura diventa:
                 ┌──────────────────────┐
                 │      Magento 2       │
                 │                      │
                 │  Business Operation  │
                 └──────────┬───────────┘
                            │
                       TRANSACTION
                            │
                ┌───────────┴───────────┐
                │                       │
                ▼                       ▼
        ┌───────────────┐       ┌───────────────┐
        │ sales_order   │       │    outbox     │
        │               │       │               │
        │ Order #123    │       │ OrderCreated  │
        └───────────────┘       └───────────────┘
                │                       │
                └───────────┬───────────┘
                            │
                          COMMIT
L'ordine e l'evento vengono salvati nella stessa transazione database.
Questa è la caratteristica fondamentale del pattern.
Se la transazione fallisce:
ROLLBACK
   ↓
Order     → NON salvato
Outbox    → NON salvato
Se invece la transazione viene confermata:
COMMIT
   ↓
Order     → salvato
Outbox    → salvato
Non può esistere uno senza l'altro, purché entrambi partecipino realmente alla stessa transazione.
Il Message Relay
A questo punto non abbiamo ancora inviato nulla all'ERP.
Abbiamo soltanto registrato l'evento.
Serve quindi un secondo componente:
Message Relay
Il suo compito è leggere gli eventi pendenti dalla tabella outbox.
Magento Transaction
       │
       ▼
┌──────────────┐
│    Outbox    │
└──────┬───────┘
       │
       │ read pending events
       ▼
┌──────────────┐
│ Message Relay│
└──────┬───────┘
       │
       ▼
    RabbitMQ
       │
       ▼
    Consumer
       │
       ▼
      ERP
Il relay può essere implementato attraverso:
- cron Magento;
- CLI command;
- background worker;
- consumer dedicato;
- processo esterno;
- Change Data Capture, in architetture più avanzate.
In una prima implementazione Magento, cron o worker sono spesso sufficienti.
Progettare una Outbox Table in Magento 2
Possiamo creare una tabella dedicata:
devlogica_outbox_event
con una struttura concettuale simile:
event_id
event_uuid
event_type
aggregate_type
aggregate_id
payload
status
attempts
created_at
available_at
processed_at
last_error
Per esempio:
| Campo | Valore |
|---|---|
| event_uuid | 550e8400-e29b-41d4-a716-446655440000 |
| event_type | order.created |
| aggregate_type | order |
| aggregate_id | 123 |
| status | pending |
| attempts | 0 |
| created_at | 2026-09-14 09:30:00 |
Il payload potrebbe essere JSON:
{
    "event_id": "550e8400-e29b-41d4-a716-446655440000",
    "event_type": "order.created",
    "order_id": 123,
    "increment_id": "000000123",
    "store_id": 1
}
Declarative Schema Magento 2
La tabella può essere creata tramite db_schema.xml.
Un esempio semplificato:
<table name="devlogica_outbox_event"
       resource="default"
       engine="innodb"
       comment="Transactional Outbox Events">

    <column xsi:type="bigint"
            name="event_id"
            unsigned="true"
            nullable="false"
            identity="true"
            comment="Event ID"/>

    <column xsi:type="varchar"
            name="event_uuid"
            nullable="false"
            length="36"
            comment="Event UUID"/>

    <column xsi:type="varchar"
            name="event_type"
            nullable="false"
            length="255"
            comment="Event Type"/>

    <column xsi:type="varchar"
            name="aggregate_type"
            nullable="false"
            length="100"
            comment="Aggregate Type"/>

    <column xsi:type="varchar"
            name="aggregate_id"
            nullable="false"
            length="255"
            comment="Aggregate ID"/>

    <column xsi:type="text"
            name="payload"
            nullable="false"
            comment="Event Payload"/>

    <column xsi:type="varchar"
            name="status"
            nullable="false"
            length="32"
            default="pending"
            comment="Status"/>

    <column xsi:type="int"
            name="attempts"
            unsigned="true"
            nullable="false"
            default="0"
            comment="Attempts"/>

    <column xsi:type="timestamp"
            name="created_at"
            nullable="false"
            default="CURRENT_TIMESTAMP"
            comment="Created At"/>

    <column xsi:type="timestamp"
            name="available_at"
            nullable="true"
            comment="Available At"/>

    <column xsi:type="timestamp"
            name="processed_at"
            nullable="true"
            comment="Processed At"/>

    <column xsi:type="text"
            name="last_error"
            nullable="true"
            comment="Last Error"/>

    <constraint xsi:type="primary"
                referenceId="PRIMARY">
        <column name="event_id"/>
    </constraint>

    <constraint xsi:type="unique"
                referenceId="DEVLOGICA_OUTBOX_EVENT_UUID">
        <column name="event_uuid"/>
    </constraint>

    <index referenceId="DEVLOGICA_OUTBOX_STATUS_AVAILABLE"
           indexType="btree">
        <column name="status"/>
        <column name="available_at"/>
    </index>

</table>
In produzione gli indici devono naturalmente essere progettati in funzione del volume e delle query effettuate dal relay.
Outbox Writer
È utile isolare completamente la creazione degli eventi.
Per esempio:
interface OutboxWriterInterface
{
    public function add(
        string $eventType,
        string $aggregateType,
        string $aggregateId,
        array $payload
    ): void;
}
Una possibile implementazione:
final class OutboxWriter implements OutboxWriterInterface
{
    public function __construct(
        private readonly ResourceConnection $resource,
        private readonly SerializerInterface $serializer
    ) {
    }

    public function add(
        string $eventType,
        string $aggregateType,
        string $aggregateId,
        array $payload
    ): void {
        $connection = $this->resource->getConnection();

        $connection->insert(
            $this->resource->getTableName(
                'devlogica_outbox_event'
            ),
            [
                'event_uuid' => Uuid::uuid4()->toString(),
                'event_type' => $eventType,
                'aggregate_type' => $aggregateType,
                'aggregate_id' => $aggregateId,
                'payload' => $this->serializer->serialize($payload),
                'status' => 'pending',
                'attempts' => 0,
            ]
        );
    }
}
Il punto importante non è tanto la classe in sé.
È dove viene eseguita questa INSERT.
La Outbox deve partecipare alla stessa transazione
Questo è il dettaglio che distingue un vero Transactional Outbox da una semplice tabella utilizzata come coda.
L'operazione:
SAVE BUSINESS DATA
e:
INSERT OUTBOX EVENT
devono appartenere alla stessa transazione database.
Concettualmente:
$connection->beginTransaction();

try {

    // modifica stato applicativo
    $this->processBusinessOperation();

    // registra evento
    $this->outboxWriter->add(
        'order.export.requested',
        'order',
        (string)$orderId,
        $payload
    );

    $connection->commit();

} catch (\Throwable $exception) {

    $connection->rollBack();

    throw $exception;
}
Se qualcosa fallisce, entrambe le modifiche vengono annullate.
Non mettere la chiamata HTTP nella transazione
Un errore importante sarebbe fare:
$connection->beginTransaction();

try {

    $orderRepository->save($order);

    $erpClient->sendOrder($order);

    $connection->commit();

} catch (\Throwable $e) {

    $connection->rollBack();
}
Tecnicamente possiamo mantenere aperta la transazione mentre effettuiamo la chiamata HTTP.
Architetturalmente è una pessima idea.
Una richiesta esterna potrebbe impiegare:
50 ms
500 ms
5 secondi
30 secondi
TIMEOUT
Durante questo periodo manteniamo aperta una transazione database, aumentando potenzialmente lock contention, tempi di risposta e rischio di failure.
Con Outbox, la transazione deve essere breve:
BEGIN
 ↓
business update
 ↓
insert outbox
 ↓
COMMIT
La comunicazione lenta viene spostata fuori dalla transazione.
Outbox + RabbitMQ in Magento 2
Magento/Adobe Commerce dispone già di un Message Queue Framework.
Possiamo quindi utilizzare l'Outbox come livello di affidabilità prima della pubblicazione sul broker.
L'architettura diventa:
                    MAGENTO
                       │
                 DB TRANSACTION
                       │
              ┌────────┴────────┐
              │                 │
              ▼                 ▼
         sales_order          outbox
              │                 │
              └──────COMMIT─────┘
                                │
                                ▼
                         Outbox Publisher
                                │
                                ▼
                           RabbitMQ
                                │
                                ▼
                       Magento Consumer
                                │
                                ▼
                              ERP
È importante capire che:
RabbitMQ e Outbox non sono alternative.
Risolvono problemi differenti.
RabbitMQ gestisce la comunicazione asincrona.
L'Outbox garantisce che l'intenzione di pubblicare il messaggio sia persistita atomicamente insieme alla modifica di business.
Perché RabbitMQ da solo non risolve il Dual Write
Consideriamo:
$orderRepository->save($order);

$publisher->publish(
    'devlogica.order.export',
    $message
);
Abbiamo comunque:
DB WRITE
   ↓
BROKER WRITE
Se il processo muore tra le due operazioni:
Order saved
Message missing
L'Outbox elimina questa finestra.
DB TRANSACTION

Order saved
+
Outbox saved

COMMIT
Dopo il commit il messaggio può essere pubblicato anche qualche secondo dopo.
Abbiamo accettato eventual consistency per ottenere maggiore affidabilità.
Il publisher della Outbox
Un worker può recuperare gli eventi:
SELECT *
FROM devlogica_outbox_event
WHERE status = 'pending'
AND (
    available_at IS NULL
    OR available_at <= NOW()
)
ORDER BY event_id
LIMIT 100;
Per ogni evento:
READ EVENT
    ↓
PUBLISH TO RABBITMQ
    ↓
SUCCESS?
   /     \
 YES      NO
 ↓         ↓
SENT      RETRY
Pseudo-codice:
foreach ($events as $event) {

    try {

        $publisher->publish(
            $event->getEventType(),
            $event->getPayload()
        );

        $repository->markAsProcessed(
            $event->getId()
        );

    } catch (\Throwable $exception) {

        $repository->markAsFailed(
            $event->getId(),
            $exception->getMessage()
        );
    }
}
Ma anche qui esiste un problema interessante.
Cosa succede se RabbitMQ riceve il messaggio ma Magento crasha?
Consideriamo:
PUBLISH
   ↓
RabbitMQ receives message
   ↓
PHP CRASH
   ↓
markAsProcessed() NON eseguito
Quando il worker riparte trova nuovamente:
status = pending
e ripubblica il messaggio.
Risultato:
MESSAGE #1
MESSAGE #1
Abbiamo un duplicato.
Questo comportamento non è necessariamente un bug.
È una conseguenza normale dei sistemi at-least-once delivery.
L'idempotenza è parte dell'architettura
Un sistema robusto deve assumere che un messaggio possa essere ricevuto più di una volta.
Ogni evento dovrebbe quindi avere un identificatore univoco:
{
    "event_id": "550e8400-e29b-41d4-a716-446655440000",
    "event_type": "order.created",
    "order_id": 123
}
Il consumer può mantenere una tabella:
processed_messages
con:
event_id
processed_at
Prima di elaborare:
EVENT RECEIVED
      ↓
event_id already processed?
      ↓
   YES   NO
    │     │
  IGNORE  PROCESS
Questo rende il consumer idempotente.
Idempotenza applicativa
In alcuni casi possiamo ottenere idempotenza direttamente attraverso la logica di dominio.
Per esempio:
Create shipment for order #123
potrebbe utilizzare una chiave:
magento-order-123-shipment
Se il sistema esterno riceve nuovamente la stessa richiesta:
POST /shipments

Idempotency-Key:
magento-order-123-shipment
può restituire il risultato precedente senza creare una seconda spedizione.
Questo approccio è particolarmente importante per:
- pagamenti;
- rimborsi;
- spedizioni;
- fatture;
- ordini ERP;
- movimenti finanziari.
Retry
Un'integrazione esterna non deve considerare ogni errore definitivo.
Un ERP potrebbe temporaneamente rispondere:
HTTP 503
oppure:
Connection timeout
In questi casi possiamo riprovare.
Una strategia semplice potrebbe essere:
attempt 1 → immediately
attempt 2 → +1 minute
attempt 3 → +5 minutes
attempt 4 → +15 minutes
attempt 5 → +1 hour
Questa tecnica è chiamata exponential backoff quando l'intervallo cresce progressivamente.
Il campo:
available_at
permette di stabilire quando un evento può essere nuovamente elaborato.
Non tutti gli errori devono essere ritentati
È importante distinguere:
Transient Failure
da:
Permanent Failure
Per esempio:
HTTP 503
Gateway Timeout
Connection refused
sono tipicamente candidati per un retry.
Mentre:
HTTP 400
Invalid SKU
Invalid Customer
Missing Required Field
potrebbero richiedere intervento umano o correzione dei dati.
Un'integrazione enterprise dovrebbe quindi classificare gli errori.
Dead Letter Queue
Dopo un certo numero di tentativi:
attempts >= MAX_ATTEMPTS
il messaggio non dovrebbe continuare a essere elaborato indefinitamente.
Possiamo spostarlo logicamente nello stato:
failed
oppure utilizzare una vera Dead Letter Queue (DLQ) sul broker.
Il flusso diventa:
EVENT
  ↓
PROCESS
  ↓
ERROR
  ↓
RETRY
  ↓
ERROR
  ↓
RETRY
  ↓
ERROR
  ↓
DLQ
  ↓
ALERT
Un operatore può quindi analizzare il problema e, dopo averlo risolto, effettuare il replay del messaggio.
Observability: l'integrazione deve essere osservabile
Un sistema affidabile non è semplicemente un sistema che effettua retry.
Deve permettere di capire cosa sta succedendo.
Per ogni evento dovremmo poter rispondere a domande come:
Quando è stato creato?
È stato pubblicato?
Quante volte abbiamo provato?
Qual è stato l'ultimo errore?
Quando verrà effettuato il prossimo retry?
È stato elaborato dall'ERP?
Per questo motivo una Outbox dovrebbe conservare almeno:
event_uuid
event_type
aggregate_id
created_at
status
attempts
available_at
processed_at
last_error
E nei log dovremmo sempre includere:
event_uuid
come correlation identifier.
Correlation ID
Consideriamo un ordine che attraversa:
Magento
   ↓
RabbitMQ
   ↓
Integration Service
   ↓
ERP
Senza un identificatore comune dobbiamo correlare manualmente log provenienti da sistemi diversi.
Con un correlation_id possiamo invece cercare:
CORRELATION_ID = abc-123
in tutta l'infrastruttura.
Un evento più completo potrebbe quindi essere:
{
    "event_id": "550e8400-e29b-41d4-a716-446655440000",
    "correlation_id": "9b856ac0-99d1-4ac6",
    "event_type": "order.created",
    "aggregate": {
        "type": "order",
        "id": "123"
    },
    "occurred_at": "2026-09-14T09:30:00Z",
    "payload": {
        "increment_id": "000000123"
    }
}
Event Payload: snapshot o riferimento?
Un'altra decisione architetturale importante riguarda il payload.
Possiamo salvare soltanto:
{
    "order_id": 123
}
e fare recuperare al consumer lo stato corrente dell'ordine.
Oppure possiamo salvare:
{
    "order_id": 123,
    "status": "processing",
    "total": 125.90,
    "currency": "EUR",
    "items": [...]
}
I due approcci hanno implicazioni differenti.
Reference
Outbox → order_id
            ↓
      load current order
È più leggero, ma il consumer potrebbe leggere uno stato diverso da quello esistente al momento dell'evento.
Snapshot
Outbox → complete event data
L'evento rappresenta esattamente ciò che è accaduto in quel momento.
Per veri domain event, lo snapshot è spesso preferibile.
Event versioning
Quando un'integrazione vive per anni, il formato degli eventi cambia.
Oggi:
{
    "order_id": 123
}
Domani:
{
    "order_id": 123,
    "store_id": 2
}
È quindi utile introdurre:
{
    "event_type": "order.created",
    "event_version": 2
}
Il consumer può così gestire versioni differenti senza rompere immediatamente la compatibilità.
Event naming
Anche il naming è importante.
Meglio utilizzare eventi che descrivono qualcosa che è accaduto:
order.created
order.cancelled
shipment.created
invoice.created
refund.created
customer.registered
rispetto a nomi eccessivamente legati all'implementazione:
send_order_to_erp
call_sap
update_external_system
Il primo approccio riduce l'accoppiamento.
Domani lo stesso evento:
order.created
potrebbe essere utilizzato da:
ERP
CRM
Data Warehouse
Marketing Automation
Fraud Detection
senza modificare il dominio Magento.
Outbox Pattern e Magento Events
Magento utilizza ampiamente eventi e observer.
Per esempio possiamo intercettare eventi relativi a:
order
invoice
shipment
customer
product
Ma un observer Magento non equivale automaticamente a un Outbox.
Questo:
public function execute(
    Observer $observer
): void {
    $order = $observer->getOrder();

    $this->erpClient->sendOrder($order);
}
introduce ancora una comunicazione sincrona con il sistema esterno.
Un observer può invece essere utilizzato per registrare un evento nella Outbox, purché sia garantita la corretta partecipazione alla transazione che vogliamo proteggere.
La distinzione è fondamentale:
Magento Event
     ≠
Transactional Outbox
L'Outbox è una garanzia architetturale sulla persistenza dell'evento.
Outbox Pattern vs Magento Message Queue
Anche questi due concetti non devono essere confusi.
| Funzione | Outbox | Message Queue |
|---|---|---|
| Atomicità con DB | ✓ | non automaticamente |
| Persistenza evento | ✓ | ✓ |
| Comunicazione asincrona | indiretta | ✓ |
| Retry | implementabile | ✓ |
| Scaling consumer | limitato | ✓ |
| Routing | limitato | ✓ |
| Disaccoppiamento | ✓ | ✓ |
La combinazione più robusta è spesso:
Transactional Outbox
        +
Message Broker
        +
Idempotent Consumer
Un'architettura Magento enterprise
In un ecommerce con diverse integrazioni possiamo arrivare a:
                        ┌─────────────────┐
                        │    Magento 2    │
                        └────────┬────────┘
                                 │
                         DB TRANSACTION
                                 │
                    ┌────────────┴────────────┐
                    │                         │
                    ▼                         ▼
              BUSINESS DATA                OUTBOX
                                              │
                                              ▼
                                       OUTBOX RELAY
                                              │
                                              ▼
                                         RabbitMQ
                                              │
               ┌──────────────────────────────┼─────────────────────────┐
               │                              │                         │
               ▼                              ▼                         ▼
          ERP Consumer                  CRM Consumer               PIM Consumer
               │                              │                         │
               ▼                              ▼                         ▼
              ERP                            CRM                       PIM
Magento diventa il produttore di eventi.
I sistemi esterni reagiscono agli eventi senza essere direttamente accoppiati alla transazione ecommerce.
Esempio: esportazione ordine verso ERP
Vediamo il flusso completo.
Il cliente completa il checkout:
PLACE ORDER
Magento esegue:
BEGIN TRANSACTION

INSERT sales_order
INSERT sales_order_item
INSERT outbox_event

COMMIT
La Outbox contiene:
order.created
Il relay legge l'evento:
OUTBOX
   ↓
RabbitMQ
Il consumer ERP riceve:
order.created
e chiama:
ERP API
Se l'ERP risponde correttamente:
SUCCESS
Se l'ERP non è disponibile:
ERROR
 ↓
RETRY
Dopo il limite massimo:
DLQ
 ↓
ALERT
Il checkout del cliente non dipende quindi dalla disponibilità momentanea dell'ERP.
Il vantaggio sulla customer experience
Questo aspetto è spesso sottovalutato.
Senza asincronicità:
Checkout
   ↓
Magento
   ↓
ERP call
   ↓
3 seconds
   ↓
response
il cliente paga direttamente la latenza dell'integrazione.
Con Outbox:
Checkout
   ↓
Magento transaction
   ↓
COMMIT
   ↓
response
e separatamente:
Outbox
   ↓
RabbitMQ
   ↓
ERP
Il sistema esterno non è più sul critical path della richiesta del cliente.
Cosa succede se l'ERP rimane offline per due ore?
Con un'integrazione sincrona potremmo avere:
ERP DOWN
   ↓
integration errors
   ↓
checkout problems
Con un'architettura asincrona:
ERP DOWN

Magento
 ↓
Outbox
 ↓
Queue
 ↓
Queue
 ↓
Queue
Quando l'ERP torna disponibile:
ERP UP
 ↓
Consumers restart processing
 ↓
backlog drained
Il sistema assorbe quindi temporaneamente il problema.
Questa proprietà viene spesso definita temporal decoupling.
Attenzione all'ordine degli eventi
Supponiamo che Magento generi rapidamente:
OrderCreated
OrderPaid
OrderCancelled
Il consumer dovrebbe idealmente elaborarli nello stesso ordine.
Altrimenti potremmo ricevere:
OrderCancelled
OrderCreated
OrderPaid
con risultati imprevedibili.
È quindi importante valutare:
- ordering;
- partition key;
- aggregate ID;
- sequence number;
- caratteristiche del broker utilizzato.
Una possibile struttura dell'evento può includere:
{
    "aggregate_id": "123",
    "sequence": 3
}
Il consumer può così identificare eventi fuori sequenza.
Exactly once: attenzione alla promessa
Nei sistemi distribuiti è meglio non progettare l'integrazione assumendo che ogni evento venga elaborato esattamente una volta end-to-end.
Una strategia molto più robusta consiste nel progettare per:
At-least-once delivery
+
Idempotent processing
Il sistema accetta quindi che un evento possa essere consegnato più volte, ma garantisce che elaborarlo nuovamente non produca effetti indesiderati.
Questa filosofia semplifica enormemente la costruzione di integrazioni resilienti.
Cleanup della Outbox
La tabella Outbox cresce continuamente.
Non conviene mantenere indefinitamente tutti gli eventi elaborati nel database operativo Magento.
Possiamo introdurre una retention policy:
processed > 30 days
        ↓
archive/delete
oppure:
processed > 90 days
        ↓
archive
La scelta dipende dai requisiti di audit.
Gli eventi failed, invece, potrebbero avere una retention differente.
Monitoraggio
In produzione dovremmo monitorare almeno:
Pending events
Oldest pending event
Events processed/minute
Failed events
Retry count
DLQ size
Consumer lag
Uno degli indicatori più utili è:
Age of oldest pending event
Se normalmente un evento viene elaborato entro pochi secondi e improvvisamente troviamo:
Oldest event = 47 minutes
probabilmente esiste un problema nel relay, nel broker o nel sistema downstream.
Quando utilizzare l'Outbox Pattern in Magento 2
L'Outbox è particolarmente utile quando Magento deve comunicare eventi importanti verso sistemi esterni.
Per esempio:
ERP
OrderCreated
OrderCancelled
InvoiceCreated
ShipmentCreated
RefundCreated
OMS
OrderPlaced
OrderAllocated
OrderCancelled
CRM
CustomerCreated
CustomerUpdated
Warehouse
ShipmentRequested
ReturnRequested
Payment systems
PaymentCaptured
PaymentVoided
RefundRequested
Data platform
OrderCreated
CustomerRegistered
ProductUpdated
Più critica è l'informazione, maggiore è il valore del pattern.
Quando l'Outbox Pattern può essere eccessivo
Non tutte le integrazioni richiedono questa complessità.
Per operazioni non critiche come:
invalidate cache
send analytics event
update optional recommendation data
la perdita occasionale di un evento potrebbe essere accettabile.
L'architettura deve sempre essere proporzionata al rischio.
Se invece stiamo sincronizzando:
ordini
pagamenti
fatture
spedizioni
rimborsi
stock
la consistenza diventa molto più importante.
Outbox Pattern: vantaggi
L'adozione del pattern permette di ottenere diversi benefici.
Affidabilità
Un evento non viene perso semplicemente perché il sistema esterno è temporaneamente indisponibile.
Atomicità locale
Business data ed evento vengono salvati nella stessa transazione database.
Disaccoppiamento
Magento non deve conoscere la disponibilità immediata del sistema downstream.
Performance
Le API esterne vengono rimosse dal critical path delle operazioni utente.
Retry
Gli errori temporanei possono essere recuperati automaticamente.
Observability
Ogni evento possiede uno stato persistente e può essere tracciato.
Scalabilità
L'elaborazione può essere distribuita attraverso message broker e consumer multipli.
Gli svantaggi
Naturalmente il pattern introduce anche complessità.
Dobbiamo gestire:
- tabella Outbox;
- publisher/relay;
- retry;
- idempotenza;
- cleanup;
- monitoring;
- ordering;
- versioning degli eventi;
- gestione degli errori.
Inoltre il sistema diventa eventually consistent.
Magento potrebbe avere già registrato l'ordine mentre l'ERP lo riceverà alcuni secondi dopo.
Nella maggior parte delle integrazioni enterprise questo compromesso è però preferibile a un'integrazione sincrona fragile.
Una possibile architettura di riferimento
Per un progetto Magento 2 con integrazioni enterprise adotteremmo una struttura simile:
Magento Domain
      │
      ▼
Domain/Application Event
      │
      ▼
Transactional Outbox
      │
      ▼
Outbox Publisher
      │
      ▼
RabbitMQ
      │
      ▼
Idempotent Consumer
      │
      ▼
Integration Service
      │
      ▼
ERP / OMS / CRM / External API
accompagnata da:
Retry
Backoff
DLQ
Correlation ID
Event Versioning
Monitoring
Alerting
Non stiamo più semplicemente "chiamando un'API".
Stiamo progettando una integrazione distribuita affidabile.
Conclusioni
Integrare Magento 2 con un sistema esterno attraverso una semplice chiamata HTTP può funzionare nei progetti più piccoli, ma diventa fragile quando l'integrazione riguarda processi critici come ordini, pagamenti, spedizioni, fatture e stock.
Il problema fondamentale è il dual write:
Magento Database
+
External System
non possono normalmente essere aggiornati all'interno della stessa transazione.
Il Transactional Outbox Pattern risolve il problema cambiando strategia:
Business Data
+
Outbox Event
vengono salvati atomicamente nello stesso database.
Successivamente:
Outbox
  ↓
Message Broker
  ↓
Consumer
  ↓
External System
gestisce la comunicazione asincrona.
Combinando Transactional Outbox, RabbitMQ, retry, idempotenza, DLQ e observability è possibile costruire integrazioni Magento 2 molto più robuste e adatte a contesti enterprise.
Il punto centrale non è evitare completamente gli errori.
Nei sistemi distribuiti gli errori sono inevitabili.
L'obiettivo architetturale è costruire un sistema capace di assorbirli, ritentare le operazioni e recuperare automaticamente senza perdere informazioni.
FAQ
Cos'è l'Outbox Pattern in Magento 2?
Il Transactional Outbox Pattern consiste nel salvare un evento destinato a sistemi esterni nello stesso database e nella stessa transazione della modifica di business che lo ha generato. Un processo separato pubblica successivamente l'evento verso RabbitMQ o un altro sistema di messaging.
Perché usare l'Outbox Pattern con Magento 2?
È particolarmente utile nelle integrazioni con ERP, OMS, CRM, warehouse, sistemi di pagamento e altri servizi esterni, perché riduce il rischio di perdere eventi quando una modifica Magento è stata salvata ma la comunicazione esterna fallisce.
RabbitMQ sostituisce l'Outbox Pattern?
No. RabbitMQ gestisce il messaging asincrono, mentre l'Outbox risolve il problema dell'atomicità tra la modifica dei dati applicativi e l'intenzione di pubblicare un evento. Le due tecnologie possono essere utilizzate insieme.
L'Outbox Pattern garantisce exactly-once delivery?
Non necessariamente. Il relay può pubblicare nuovamente un messaggio se si verifica un errore dopo la pubblicazione ma prima dell'aggiornamento dello stato dell'Outbox. Per questo motivo i consumer dovrebbero essere idempotenti.
Cosa significa consumer idempotente?
Significa che elaborare più volte lo stesso evento produce lo stesso risultato di una singola elaborazione. Una strategia comune consiste nell'assegnare un UUID a ogni evento e registrare gli identificativi già elaborati.
È possibile implementare l'Outbox con RabbitMQ?
Sì. Una soluzione comune consiste nel salvare gli eventi nella Outbox durante la transazione Magento e utilizzare successivamente un relay per pubblicarli sul Message Queue Framework di Magento, utilizzando RabbitMQ come broker.
È necessario utilizzare RabbitMQ?
No. L'Outbox Pattern è indipendente dal broker. Gli eventi possono essere elaborati direttamente da un worker oppure pubblicati verso RabbitMQ, ActiveMQ, Kafka, SQS o altre infrastrutture di messaging, a seconda dell'architettura.
Outbox Pattern e Magento Observer sono la stessa cosa?
No. Un observer è un meccanismo applicativo per reagire agli eventi Magento. L'Outbox Pattern riguarda invece la persistenza transazionale affidabile dell'evento. Un observer può contribuire alla creazione dell'evento Outbox, ma non rende automaticamente l'operazione transazionale.
Come gestire gli errori verso ERP o API esterne?
È consigliabile distinguere gli errori temporanei da quelli permanenti, applicare retry con backoff ai primi e spostare gli eventi non recuperabili in uno stato failed o in una Dead Letter Queue.
Quali integrazioni Magento beneficiano maggiormente dell'Outbox?
Soprattutto quelle relative a ordini, pagamenti, rimborsi, fatture, spedizioni, resi, disponibilità e altre operazioni in cui la perdita di un messaggio può creare inconsistenze di business., Adobe Commerce Developer, Software Architect, Tech Lead, Solution Architect.
Fonti e approfondimenti
Adobe Commerce Developer Documentation — Message Queues
Documentazione ufficiale Adobe relativa al Message Queue Framework, ai consumer e alla configurazione dei broker supportati.
Adobe Commerce — RabbitMQ
Documentazione ufficiale relativa all'utilizzo e alla configurazione di RabbitMQ con Adobe Commerce.
AWS Prescriptive Guidance — Transactional Outbox Pattern
Descrizione del pattern, del dual write problem, delle strategie di implementazione e della necessità di gestire messaggi duplicati e consumer idempotenti.
Microservices.io — Transactional Outbox
Descrizione originale e approfondita del Transactional Outbox Pattern, dei partecipanti all'architettura e del Message Relay.
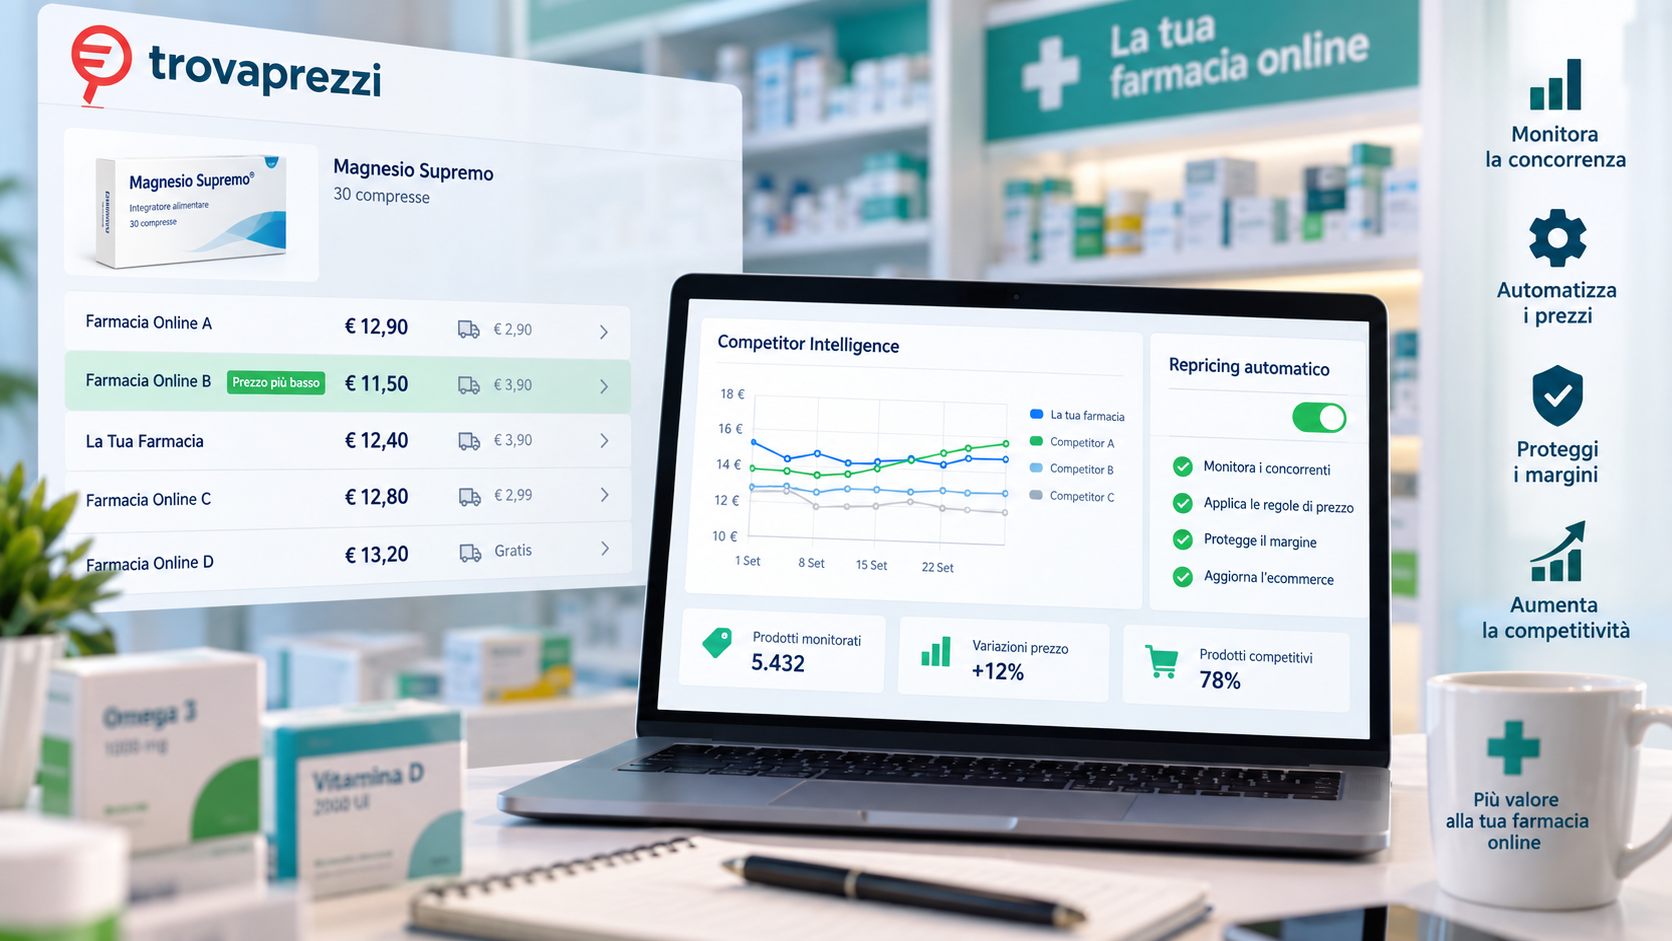
Trovaprezzi e farmacie online: come monitorare la concorrenza e automatizzare i prezzi
Per una farmacia online, il prezzo è uno degli elementi che influenzano maggiormente la competitività di un prodotto. Il problema è che il mercato cambia continuamente: concorrenti che modificano i prezzi, promozioni temporanee, prodotti che entrano o escono dallo stock e variazioni delle condizioni di spedizione possono modificare rapidamente la convenienza percepita di un'offerta.
Questo fenomeno diventa particolarmente evidente sui comparatori di prezzo come Trovaprezzi, dove il consumatore può confrontare rapidamente più offerte dello stesso prodotto.
Per una farmacia con migliaia o decine di migliaia di referenze, controllare manualmente i prezzi dei concorrenti è praticamente impossibile.
La soluzione è passare dal semplice controllo dei prezzi a un sistema di competitor intelligence e repricing automatico, capace di raccogliere i prezzi della concorrenza, confrontarli con i propri costi e applicare regole commerciali definite dalla farmacia.
In questo articolo vediamo come farlo e perché il monitoraggio dei prezzi può diventare uno strumento strategico per aumentare la competitività di una farmacia online senza sacrificare la marginalità.
Perché Trovaprezzi è importante per una farmacia online
Trovaprezzi è un comparatore che permette agli utenti di confrontare offerte provenienti da diversi ecommerce. Anche nel settore salute e farmacia sono presenti numerose offerte e operatori specializzati.
Per il consumatore il vantaggio è evidente: può confrontare rapidamente prezzo del prodotto, costi di spedizione e condizioni dell'offerta.
Per la farmacia online questo significa operare in un mercato caratterizzato da una forte trasparenza dei prezzi.
Un prodotto venduto a 18,90 € potrebbe trovarsi accanto allo stesso articolo proposto da altri ecommerce a 16,50 €, 17,20 € o 19,90 €.
Ma abbassare automaticamente il prezzo per essere sempre i più economici non è necessariamente una buona strategia.
Il vero obiettivo dovrebbe essere:
essere competitivi quando serve, proteggendo contemporaneamente il margine della farmacia.
Per raggiungerlo servono dati e automazione.
Il problema del monitoraggio manuale dei prezzi
Immaginiamo una farmacia online con 30.000 prodotti a catalogo.
Anche ipotizzando di voler controllare soltanto 5.000 prodotti strategici e cinque concorrenti per ciascun prodotto, avremmo potenzialmente 25.000 confronti di prezzo da effettuare.
E il risultato sarebbe comunque una fotografia temporanea del mercato.
Dopo poche ore alcuni prezzi potrebbero essere già cambiati.
Un controllo manuale basato su fogli Excel diventa quindi rapidamente:
- costoso;
- lento;
- difficile da mantenere;
- soggetto a errori;
- impossibile da aggiornare con frequenza elevata.
Per questo motivo è utile introdurre un sistema automatico di monitoraggio prezzi dei competitor.
Cos'è la competitor intelligence per una farmacia online
La competitor intelligence applicata all'ecommerce consiste nel raccogliere e analizzare sistematicamente informazioni sul mercato e sui concorrenti.
Nel caso di una farmacia online, alcuni dei dati più interessanti sono:
- prezzo del prodotto;
- disponibilità;
- prezzo promozionale;
- eventuale prezzo precedente;
- costo della spedizione;
- soglia per la spedizione gratuita;
- posizione dell'offerta rispetto ai concorrenti;
- numero di competitor presenti sul prodotto;
- variazioni di prezzo nel tempo.
Il dato interessante non è quindi soltanto:
“Quanto costa questo prodotto sul sito concorrente?”
La domanda più utile diventa:
“Come è posizionato il mio prezzo rispetto al mercato e quanto posso modificarlo senza compromettere il margine?”
Questa differenza è fondamentale.
Monitorare i prezzi delle farmacie online automaticamente
Un sistema di price monitoring può raccogliere periodicamente i prezzi pubblicamente disponibili dei prodotti presenti sui siti concorrenti o su altre fonti compatibili con il processo.
Il primo problema tecnico da risolvere è identificare correttamente lo stesso prodotto sui diversi ecommerce.
Nel settore farmaceutico questo processo può essere facilitato dalla presenza di identificativi e informazioni strutturate come:
- codice prodotto;
- EAN/GTIN;
- codice MINSAN quando applicabile;
- produttore;
- nome commerciale;
- formato;
- quantità.
Una volta effettuato il matching, il sistema può costruire per ogni prodotto una situazione simile alla seguente:
| Farmacia | Prezzo |
|---|---|
| Competitor A | 16,90 € |
| Competitor B | 17,40 € |
| Nostra farmacia | 17,90 € |
| Competitor C | 18,20 € |
| Competitor D | 19,50 € |
A questo punto sappiamo che la nostra farmacia non è la più economica, ma si trova comunque in una fascia competitiva.
Ed è qui che entra in gioco il repricing.
Dal monitoraggio al repricing automatico
Monitorare i concorrenti è utile.
Utilizzare automaticamente queste informazioni per prendere decisioni sui prezzi è molto più potente.
Un sistema di repricing automatico per farmacie online può applicare regole commerciali definite dall'azienda.
Per esempio:
Se il nostro prezzo è superiore del 5% rispetto alla media dei primi tre concorrenti, riduci il prezzo mantenendo almeno il 20% di margine.
Oppure:
Posizionati 0,10 € sotto il competitor selezionato, ma non scendere mai sotto il prezzo minimo definito.
Il prezzo finale non dipende quindi esclusivamente dal concorrente.
Può essere calcolato utilizzando contemporaneamente:
prezzo concorrenti + costo di acquisto + margine minimo + stock + strategia commerciale.
Perché non bisogna semplicemente essere i più economici
Uno degli errori più comuni nel repricing è pensare:
“Devo essere sempre il primo prezzo.”
Una strategia del genere può generare una vera e propria corsa al ribasso.
Supponiamo che un prodotto abbia:
- costo di acquisto: 10 €;
- prezzo attuale: 15 €;
- miglior concorrente: 14,50 €.
Un algoritmo troppo semplice potrebbe portare il prezzo a 14,40 €.
Se un concorrente reagisse portandolo a 14,30 €, il sistema potrebbe scendere a 14,20 €.
Continuando in questo modo, il margine potrebbe progressivamente ridursi.
Un sistema evoluto deve invece prevedere dei guardrail di marginalità.
Per esempio:
Prezzo minimo = costo prodotto + costi variabili + margine minimo desiderato
Se il prezzo competitivo calcolato dal sistema è inferiore a questa soglia, il repricing non viene applicato.
Esempio di regola di repricing
Consideriamo un prodotto con questi valori:
| Parametro | Valore |
|---|---|
| Costo acquisto | 12,00 € |
| Prezzo attuale | 18,90 € |
| Miglior competitor | 17,40 € |
| Secondo competitor | 17,90 € |
| Margine minimo impostato | 20% |
Una possibile regola potrebbe essere:
Target = secondo miglior prezzo - 0,10 €
Il prezzo candidato diventerebbe quindi:
17,90 € - 0,10 € = 17,80 €
Prima di pubblicarlo, il sistema verifica però che il prezzo rispetti il margine minimo configurato.
Se il controllo viene superato, il nuovo prezzo può essere inviato all'ecommerce.
In caso contrario il prezzo rimane invariato oppure viene impostato al minimo consentito dalla strategia commerciale.
Non tutti i prodotti devono avere la stessa strategia
Questo è uno degli aspetti più importanti del dynamic pricing per farmacie online.
Non ha senso applicare la stessa regola a tutto il catalogo.
I prodotti possono essere classificati in gruppi differenti.
Prodotti ad alta competitività
Sono articoli molto conosciuti e facilmente confrontabili.
Su questi prodotti può essere importante mantenere un prezzo molto vicino ai principali concorrenti.
Prodotti ad alta marginalità
Qui può essere preferibile proteggere il margine invece di inseguire continuamente il prezzo più basso.
Prodotti con stock elevato
Se esiste un eccesso di magazzino, il sistema può adottare una strategia più aggressiva per aumentare la rotazione.
Prodotti con stock ridotto
Se rimangono poche unità disponibili, potrebbe non essere necessario ridurre il prezzo.
Prodotti civetta
Alcuni prodotti particolarmente conosciuti possono essere utilizzati per aumentare la competitività percepita dell'intero ecommerce.
La marginalità può quindi essere valutata a livello di carrello e non esclusivamente sul singolo articolo.
Trovaprezzi come fonte di informazioni competitive
La presenza sui comparatori rende immediatamente visibile il posizionamento di un ecommerce rispetto agli altri operatori.
Questo rende Trovaprezzi interessante non soltanto come canale di acquisizione, ma anche come elemento della strategia di pricing.
Analizzando il mercato è possibile individuare:
- prodotti sui quali siamo fuori mercato;
- prodotti sui quali siamo già competitivi;
- prodotti sui quali possiamo aumentare il prezzo;
- competitor particolarmente aggressivi;
- categorie caratterizzate da forte pressione sui prezzi.
Il risultato è una strategia di prezzo molto più razionale rispetto all'applicazione indiscriminata di sconti.
Prezzo prodotto o costo totale?
C'è inoltre un elemento spesso sottovalutato.
Il consumatore non valuta necessariamente soltanto il prezzo del singolo prodotto.
Consideriamo due farmacie:
| Farmacia A | Farmacia B | |
|---|---|---|
| Prodotto | 14,90 € | 15,50 € |
| Spedizione | 6,90 € | 3,90 € |
| Totale | 21,80 € | 19,40 € |
La Farmacia A ha il prezzo prodotto più basso, ma l'offerta complessiva è più costosa.
Quando i dati disponibili lo consentono, una strategia di competitor intelligence dovrebbe quindi considerare anche elementi come costi di spedizione e soglie di spedizione gratuita.
Automatizzare Trovaprezzi e l'ecommerce
Il monitoraggio dei competitor diventa ancora più interessante quando viene integrato con il resto dell'infrastruttura ecommerce.
Un'architettura tipica può essere:
Gestionale farmacia
        ↓
     Galenis
        ↓
Catalogo / costi / disponibilità
        ↓
Competitor Intelligence
        ↓
Pricing Engine
        ↓
Magento / WooCommerce
        ↓
Feed Trovaprezzi
Il gestionale rimane la fonte delle informazioni operative.
Il middleware raccoglie costi, disponibilità e dati di catalogo.
Il sistema di competitor intelligence raccoglie i prezzi di mercato.
Il pricing engine applica le regole commerciali.
Infine il nuovo prezzo viene pubblicato sull'ecommerce e propagato ai canali collegati.
Perché centralizzare il processo
Uno dei problemi più frequenti negli ecommerce complessi è la frammentazione.
Il prezzo può essere gestito nel gestionale, modificato nell'ecommerce, esportato verso Trovaprezzi e successivamente utilizzato anche per Google Merchant, marketplace o altri feed.
Il rischio è creare logiche differenti per ogni canale.
Una soluzione più robusta consiste nel centralizzare le regole.
In questo modo è possibile definire:
Costo prodotto
      ↓
Regole commerciali
      ↓
Analisi competitor
      ↓
Prezzo ecommerce
      ↓
Feed e marketplace
Il vantaggio principale non è soltanto tecnico.
La farmacia ottiene una governance centralizzata del pricing.
Repricing: automatico o supervisionato?
L'automazione non significa necessariamente lasciare completa libertà all'algoritmo.
Esistono almeno tre livelli possibili.
1. Monitoraggio
Il sistema raccoglie i prezzi e mostra eventuali anomalie.
La decisione rimane completamente manuale.
2. Repricing assistito
Il sistema propone:
Prezzo attuale: 19,90 €
Prezzo consigliato: 18,70 €
Un operatore approva o rifiuta la modifica.
3. Repricing automatico
Le modifiche che rispettano determinate regole vengono pubblicate automaticamente.
Per esempio:
variazione < 5%
AND
margine > 20%
AND
stock > 5
→ modifica automatica
Le situazioni anomale possono invece richiedere approvazione manuale.
Per molte farmacie quest'ultimo modello ibrido rappresenta un buon compromesso tra automazione e controllo.
Alert sui prezzi dei concorrenti
Non tutte le variazioni devono necessariamente produrre un cambio di prezzo.
Il sistema può anche generare alert.
Per esempio:
- competitor sceso oltre il 10%;
- nostro prezzo superiore del 15% alla mediana;
- margine sotto la soglia;
- prodotto precedentemente competitivo diventato fuori mercato;
- nuovo competitor individuato;
- variazione anomala del prezzo;
- improvvisa riduzione del numero di competitor disponibili.
Queste informazioni possono essere visualizzate attraverso una dashboard oppure inviate agli operatori responsabili dell'ecommerce.
Storico dei prezzi: capire il mercato nel tempo
Un sistema di monitoraggio diventa particolarmente interessante quando conserva lo storico dei prezzi dei competitor.
Non vediamo più soltanto:
Competitor A = 17,90 €
ma possiamo osservare:
1 settembre → 19,90 €
5 settembre → 18,90 €
10 settembre → 17,90 €
15 settembre → 17,90 €
Questo permette di distinguere una promozione occasionale da una modifica strutturale del prezzo.
Lo storico consente inoltre di analizzare:
- frequenza delle variazioni;
- stagionalità;
- aggressività dei competitor;
- durata delle promozioni;
- evoluzione della fascia di prezzo;
- relazione tra prezzo e performance commerciale.
Quali KPI monitorare
Per valutare l'efficacia della strategia è utile costruire una dashboard con alcuni indicatori.
Tra i più interessanti:
| KPI | Significato |
|---|---|
| Price Index | Rapporto tra nostro prezzo e prezzo di mercato |
| Competitive Products | % prodotti con prezzo competitivo |
| Cheapest Products | % prodotti nei quali siamo il prezzo più basso |
| Average Margin | Marginalità media |
| Price Changes | Numero di variazioni effettuate |
| Competitor Coverage | Prodotti per cui disponiamo di dati competitivi |
| Out-of-market Products | Prodotti significativamente sopra il mercato |
| Margin Protected | Modifiche bloccate per proteggere il margine |
L'obiettivo non dovrebbe essere massimizzare il numero di prodotti con il prezzo più basso.
Un KPI più significativo è trovare il miglior equilibrio tra competitività, conversione e marginalità.
Dal prezzo alla strategia commerciale
La vera evoluzione avviene quando il monitoraggio dei prezzi smette di essere un'attività operativa e diventa uno strumento decisionale.
Una farmacia può scoprire, per esempio, che:
- su alcuni brand è sistematicamente più costosa della concorrenza;
- su altri prodotti potrebbe aumentare il prezzo senza perdere competitività;
- alcuni competitor sono aggressivi soltanto su determinate categorie;
- alcune promozioni dei concorrenti durano pochi giorni;
- determinati articoli hanno una pressione competitiva molto superiore ad altri.
Queste informazioni possono influenzare anche acquisti, promozioni e negoziazioni con i fornitori.
La competitor intelligence diventa quindi utile non soltanto per decidere a quanto vendere, ma anche cosa acquistare e quali prodotti promuovere.
Galenis: monitoraggio competitor e automazione del pricing
Galenis nasce per collegare i diversi sistemi utilizzati da una farmacia online senza sostituire necessariamente il gestionale esistente.
All'interno di questo modello è possibile centralizzare processi come:
- catalogo;
- ordini;
- acquisti dai fornitori;
- promozioni;
- feed prodotto;
- marketplace;
- monitoraggio competitor;
- pricing e repricing.
L'obiettivo è trasformare informazioni distribuite tra gestionale, ecommerce, fornitori e canali esterni in processi automatizzati.
Nel caso del pricing, il flusso può diventare:
Costo dal gestionale
        +
Prezzi competitor
        +
Regole commerciali
        +
Margine minimo
        ↓
Prezzo consigliato
        ↓
Controllo / approvazione
        ↓
Ecommerce
        ↓
Trovaprezzi e altri canali
In questo modo il prezzo non viene più gestito come un dato isolato, ma come il risultato di una strategia automatizzata basata su dati reali.
Conclusioni
Per una farmacia online con migliaia di prodotti, controllare manualmente i prezzi della concorrenza non è più una strategia sostenibile.
Trovaprezzi e gli altri canali di comparazione rendono il mercato estremamente trasparente e permettono ai consumatori di confrontare rapidamente diverse offerte.
La risposta non dovrebbe però essere una corsa indiscriminata al prezzo più basso.
La strategia più efficace consiste nel combinare:
monitoraggio competitor + costi di acquisto + marginalità + stock + regole commerciali + automazione.
Il risultato è un sistema di pricing capace di reagire al mercato mantenendo sotto controllo la redditività.
Ed è proprio qui che strumenti di competitor intelligence e piattaforme di integrazione come Galenis possono trasformare un'attività manuale e ripetitiva in un processo automatico, misurabile e governabile.
FAQ
Come monitorare i prezzi delle farmacie online concorrenti?
È possibile utilizzare sistemi di competitor intelligence che raccolgono periodicamente i prezzi pubblicamente disponibili e associano i prodotti tramite identificativi come EAN/GTIN, codici prodotto e altre informazioni di catalogo. I dati possono poi essere confrontati automaticamente con i prezzi del proprio ecommerce.
Cos'è il repricing automatico?
Il repricing automatico è un processo attraverso il quale il prezzo di un prodotto viene modificato sulla base di regole predefinite. Le regole possono considerare prezzi dei competitor, costo di acquisto, marginalità minima, disponibilità e strategia commerciale.
È necessario avere sempre il prezzo più basso su Trovaprezzi?
No. Essere sempre il venditore più economico può ridurre eccessivamente i margini. Una strategia più sostenibile consiste nel definire una fascia competitiva e un prezzo minimo sotto il quale il sistema non può scendere.
Come evitare che il repricing riduca troppo i margini?
È possibile configurare un prezzo minimo o una marginalità minima. Prima di applicare qualsiasi modifica, il pricing engine verifica che il nuovo prezzo rispetti questi limiti.
Il sistema può modificare automaticamente i prezzi su Magento?
Sì. Un sistema esterno di pricing può integrarsi con Magento o Adobe Commerce tramite API o integrazioni dedicate, aggiornando i prezzi secondo le regole definite dall'azienda.
Il repricing può essere utilizzato anche con WooCommerce?
Sì. La stessa logica può essere applicata a WooCommerce. L'elemento importante è separare il motore decisionale dal singolo ecommerce, in modo da centralizzare le regole di pricing.
È possibile monitorare solo alcuni concorrenti?
Sì. In molti casi è preferibile identificare un gruppo di competitor realmente significativi invece di attribuire lo stesso peso a tutti gli operatori presenti sul mercato.
Ogni quanto devono essere aggiornati i prezzi dei competitor?
Dipende dal catalogo e dalla volatilità del mercato. I prodotti più competitivi possono richiedere controlli più frequenti, mentre quelli meno sensibili al prezzo possono essere aggiornati con intervalli maggiori.
Galenis può integrare monitoraggio competitor e repricing?
Galenis può essere utilizzato come livello di integrazione tra gestionale, ecommerce e servizi dedicati alla competitor intelligence, permettendo di applicare regole di pricing e automatizzare la propagazione dei prezzi verso i diversi canali.
Fonti
- Trovaprezzi.it — sezione Farmacia / Prodotti Salute
Fonte primaria per verificare la presenza e il confronto delle offerte di farmacie online sul comparatore. - Google Search Central — Creating Helpful, Reliable, People-First Content
Linee guida Google sulla creazione di contenuti utili, completi e basati su competenza ed esperienza. - Google Search Central — SEO Starter Guide / Search Essentials
Best practice relative a titoli, contenuti, parole utilizzate dagli utenti, link e indicizzazione. - Google Search Central — Meta descriptions e snippets
Indicazioni ufficiali per creare descrizioni specifiche e pertinenti per le singole pagine. - Google Search Central — Structured Data
Documentazione sull'utilizzo dei dati strutturati per aiutare Google a comprendere il contenuto delle pagine.
Magento 2.4.9: tutte le novità e cosa cambia per gli ecommerce
Magento 2.4.9 rappresenta un aggiornamento importante nell'evoluzione della piattaforma Magento Open Source e Adobe Commerce.
Non si tratta semplicemente di una release contenente correzioni e aggiornamenti di sicurezza: Adobe ha proseguito il processo di modernizzazione dello stack tecnologico, aggiornando dipendenze fondamentali e intervenendo su API, GraphQL, sicurezza, caching, checkout e compatibilità con le versioni più recenti di PHP.
Tra le novità più interessanti troviamo:
- supporto ufficiale a PHP 8.5;
- adozione di Symfony 7.4 LTS;
- evoluzione dell'architettura MVC;
- sostituzione progressiva di componenti legacy;
- miglioramenti REST e GraphQL;
- miglioramenti a sicurezza e reCAPTCHA;
- aggiornamenti delle librerie frontend;
- ottimizzazioni delle performance;
- numerose correzioni al core.
Per merchant e aziende che utilizzano Magento, però, la domanda principale è un'altra:
cosa cambia realmente per un ecommerce esistente?
Vediamolo nel dettaglio.
PHP 8.5: Magento continua a modernizzare lo stack
Una delle novità tecnicamente più importanti di Magento 2.4.9 è il supporto ufficiale a PHP 8.5.
Magento negli ultimi anni ha accelerato il processo di aggiornamento dello stack PHP, eliminando progressivamente dipendenze obsolete e rendendo il core compatibile con versioni più moderne dell'ecosistema.
Il passaggio è particolarmente importante per chi mantiene moduli custom.
Un upgrade a Magento 2.4.9 dovrebbe quindi prevedere test specifici su:
- moduli proprietari;
- moduli di terze parti;
- plugin e preference;
- observer;
- integrazioni API;
- cron;
- consumer;
- script custom;
- override di classi appartenenti a librerie esterne.
Il fatto che Magento supporti PHP 8.5 non significa automaticamente che tutte le estensioni installate siano compatibili con PHP 8.5.
Ed è proprio il codice custom che dovrebbe ricevere maggiore attenzione durante un upgrade.
Symfony 7.4 LTS
Magento 2.4.9 introduce il supporto ufficiale a Symfony 7.4 LTS.
Le dipendenze Symfony utilizzate dalla piattaforma sono state aggiornate alla nuova linea LTS.
Questo intervento ha richiesto anche l'adeguamento delle classi Magento che estendono componenti Symfony, in particolare per quanto riguarda:
- type declarations;
- firme dei metodi;
- compatibilità delle classi derivate;
- dependency constraints.
Per gli ecommerce con personalizzazioni importanti è quindi consigliabile verificare se il codice custom utilizza direttamente componenti Symfony o estende classi appartenenti al framework.
Magento riduce ulteriormente le dipendenze legacy
Uno degli aspetti più interessanti di Magento 2.4.9 è il lavoro di modernizzazione delle fondamenta della piattaforma.
Adobe sta progressivamente eliminando componenti legacy e dipendenze che negli anni sono diventate difficili da mantenere.
Un esempio significativo riguarda il caching.
Da Zend_Cache a Symfony Cache
In Adobe Commerce 2.4.9 il componente legacy Zend_Cache viene sostituito dal componente Symfony Cache.
Per le installazioni standard l'impatto dovrebbe essere limitato: i backend di cache esistenti e i normali comandi di gestione della cache continuano a essere supportati.
Il punto da verificare riguarda soprattutto il codice custom che utilizza direttamente implementazioni o classi legacy.
Un audit preventivo del codice può individuare queste dipendenze prima dell'upgrade.
Evoluzione dell'architettura MVC
Un altro cambiamento architetturale importante riguarda il progressivo superamento di componenti Laminas.
Adobe Commerce 2.4.9 introduce una propria implementazione MVC nativa in sostituzione del precedente utilizzo di Laminas MVC.
È un cambiamento che probabilmente risulterà quasi invisibile al merchant, ma è molto significativo dal punto di vista architetturale.
La direzione è chiara:
ridurre le dipendenze legacy e preparare Magento alle future versioni di PHP e dell'ecosistema PHP moderno.
Per sviluppatori e system integrator questo significa prestare maggiore attenzione alle personalizzazioni che interagiscono direttamente con componenti framework.
GraphQL continua a diventare centrale
Magento 2.4.9 introduce diversi miglioramenti alle API GraphQL.
È particolarmente importante per:
- frontend headless;
- PWA;
- applicazioni mobile;
- frontend Hyvä che utilizzano GraphQL;
- integrazioni esterne.
Una novità interessante per Magento Open Source è la disponibilità della mutation:
clearCart
che permette di svuotare completamente il carrello tramite GraphQL.
In precedenza questa funzionalità non era disponibile nello stesso modo in Magento Open Source.
Nuova clearWishlist
È stata inoltre introdotta la possibilità di svuotare completamente una wishlist tramite GraphQL.
Questo semplifica le operazioni bulk sulle wishlist e riduce la necessità di implementare logiche client che eliminano gli elementi uno alla volta.
Migliore gestione del merge del carrello
Un'altra novità interessante riguarda il comportamento del carrello quando un cliente guest effettua il login.
Magento 2.4.9 introduce una configurazione che permette di controllare meglio la logica di merge tra guest cart e customer cart.
È un dettaglio apparentemente piccolo, ma può avere conseguenze significative sulla customer experience.
Nei progetti ecommerce complessi il comportamento del carrello durante login, registrazione e checkout è spesso oggetto di personalizzazioni.
Prima di effettuare l'upgrade è quindi opportuno verificare eventuali plugin o override presenti su queste logiche.
Maggiore protezione delle API con reCAPTCHA
Magento 2.4.9 estende l'utilizzo di CAPTCHA/reCAPTCHA anche a operazioni REST e GraphQL.
In particolare vengono rafforzate alcune operazioni relative alla gestione dell'account cliente e dei form esposti attraverso API.
Questo è importante soprattutto per ecommerce headless.
In passato una protezione applicata al form tradizionale del frontend poteva non essere equivalente alla protezione dello stesso processo esposto attraverso API.
Magento 2.4.9 riduce questa differenza.
Per chi utilizza frontend headless sarà quindi importante verificare attentamente i flussi di:
- registrazione;
- aggiornamento account;
- form contatti;
- autenticazione;
- checkout.
Miglioramenti alle REST API
Anche le REST API ricevono diverse correzioni.
Una modifica interessante riguarda la gestione della media gallery dei prodotti a livello di store view.
Magento permette di gestire cataloghi multi-store nei quali determinati attributi possono ereditare i valori dal livello globale.
Con Magento 2.4.9 viene migliorata la gestione dell'ereditarietà di immagini e video quando un prodotto viene aggiornato tramite REST API.
È particolarmente importante per ecommerce che sincronizzano il catalogo attraverso:
- ERP;
- PIM;
- middleware;
- software gestionali;
- sistemi DAM;
- importatori custom.
Chi dispone di integrazioni catalogo dovrebbe includere questo comportamento nei test di regressione.
Miglioramenti per gli ordini storici
Magento 2.4.9 migliora anche il recupero degli ordini storici quando i prodotti associati non sono più disponibili.
I dettagli dei prodotti possono continuare a essere restituiti anche quando l'articolo risulta attualmente out of stock.
È una modifica utile soprattutto per frontend headless e applicazioni che utilizzano GraphQL per mostrare lo storico ordini del cliente.
Novità sui pagamenti
Anche Braintree riceve diversi aggiornamenti.
Tra gli interventi presenti nella release troviamo aggiornamenti relativi a:
- compatibilità PHP 8.5;
- Google Pay;
- gestione del vault;
- metodi di pagamento;
- correzioni sui refund.
Adobe continua quindi ad aggiornare l'integrazione dei sistemi di pagamento insieme al core Magento.
Per gli ecommerce con checkout personalizzati è consigliabile effettuare una regressione completa almeno su:
ordine
→ autorizzazione
→ capture
→ invoice
→ credit memo
→ refund
→ cancellazione
e sui principali metodi di pagamento effettivamente utilizzati dal negozio.
HugeRTE sostituisce TinyMCE
Un cambiamento visibile anche agli amministratori riguarda l'editor WYSIWYG.
Adobe Commerce migra da TinyMCE a HugeRTE.
La scelta è collegata sia al ciclo di supporto delle precedenti versioni TinyMCE sia alle condizioni di licensing delle versioni più recenti.
Per chi utilizza editor custom, plugin TinyMCE o personalizzazioni dell'Admin è quindi necessario verificare la compatibilità.
Aggiornamento delle librerie frontend
Magento 2.4.9 aggiorna diverse dipendenze JavaScript utilizzate dalla piattaforma.
Tra queste troviamo:
- Less.js;
- jQuery UI;
- jQuery Validate;
- Uppy;
- Underscore.js;
- Moment Timezone;
- Chart.js.
Per un ecommerce standard questi aggiornamenti dovrebbero essere sostanzialmente trasparenti.
Su progetti con temi fortemente personalizzati, invece, è opportuno verificare:
- JavaScript custom;
- RequireJS mixin;
- widget jQuery;
- componenti Admin custom;
- uploader personalizzati;
- compilazione LESS;
- checkout personalizzati.
Performance: miglioramenti alla Media Gallery
Magento 2.4.9 interviene anche sulle performance della Media Gallery.
In particolare viene ottimizzato il caricamento dell'albero delle directory.
In presenza di strutture con molti file e directory, Magento evita di costruire immediatamente l'intero albero e utilizza un caricamento progressivo dei nodi.
Per installazioni con cataloghi e librerie media molto grandi può significare un Admin più reattivo durante la gestione delle immagini.
Miglioramenti alla Subresource Integrity
Magento continua inoltre il lavoro sulla Subresource Integrity (SRI).
In Magento 2.4.9 gli hash SRI vengono organizzati in file separati in funzione di:
- area;
- tema;
- locale.
Invece di gestire un unico grande file, Magento può quindi caricare le informazioni rilevanti per il contesto corrente.
Il risultato è una gestione più efficiente, soprattutto per installazioni con numerosi temi e store view.
Oltre 500 correzioni nel core
Magento Open Source 2.4.9 include 580 correzioni nel core.
Gli interventi interessano numerose aree della piattaforma:
- API;
- catalogo;
- checkout;
- customer;
- GraphQL;
- Admin;
- import/export;
- pagamenti;
- tasse;
- analytics;
- wishlist;
- ordini;
- resi;
- performance.
Questo rende particolarmente importante eseguire un aggiornamento attraverso un processo strutturato di test.
Magento 2.4.9: conviene aggiornare subito?
Dipende dalla situazione del progetto.
Per un ecommerce in produzione non consigliamo di trattare un upgrade Magento come un semplice:
composer update
Il processo dovrebbe invece essere:
Analisi compatibilità
        ↓
Aggiornamento ambiente DEV
        ↓
Static analysis
        ↓
Upgrade moduli
        ↓
Test automatici
        ↓
Test integrazioni
        ↓
Test checkout
        ↓
Performance test
        ↓
Staging
        ↓
Regression test
        ↓
Produzione
Più il progetto è personalizzato, maggiore deve essere l'attenzione.
Cosa controllare prima dell'upgrade
Prima di pianificare il passaggio a Magento 2.4.9 consigliamo almeno di verificare:
1. Compatibilità PHP
Controllare moduli custom ed estensioni di terze parti rispetto alle versioni PHP previste dall'infrastruttura.
2. Composer dependencies
Verificare eventuali conflitti con le nuove dipendenze introdotte dalla piattaforma.
3. Moduli custom
Individuare codice che utilizza direttamente classi Symfony, Laminas, Zend o altre librerie aggiornate.
4. Tema
Eseguire una regressione completa del frontend, soprattutto in presenza di Luma/Blank fortemente personalizzati.
5. Hyvä
Verificare la versione del tema e la compatibilità delle estensioni Hyvä utilizzate dal progetto.
6. Checkout
Testare l'intero processo di acquisto, compresi tutti i metodi di pagamento e spedizione.
7. API
Eseguire regression test sulle integrazioni REST e GraphQL.
8. ERP e gestionali
Verificare import prodotti, sincronizzazione stock, prezzi, clienti, ordini e spedizioni.
9. Cron e queue
Controllare cron job, consumer e processi asincroni custom.
10. Test automatici
Dove possibile, utilizzare test E2E per verificare automaticamente i principali customer journey.
Un upgrade Magento è soprattutto un progetto di compatibilità
Magento 2.4.9 conferma la direzione intrapresa da Adobe negli ultimi anni.
La piattaforma sta progressivamente modernizzando le proprie fondamenta:
PHP moderno
     +
Symfony
     +
meno componenti legacy
     +
API / GraphQL
     +
sicurezza
     +
automazione
Dal punto di vista tecnico è un'evoluzione positiva.
Ma significa anche che mantenere per anni codice custom senza aggiornarlo diventa progressivamente più rischioso.
Per questo un upgrade Magento non dovrebbe limitarsi all'aggiornamento della piattaforma.
È anche un'ottima occasione per effettuare una revisione tecnica del progetto, eliminare codice obsoleto, aggiornare le integrazioni e aumentare la copertura dei test.
Devi aggiornare il tuo ecommerce a Magento 2.4.9?
In Devlogica lavoriamo su progetti Magento Open Source e Adobe Commerce occupandoci di sviluppo, manutenzione, integrazioni e upgrade.
Possiamo effettuare un'analisi preventiva del progetto per verificare:
- compatibilità dei moduli custom;
- dipendenze Composer;
- compatibilità PHP;
- moduli di terze parti;
- integrazioni ERP e API;
- checkout e pagamenti;
- performance;
- test automatici.
L'obiettivo è individuare prima dell'upgrade i punti che potrebbero generare problemi in produzione.
Un aggiornamento Magento ben pianificato non dovrebbe essere un salto nel buio: dovrebbe essere un processo ripetibile, testabile e verificabile.
Contattaci per discutere del tuo progetto di migrazione a Magento 2.4.9
FAQ su Magento 2.4.9
Magento 2.4.9 supporta PHP 8.5?
Sì. Magento Open Source 2.4.9 introduce il supporto ufficiale a PHP 8.5 e aggiorna anche le dipendenze Symfony alla versione 7.4 LTS.
Questo non significa però che tutti i moduli di terze parti e il codice custom siano automaticamente compatibili con PHP 8.5.
Prima dell'upgrade è quindi consigliabile effettuare un controllo specifico su:
- moduli custom;
- estensioni installate;
- dipendenze Composer;
- plugin e preference;
- cron job e consumer;
- integrazioni esterne.
Magento 2.4.9 utilizza Symfony 7.4?
Sì. Magento 2.4.9 aggiorna i componenti Symfony utilizzati dalla piattaforma alla linea Symfony 7.4 LTS. Adobe ha inoltre aggiornato firme dei metodi e type declaration delle classi Magento che estendono componenti Symfony.
Symfony 7.4 è una release LTS mantenuta con bug fix fino a novembre 2028 e aggiornamenti di sicurezza fino a novembre 2029.
È obbligatorio utilizzare PHP 8.5 con Magento 2.4.9?
Il supporto a PHP 8.5 è una delle principali novità della release, ma la scelta della versione PHP da utilizzare deve essere valutata insieme alla matrice di compatibilità ufficiale e alle dipendenze effettivamente presenti nel progetto.
Prima di modificare la versione PHP di produzione è sempre opportuno verificare:
Magento Core
     ↓
Moduli custom
     ↓
Estensioni di terze parti
     ↓
Composer dependencies
     ↓
Test automatici
     ↓
Staging
In particolare, il problema più frequente non è il core Magento, ma il codice custom sviluppato negli anni.
Magento 2.4.9 introduce novità GraphQL?
Sì.
Tra le novità troviamo la disponibilità della mutation:
clearCart
anche per Magento Open Source, oltre alla nuova operazione:
clearWishlist
Sono stati inoltre migliorati il merge tra guest cart e customer cart e il recupero degli ordini storici contenenti prodotti non più disponibili.
Questo è particolarmente importante per ecommerce:
- headless;
- PWA;
- mobile;
- con frontend custom;
- con integrazioni che utilizzano GraphQL.
Magento 2.4.9 migliora la sicurezza delle API?
Sì.
Magento 2.4.9 estende la validazione CAPTCHA/reCAPTCHA a ulteriori operazioni REST e GraphQL.
Ad esempio, quando CAPTCHA è abilitato per la creazione dell'account cliente, la validazione può essere applicata anche alla registrazione effettuata attraverso REST o GraphQL.
Sono state inoltre aggiunte protezioni reCAPTCHA a mutation GraphQL come:
updateCustomer
updateCustomerV2
contactUs
Per i progetti headless è quindi importante includere questi flussi nei test di regressione dopo l'aggiornamento.
Magento 2.4.9 contiene miglioramenti alle REST API?
Sì.
Una delle modifiche riguarda la gestione della media gallery dei prodotti a livello di store view.
Quando un prodotto viene aggiornato tramite REST API, Magento 2.4.9 permette di controllare meglio l'ereditarietà di immagini e video dal livello globale.
È un cambiamento particolarmente interessante per ecommerce che sincronizzano il catalogo attraverso:
- ERP;
- PIM;
- middleware;
- DAM;
- gestionali;
- importatori custom.
Magento 2.4.9 cambia qualcosa per Braintree?
Sì.
La release contiene diversi aggiornamenti relativi a Braintree, compresa la compatibilità con PHP 8.5 e miglioramenti relativi a Google Pay e vaulting.
Dopo l'upgrade consigliamo quindi di verificare almeno:
Creazione ordine
→ autorizzazione
→ capture
→ invoice
→ credit memo
→ refund
oltre naturalmente ai singoli metodi di pagamento utilizzati dal progetto.
Quanti bug corregge Magento 2.4.9?
Adobe dichiara 580 correzioni nel core di Magento Open Source 2.4.9.
Le correzioni interessano numerose aree della piattaforma, tra cui:
- catalogo;
- API;
- GraphQL;
- checkout;
- customer;
- import/export;
- ordini;
- pagamenti;
- tasse;
- wishlist;
- Admin.
Il numero elevato di modifiche è anche uno dei motivi per cui l'upgrade dovrebbe essere accompagnato da una regressione completa del progetto.
Posso aggiornare direttamente Magento in produzione?
Tecnicamente un aggiornamento Magento viene gestito tramite Composer e i normali strumenti della piattaforma, ma non è consigliabile effettuare l'upgrade direttamente sull'ambiente di produzione.
Un processo più sicuro è:
Analisi compatibilità
        ↓
Branch di upgrade
        ↓
Aggiornamento ambiente DEV
        ↓
Test automatici
        ↓
Analisi errori e deprecated
        ↓
Staging
        ↓
Regression test
        ↓
Deploy produzione
Più sono numerose le personalizzazioni, maggiore dovrebbe essere la copertura dei test.
I moduli Magento 2.4.8 funzionano automaticamente su Magento 2.4.9?
Non necessariamente.
Anche quando un modulo non genera immediatamente errori, potrebbe utilizzare:
- classi deprecate;
- vecchie firme dei metodi;
- componenti framework aggiornati;
- librerie JavaScript precedenti;
- dipendenze Composer incompatibili.
Per questo consigliamo di verificare esplicitamente la compatibilità dichiarata dal vendor e di testare comunque il modulo su staging.
Magento 2.4.9 è compatibile con Hyvä?
La compatibilità dipende dalla versione di Hyvä Themes, di Hyvä Checkout e dalle estensioni installate.
Il fatto che Magento 2.4.9 sia supportato dal core non implica automaticamente la compatibilità di tutte le personalizzazioni frontend.
Prima dell'upgrade è opportuno controllare:
- versione Hyvä;
- Compatibility Modules;
- checkout;
- moduli di terze parti;
- Alpine.js custom;
- GraphQL custom;
- eventuali override del tema.
Conviene passare subito a Magento 2.4.9?
Per ecommerce attivi la scelta dovrebbe dipendere principalmente da tre fattori:
- compatibilità dello stack;
- maturità delle estensioni utilizzate;
- possibilità di eseguire una regressione completa prima del deploy.
Per installazioni relativamente standard l'aggiornamento può essere più semplice.
Per progetti Magento molto personalizzati è invece consigliabile iniziare con un compatibility assessment e stimare il lavoro necessario prima di stabilire la data di rilascio.
Fonti e documentazione
Per approfondire Magento 2.4.9 consigliamo di utilizzare principalmente la documentazione ufficiale.
Adobe Commerce / Magento
- Magento Open Source 2.4.9 Release Notes
Release note ufficiale Adobe con novità, modifiche GraphQL, REST API, Braintree, PHP 8.5 e l'elenco delle principali correzioni. - Adobe Commerce 2.4.9 Release Notes
Utile per confrontare le novità della versione Commerce con quelle disponibili in Magento Open Source. - Magento Open Source 2.4.9 Packages
Elenco ufficiale delle dipendenze Composer incluse nella versione 2.4.9, particolarmente utile per analizzare incompatibilità e dipendenze durante un upgrade. - Magento Open Source Release Notes Overview
Pagina Adobe che raccoglie le release note della piattaforma e rimanda anche alla documentazione sulle backward incompatible changes.
PHP
- PHP 8.5 Release Announcement
Documentazione ufficiale PHP relativa alle novità introdotte in PHP 8.5, tra cui URI extension, pipe operator,clone withe#[NoDiscard].
Symfony
- Symfony 7.4 LTS
Pagina ufficiale della release Symfony 7.4, versione LTS utilizzata dal nuovo stack Magento 2.4.9.
Conclusione
Magento 2.4.9 è una release particolarmente interessante perché combina correzioni del core con un ulteriore ammodernamento dello stack tecnologico.
PHP 8.5, Symfony 7.4 LTS, GraphQL, API, sicurezza e riduzione delle dipendenze legacy indicano chiaramente la direzione futura della piattaforma.
Per i merchant il vantaggio è poter continuare a utilizzare una piattaforma tecnologicamente aggiornata.
Per chi sviluppa e mantiene Magento, invece, il messaggio è altrettanto chiaro:
mantenere aggiornato il codice custom è ormai importante quanto mantenere aggiornato Magento stesso.
Un progetto che dispone di test automatici, moduli ben isolati e integrazioni documentate sarà molto più semplice da portare sulle prossime versioni rispetto a un ecommerce che accumula personalizzazioni e dipendenze legacy per anni.
Repricing per farmacie online: come competere senza distruggere i margini
Nel mercato della farmacia online il prezzo è uno dei principali fattori competitivi.
Il cliente può confrontare in pochi secondi lo stesso prodotto su diversi ecommerce, marketplace e comparatori. Una differenza di pochi euro può determinare dove verrà concluso l'acquisto.
La risposta più immediata sembrerebbe quindi semplice:
abbassare il prezzo quando un concorrente vende a meno.
Ma una strategia di questo tipo può rapidamente trasformarsi in una guerra dei prezzi, con una conseguenza prevedibile: aumentano gli ordini, ma diminuisce la marginalità.
Il vero obiettivo di un sistema di repricing non dovrebbe essere semplicemente quello di avere il prezzo più basso.
Dovrebbe essere quello di trovare il miglior prezzo possibile compatibilmente con margini, disponibilità, concorrenza e strategia commerciale.
Cos'è il repricing
Il repricing è il processo attraverso il quale il prezzo di vendita di un prodotto viene aggiornato sulla base di determinate condizioni.
In un ecommerce farmaceutico queste condizioni possono riguardare, ad esempio:
- prezzo di acquisto;
- margine minimo desiderato;
- prezzo dei concorrenti;
- disponibilità a magazzino;
- quantità disponibile;
- rotazione del prodotto;
- data di scadenza;
- promozioni attive;
- categoria o brand;
- andamento storico delle vendite.
Il repricing può essere effettuato manualmente, ma quando il catalogo contiene migliaia o decine di migliaia di referenze diventa praticamente impossibile controllare continuamente prezzi, concorrenti e marginalità.
È qui che entra in gioco l'automazione.
Il problema del "prezzo più basso"
Immaginiamo un prodotto con questi valori:
| Voce | Valore |
|---|---|
| Costo di acquisto | € 12,00 |
| Prezzo attuale | € 18,90 |
| Concorrente A | € 17,90 |
| Concorrente B | € 16,90 |
| Concorrente C | € 15,50 |
Una strategia di repricing estremamente semplice potrebbe stabilire:
Prezzo = prezzo più basso del concorrente - € 0,10
Il nostro nuovo prezzo diventerebbe quindi € 15,40.
Tecnicamente saremmo diventati i più economici.
Commercialmente, però, potremmo aver commesso un errore.
Il prezzo potrebbe non essere sufficiente a coprire adeguatamente costo del prodotto, commissioni di pagamento, logistica, marketing, gestione dell'ordine e altri costi operativi.
Il problema quindi non è:
"Quanto costa questo prodotto dai concorrenti?"
ma:
"Qual è il prezzo minimo al quale posso vendere questo prodotto mantenendo una marginalità accettabile?"
Dal repricing alla Pricing Intelligence
Un sistema evoluto dovrebbe separare almeno tre concetti:
Costo → Margine minimo → Posizionamento competitivo
Supponiamo che un prodotto abbia:
- costo: € 10;
- margine minimo configurato: 20%;
- prezzo consigliato: € 16;
- miglior concorrente: € 14,50.
Una regola potrebbe stabilire:
Prezzo target = miglior concorrente - 0,10 €

MA

Prezzo finale >= prezzo minimo sostenibile
Il sistema potrebbe quindi decidere automaticamente di non seguire ulteriormente il concorrente quando questo comporterebbe una marginalità inferiore alla soglia stabilita.
È una differenza fondamentale.
Il software non deve semplicemente abbassare i prezzi.
Deve sapere quando smettere di abbassarli.
Pricing rules: non tutti i prodotti sono uguali
Una farmacia online può avere decine di migliaia di SKU.
Applicare la stessa politica commerciale a tutto il catalogo difficilmente produce risultati ottimali.
È molto più interessante costruire delle pricing rules.
Per esempio:
SE categoria = Integratori
E margine > 30%
E concorrenti disponibili >= 3

ALLORA

posizionati entro il 2% dal prezzo migliore
Oppure:
SE stock > 100
E vendite ultimi 30 giorni < 5

ALLORA

aumenta aggressività del repricing
Un'altra strategia potrebbe essere:
SE stock < 5

ALLORA

non effettuare repricing verso il basso
La disponibilità diventa quindi parte della strategia di prezzo.
Perché ridurre il prezzo di un prodotto che probabilmente venderemo comunque?
Marginalità minima per prodotto o categoria
Una delle funzionalità più importanti è la possibilità di impostare dei floor price, cioè prezzi sotto i quali il sistema non può scendere.
Il floor può essere determinato considerando:
Costo prodotto
+ costi logistici
+ commissioni
+ costi commerciali
+ margine minimo
La farmacia può inoltre impostare strategie differenti per categoria.
Ad esempio:
| Categoria | Margine minimo |
|---|---|
| Integratori | 25% |
| Dermocosmesi | 30% |
| OTC | 15% |
| Dispositivi medici | 20% |
I valori sono naturalmente configurabili in funzione della strategia commerciale della singola farmacia.
In questo modo il repricing diventa margin-aware: il prezzo della concorrenza è importante, ma non è l'unica variabile.
Monitorare i concorrenti
Per prendere decisioni sul prezzo è necessario prima raccogliere informazioni.
Un sistema di competitive pricing monitoring può periodicamente rilevare:
- prezzo del prodotto;
- disponibilità;
- eventuale prezzo promozionale;
- costo di spedizione, quando disponibile;
- variazione rispetto alla rilevazione precedente.
Questo permette di costruire uno storico.
Per ogni SKU possiamo quindi iniziare a conoscere non soltanto il prezzo corrente dei concorrenti, ma anche come quel prezzo cambia nel tempo.
Un concorrente che applica uno sconto temporaneo per tre giorni dovrebbe essere trattato diversamente da un concorrente che mantiene sistematicamente un prezzo inferiore.
Lo storico permette di distinguere questi comportamenti.
Il prezzo più basso non è sempre quello migliore
Essere primi nella classifica dei prezzi può essere importante per alcuni prodotti particolarmente competitivi.
Ma non necessariamente per tutti.
Una strategia più sofisticata può dividere il catalogo in gruppi.
Prodotti civetta
Prodotti molto conosciuti e facilmente confrontabili.
Qui può essere conveniente mantenere un prezzo particolarmente competitivo per attirare traffico e acquisire il cliente.
Prodotti ad alta marginalità
Su questi prodotti può essere più importante proteggere il margine piuttosto che conquistare la prima posizione di prezzo.
Long tail
Prodotti meno confrontati e con minore pressione competitiva.
Abbassarne automaticamente il prezzo potrebbe semplicemente significare rinunciare inutilmente a margine.
Prodotti con stock elevato
In questo caso il repricing può diventare più aggressivo per aumentare la rotazione del magazzino.
Prodotti con stock ridotto
Può essere invece opportuno mantenere o addirittura aumentare il prezzo.
Repricing e disponibilità di magazzino
Il prezzo non dovrebbe essere analizzato separatamente dal magazzino.
Immaginiamo due prodotti.
Prodotto A
Stock: 300
Vendite ultimi 30 giorni: 8
Prodotto B
Stock: 6
Vendite ultimi 30 giorni: 40
Applicare la stessa strategia di repricing avrebbe poco senso.
Sul prodotto A potrebbe essere utile diventare più competitivi.
Sul prodotto B probabilmente non abbiamo alcuna necessità di ridurre il prezzo.
Collegando repricing, vendite e disponibilità si può quindi lavorare contemporaneamente su due KPI:
marginalità e rotazione del magazzino.
Evitare le guerre di prezzo
Un altro problema dei sistemi completamente automatici è l'interazione tra algoritmi differenti.
Immaginiamo due ecommerce.
Farmacia A:
Prezzo concorrente - € 0,10
Farmacia B:
Prezzo concorrente - € 0,10
I due sistemi potrebbero teoricamente continuare ad abbassarsi reciprocamente fino al raggiungimento del rispettivo prezzo minimo.
È il motivo per cui un sistema di repricing dovrebbe prevedere anche:
- frequenza massima degli aggiornamenti;
- variazione minima significativa;
- floor price;
- limiti percentuali giornalieri;
- esclusione di determinati competitor;
- regole differenti per categoria;
- possibilità di approvazione manuale per variazioni importanti.
L'obiettivo non è reagire a qualsiasi variazione del mercato.
È reagire soltanto quando economicamente conveniente.
Repricing automatico o suggerito?
Automatizzare non significa necessariamente lasciare al software il controllo completo.
Una farmacia può scegliere diversi livelli di automazione.
Modalità suggerimento
Il sistema rileva:
Prezzo attuale: € 18,90
Best competitor: € 17,50
Prezzo suggerito: € 17,40
Margine previsto: 27%
L'operatore decide se applicare la modifica.
Modalità automatica
Le modifiche che rispettano determinate regole vengono pubblicate direttamente sull'ecommerce.
Modalità ibrida
Probabilmente la soluzione più interessante.
Le variazioni considerate sicure vengono automatizzate, mentre quelle più importanti richiedono approvazione.
Ad esempio:
variazione < 5% → automatica

variazione >= 5% → approvazione manuale
Dal prezzo al dato commerciale
Il vero valore del repricing emerge quando viene integrato con gli altri dati aziendali.
Gestionale, ecommerce, fornitori e monitoraggio dei concorrenti possono fornire informazioni differenti:
GESTIONALE
   ↓
costo + stock
   ↓
ECOMMERCE
   ↓
prezzo + vendite
   ↓
COMPETITOR MONITORING
   ↓
prezzi di mercato
   ↓
PRICING ENGINE
   ↓
regole + marginalità
   ↓
NUOVO PREZZO
A quel punto il repricing non è più semplicemente una funzione dell'ecommerce.
Diventa parte del processo decisionale commerciale.
Il ruolo di Galenis
Galenis nasce per collegare i diversi sistemi coinvolti nella gestione di una farmacia online: gestionale, ecommerce, fornitori e canali commerciali.
All'interno di questa architettura, il repricing può utilizzare dati provenienti da più fonti:
- costo e disponibilità dal gestionale;
- prezzi dall'ecommerce;
- informazioni sui concorrenti;
- regole commerciali configurate dalla farmacia;
- storico delle vendite;
- dati relativi agli approvvigionamenti.
L'obiettivo non è semplicemente:
"vendere a meno dei concorrenti".
È costruire un sistema nel quale ogni variazione di prezzo risponde a una regola commerciale misurabile.
Conclusioni
Nel commercio online il prezzo rimane una leva fondamentale, soprattutto in mercati altamente confrontabili come quello farmaceutico.
Ma competere sul prezzo non significa necessariamente essere i più economici.
Un sistema di repricing efficace deve conoscere contemporaneamente:
quanto costa il prodotto, quanto margine vogliamo mantenere, quanto stock abbiamo, quanto velocemente vendiamo e cosa stanno facendo i concorrenti.
Solo mettendo insieme queste informazioni è possibile trasformare il repricing da una semplice corsa al ribasso in uno strumento per migliorare vendite, rotazione e marginalità.
Per una farmacia con migliaia di prodotti, questo significa passare dalla gestione manuale dei prezzi a una vera strategia di Pricing Intelligence.
Vuoi valutare il repricing sul tuo ecommerce?
Devlogica sta sviluppando in Galenis strumenti per automatizzare e coordinare i processi delle farmacie online, dal gestionale all'ecommerce, fino al monitoraggio commerciale e alle politiche di prezzo.
Possiamo analizzare il catalogo, le fonti dati disponibili e le regole commerciali della farmacia per individuare quali processi di pricing possono essere automatizzati senza perdere il controllo sulla marginalità.
Contattaci per una demo gratuita!
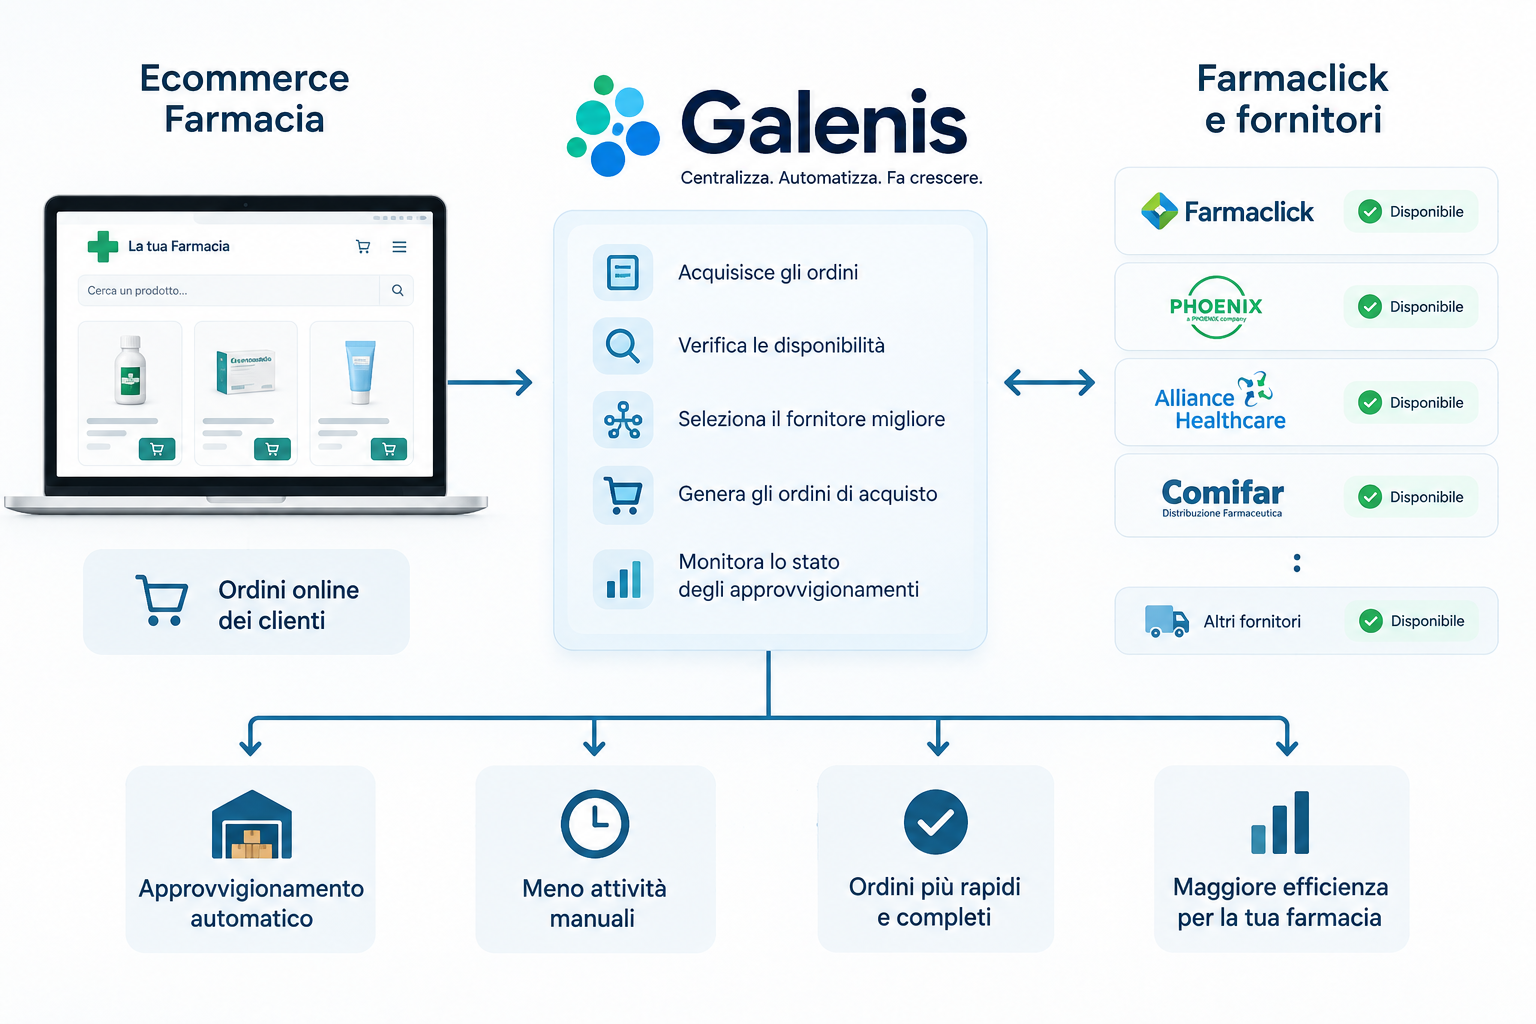
Come automatizzare gli acquisti dai fornitori in una farmacia online
Gestire un ecommerce farmaceutico significa lavorare con cataloghi molto ampi, disponibilità che cambiano rapidamente e prodotti distribuiti da fornitori differenti.
Quando gli ordini online aumentano, una delle attività che può assorbire più tempo è proprio l'approvvigionamento dei prodotti non disponibili a magazzino.
L'operatore deve verificare quali articoli devono essere acquistati, controllare la disponibilità presso i fornitori, confrontare eventualmente prezzi e condizioni e infine effettuare l'ordine.
Per pochi ordini al giorno questo processo può essere gestibile manualmente. Con l'aumento dei volumi, però, diventa facilmente un collo di bottiglia.
L'automazione degli acquisti permette di trasformare questo processo in un flusso strutturato:
ordine ecommerce → verifica disponibilità → scelta del fornitore → proposta/ordine di acquisto → aggiornamento dello stato dell'ordine.
Vediamo come può essere realizzato.
Il problema dell'approvvigionamento in una farmacia ecommerce
Un ecommerce tradizionale tende a vendere principalmente prodotti già presenti nel proprio magazzino.
Nel settore farmaceutico la situazione può essere differente.
Una farmacia può gestire migliaia o decine di migliaia di referenze e affidarsi a diversi distributori per garantire una maggiore disponibilità del catalogo.
Quando arriva un ordine ecommerce possono quindi verificarsi situazioni differenti:
- prodotto disponibile in farmacia;
- prodotto disponibile solo parzialmente;
- prodotto da acquistare presso un distributore;
- prodotto disponibile presso più fornitori;
- prodotto temporaneamente non disponibile;
- ordine contenente articoli provenienti da fonti differenti.
Gestire manualmente tutte queste casistiche richiede tempo e aumenta il numero di operazioni necessarie per completare un ordine.
Il problema non riguarda quindi soltanto sapere se un prodotto è disponibile, ma decidere come approvvigionarlo nel modo più efficiente.
Dal controllo manuale all'approvvigionamento automatico
Un sistema di automazione può analizzare gli articoli richiesti dagli ordini ecommerce e determinare quali devono essere acquistati.
Il flusso può essere schematizzato in questo modo:
- il cliente effettua un ordine sull'ecommerce;
- il sistema acquisisce l'ordine;
- viene verificata la disponibilità dei singoli articoli;
- vengono individuati i prodotti da approvvigionare;
- viene interrogata la disponibilità presso i fornitori configurati;
- vengono applicate le regole di acquisto della farmacia;
- viene generata una proposta oppure un ordine al fornitore;
- lo stato dell'approvvigionamento viene monitorato all'interno dello stesso flusso operativo.
In questo modo l'operatore non deve più ricostruire manualmente la situazione partendo dai singoli ordini ricevuti.
Integrare Farmaclick e i fornitori
Uno degli elementi centrali dell'automazione è la possibilità di integrare servizi e sistemi utilizzati dalla farmacia per interagire con i propri distributori.
Ad esempio, un'integrazione con Farmaclick può permettere di inserire la gestione dell'approvvigionamento all'interno di un processo automatizzato, insieme agli altri fornitori e alle altre fonti dati utilizzate dalla farmacia.
L'obiettivo non è semplicemente effettuare una chiamata verso un fornitore.
Il valore nasce dal collegare questa informazione al resto del ciclo dell'ordine ecommerce.
Il sistema deve sapere:
cosa è stato venduto, cosa è disponibile internamente, cosa deve essere acquistato e da quale fornitore conviene approvvigionarlo.
È questa orchestrazione a trasformare una semplice integrazione in un vero processo di automazione.
Scegliere automaticamente il fornitore
Quando uno stesso prodotto è disponibile presso più distributori, la scelta può essere effettuata utilizzando regole configurabili.
Il prezzo può essere uno dei parametri, ma non necessariamente l'unico.
La farmacia potrebbe considerare:
- disponibilità del prodotto;
- prezzo di acquisto;
- priorità assegnata al fornitore;
- condizioni commerciali;
- quantità minima;
- tempi di consegna;
- soglie d'ordine;
- specifiche regole definite dalla farmacia.
Un sistema più evoluto può quindi determinare automaticamente il fornitore più appropriato per ogni articolo.
Questo permette di passare da:
"Dove posso acquistare questo prodotto?"
a:
"Qual è il fornitore migliore per questo prodotto secondo le mie regole?"
Ordine automatico o proposta di acquisto?
Automatizzare non significa necessariamente eliminare il controllo umano.
Sono possibili diversi livelli di automazione.
Proposta di acquisto
Il sistema individua i prodotti necessari, seleziona i fornitori e prepara una proposta.
L'operatore controlla e conferma l'ordine.
È spesso il punto di partenza migliore per una farmacia che vuole introdurre gradualmente l'automazione.
Ordine semi-automatico
Il sistema prepara gli ordini per i diversi fornitori applicando le regole configurate.
L'operatore interviene soltanto in presenza di anomalie o condizioni particolari.
Ordine automatico
Per prodotti, fornitori e condizioni precedentemente autorizzati, l'ordine può essere generato senza intervento manuale.
Le eccezioni vengono invece sottoposte all'operatore.
L'obiettivo dovrebbe quindi essere automatizzare le situazioni prevedibili e portare all'attenzione dell'operatore soltanto le eccezioni.
Gestire un ordine ecommerce con più fornitori
Un'altra complessità tipica riguarda gli ordini contenenti numerosi articoli.
Immaginiamo un ordine con dieci prodotti:
- sei sono disponibili in farmacia;
- due sono disponibili presso il fornitore A;
- uno è più conveniente presso il fornitore B;
- uno non è disponibile.
Senza un sistema centralizzato, l'operatore deve ricostruire manualmente questa situazione.
Con un sistema di orchestrazione degli acquisti, invece, l'ordine ecommerce rimane l'elemento centrale.
Il sistema può associare a ciascun articolo la relativa fonte di approvvigionamento e mantenere una visione complessiva dello stato dell'ordine.
Questo è particolarmente importante quando i volumi aumentano.
Perché non basta integrare il gestionale con l'ecommerce
Collegare il gestionale della farmacia all'ecommerce è fondamentale, ma non risolve necessariamente l'intero problema.
Il gestionale può rappresentare la fonte principale per anagrafiche, giacenze e processi amministrativi.
L'ecommerce gestisce invece catalogo online, carrello e vendita.
Tra questi sistemi esiste però un livello operativo che deve coordinare:
gestionale → ecommerce → ordini → fornitori → marketplace → comparatori → promozioni.
È qui che un middleware specializzato può diventare utile.
Invece di implementare collegamenti indipendenti tra ogni sistema, è possibile centralizzare le regole e i flussi di integrazione.
Automatizzare gli acquisti con Galenis
Galenis nasce per collegare il gestionale della farmacia con ecommerce, fornitori e canali digitali, mantenendo centralizzati i processi necessari alla gestione della vendita online.
Il modulo Acquisti fornitori permette di inserire l'approvvigionamento all'interno del ciclo dell'ordine gestito dalla piattaforma.
L'obiettivo è ridurre le operazioni manuali necessarie per individuare i prodotti da acquistare e coordinare l'interazione con i fornitori configurati.
Galenis non sostituisce il gestionale della farmacia.
Agisce invece come middleware di orchestrazione, collegando i sistemi esistenti e automatizzando i flussi necessari all'ecommerce.
Un esempio di flusso automatizzato
Consideriamo una farmacia che riceve 100 ordini ecommerce al giorno.
Invece di controllare singolarmente ogni ordine, il processo può diventare:
Ecommerce
↓
Galenis acquisisce gli ordini
↓
Verifica disponibilità
↓
Identifica gli articoli da acquistare
↓
Interroga i fornitori
↓
Applica le regole di approvvigionamento
↓
Genera le proposte/ordini di acquisto
↓
Segnala solamente le eccezioni
L'operatore passa quindi dalla gestione manuale di ogni singola operazione alla supervisione del processo.
I vantaggi per una farmacia online
Automatizzare gli acquisti può portare benefici soprattutto quando aumenta il numero di ordini gestiti quotidianamente.
Tra i principali:
- riduzione delle attività manuali;
- maggiore velocità nella gestione degli ordini;
- minore rischio di errori operativi;
- confronto strutturato tra i fornitori;
- applicazione uniforme delle regole di acquisto;
- migliore controllo degli articoli non disponibili;
- maggiore scalabilità dell'ecommerce.
Il vantaggio più importante è però organizzativo.
La crescita degli ordini non deve necessariamente comportare una crescita proporzionale del lavoro amministrativo necessario per gestirli.
Quando conviene automatizzare gli acquisti?
Non esiste una soglia valida per tutte le farmacie.
Se vengono gestiti pochi ordini ecommerce e quasi tutti i prodotti sono già disponibili internamente, il processo manuale può essere sufficiente.
L'automazione diventa invece particolarmente interessante quando:
- aumenta il numero di ordini giornalieri;
- una parte significativa dei prodotti deve essere approvvigionata;
- vengono utilizzati più fornitori;
- gli operatori dedicano molto tempo alla verifica delle disponibilità;
- vengono effettuati frequentemente ordini manuali ai distributori;
- diventa difficile capire rapidamente quali articoli stanno bloccando gli ordini ecommerce.
In questi casi il problema non è più semplicemente tecnico.
Diventa un problema di scalabilità del processo operativo.
Vuoi capire quanto puoi automatizzare?
Ogni farmacia utilizza gestionali, fornitori e procedure differenti.
Per questo prima di introdurre un'automazione è utile analizzare il flusso attuale:
ordine ecommerce → disponibilità → approvvigionamento → preparazione → spedizione.
Possiamo analizzare insieme il processo utilizzato dalla tua farmacia e individuare quali passaggi possono essere gestiti automaticamente attraverso Galenis, mantenendo i sistemi e i fornitori che utilizzi già.
Richiedi una demo di Galenis o un'analisi del tuo attuale processo di approvvigionamento.
FAQ
È necessario sostituire il gestionale della farmacia?
No. Galenis è progettato per integrarsi con i sistemi esistenti e non nasce come sostituto del gestionale.
È possibile utilizzare più fornitori?
Sì. Il processo di approvvigionamento può essere progettato per lavorare con più fornitori e applicare regole differenti nella selezione.
L'ordine al fornitore deve essere completamente automatico?
No. È possibile prevedere un processo con conferma dell'operatore oppure automatizzare soltanto determinate casistiche.
È possibile integrare Farmaclick?
L'integrazione dipende dai servizi e dalle modalità di accesso disponibili per la farmacia e deve essere verificata in fase di configurazione del progetto.
Galenis funziona solo con Magento?
No. Galenis è un middleware e l'integrazione con l'ecommerce viene gestita attraverso i connettori e le API disponibili. La compatibilità con lo specifico progetto viene verificata in fase di analisi.
È possibile sviluppare integrazioni specifiche?
Sì. Quando un gestionale, un fornitore o un processo non è coperto dalle integrazioni standard, è possibile valutarne l'integrazione tramite API o attraverso attività di Developer Support.